Blog
Systèmes de deep learning : brief technique pour ingénieurs et agents
Apprentissage de représentations, voies discriminatives vs génératives, métriques et arbitrage acheter/construire — concepts AWS réécrits pour les équipes de production
Sur cette page
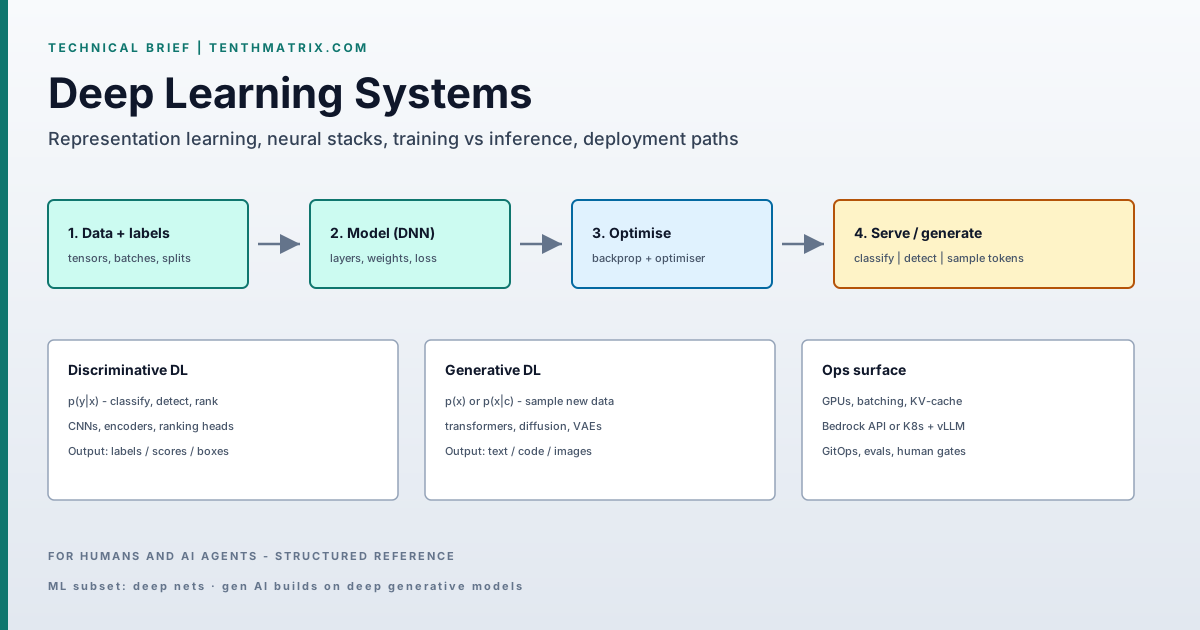
Digest technique : le deep learning comme optimisation neuronale multi-couches, voies discriminatives vs génératives, et comment router le travail vers le ML classique, le DL entraîné ou les API de modèles de fondation. Équations complètes, figures et checklist agent dans le long article.
Adapté d’AWS — What is Deep Learning? — pour les équipes d’ingénierie TenthMatrix.
Répartition des capacités
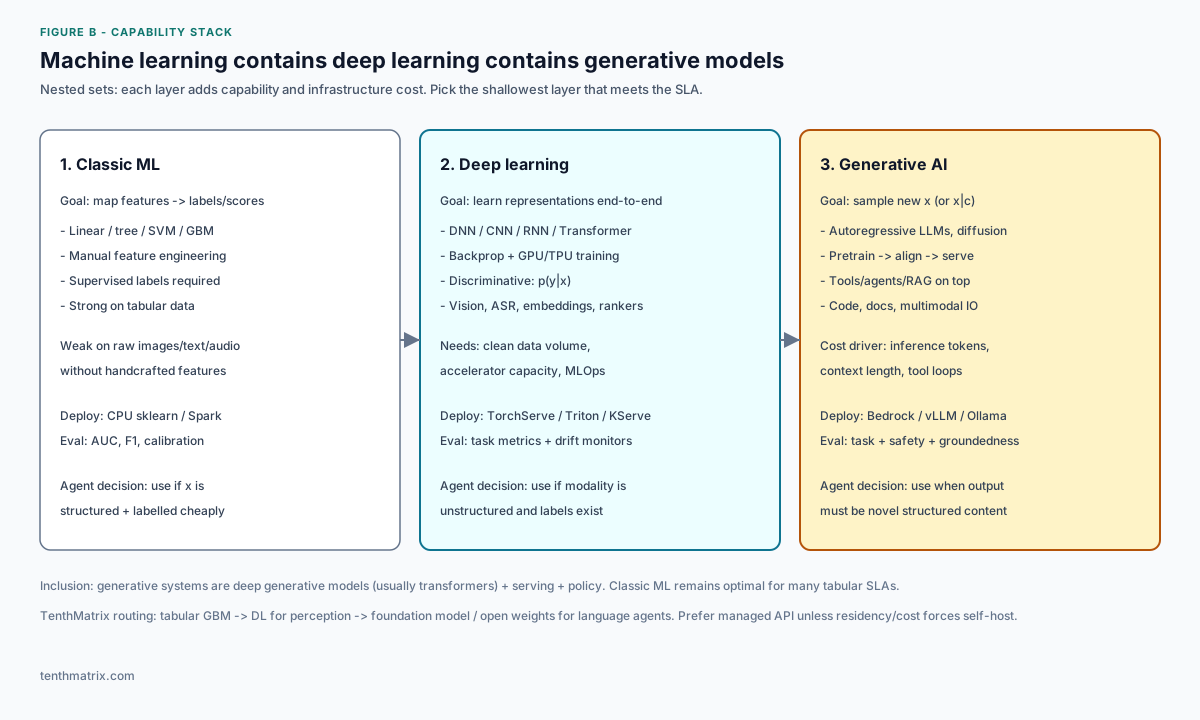
- Classic ML — features conçues ; arbres/modèles linéaires ; meilleur défaut pour les SLA tabulaires denses.
- Deep learning — réseaux de bout en bout sur images/texte/audio ; backprop + GPUs ; serving via Triton/KServe/SageMaker.
- Generative AI — échantillonner du nouveau contenu ; LLMs/diffusion + RAG/outils ; API Bedrock ou inférence open-weight.
Familles de tâches (les métriques comptent)
| Famille | Objectif / métrique typique |
|---|---|
| Vision | détecter/classifier — mAP, IoU, latence p99 |
| Speech | ASR/TTS — WER, facteur temps réel |
| NLP | classer / générer — F1, exact-match, groundedness |
| Recommend | ranger — NDCG, CTR/CVR |
| Gen AI agents | succès de tâche + sécurité + $/requête |
Contraintes
- Data — bruit de labels et drift dominent ; versionner les datasets.
- Compute — l’entraînement et le décodage LLM sont liés aux accélérateurs.
- Ops — harnais d’éval, drift, coût, rollback GitOps avant large promote.
Recommandation TenthMatrix
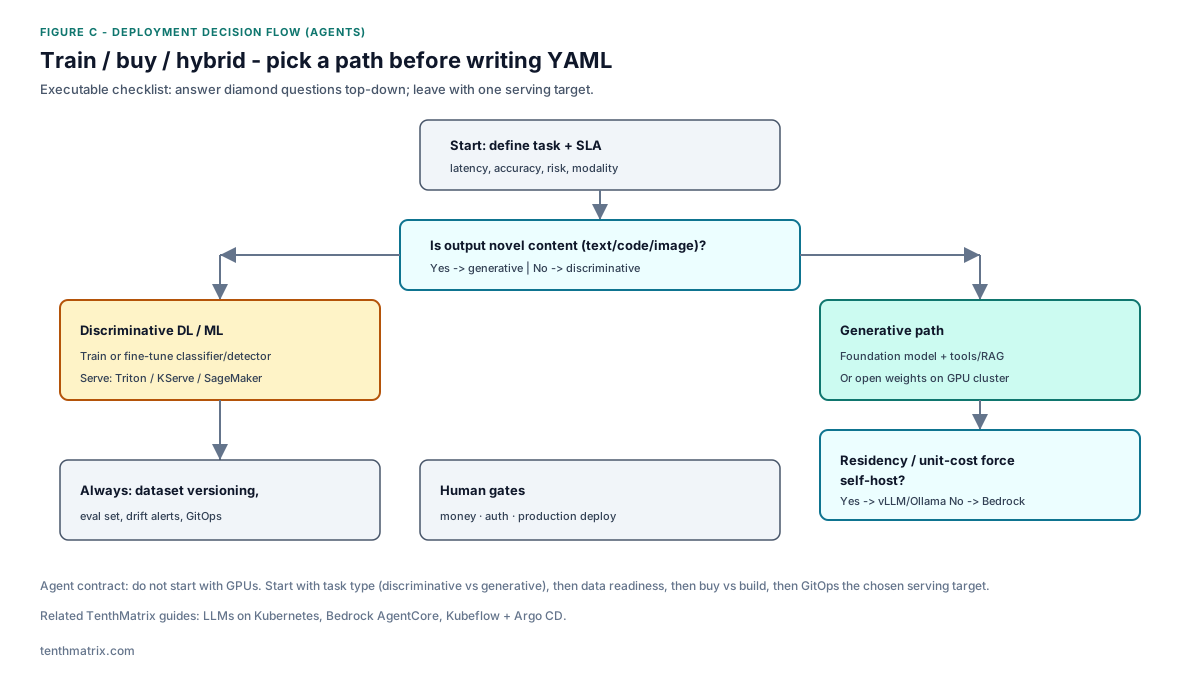
Classer d’abord discriminatif vs génératif. Préférer les modèles de fondation managés pour les agents langage sauf si résidence/coût imposent des poids ouverts. Garder le ML classique pour le tabulaire. Détails, diagramme de couches et checklist : long article. Publié par TenthMatrix.
Plus d'articles du blog

Observability Is Not Optional: Make It a Business Standard
Why fragmented monitoring creates blind spots, duplicate spend, and slow incidents — and how to make centralised observability a non-negotiable company standard.

WSL Vault for Compliance: One Tenant Never Opens Another’s Secrets
How WSL Vault keeps app, team, and environment tenants cryptographically isolated — so a stolen root-style token cannot empty the estate — and why dual-tenant control beats secrets sprawl.

Workstation AI Shop: Promoting the AI Sales Storefront Through int → test → acc → prod
Workstation AI Shop sells GPU machines with a fully autonomous AI Sales Agent that configures the basket. See how Ring Promoter moves each build through int → test → acc → prod — with Orbit screenshots release engineers and stakeholders share.