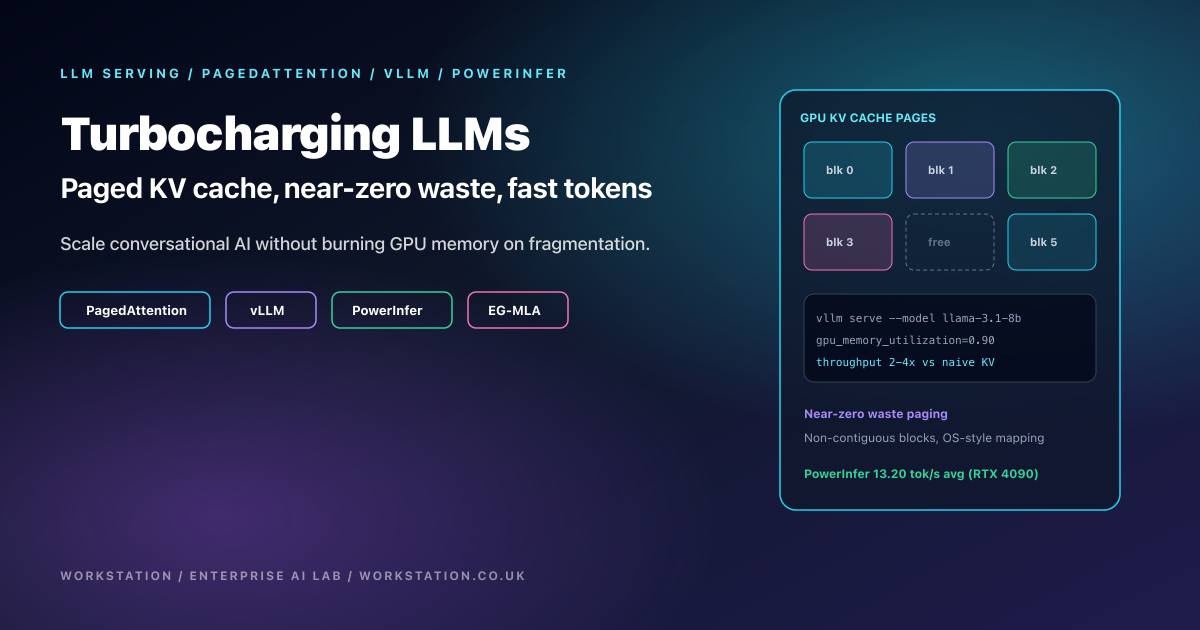
Turbocompresseur LLMs
TenthMatrix sur turbocompresseur LLMs : pagination PagedAttention pour le cache KV, service vLLM, Self-Debugging pour les agents, taux de jetons PowerInfer et réductions de mémoire EG-MLA – avec des compromis de production.
Sujet
Articles avec le tag Machine Learning
TenthMatrix sur turbocompresseur LLMs : pagination PagedAttention pour le cache KV, service vLLM, Self-Debugging pour les agents, taux de jetons PowerInfer et réductions de mémoire EG-MLA – avec des compromis de production.
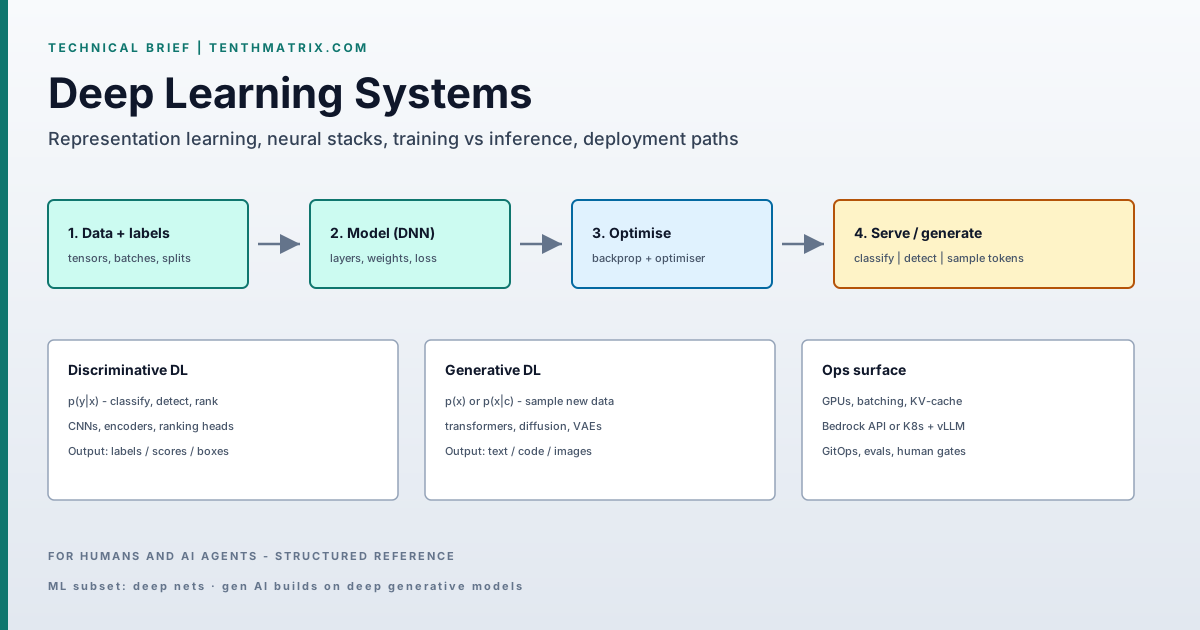
Brief technique TenthMatrix sur le deep learning : réseaux profonds entraînés par gradient, modèles discriminatifs vs génératifs, métriques de tâche, et Bedrock vs serving Kubernetes.
Que sont les grands modèles linguistiques et comment fonctionnent-ils ? Un explicatif clair et non technique pour les gestionnaires et les ingénieurs (jetons, intégrations, transformateurs, formation et inférence) ainsi que le YAML Kubernetes de production pour déployer votre propre LLM avec Ollama et vLLM.