ดีปเลิร์นนิง (DL) คือการเรียนรู้ตัวแทนด้วยเครือข่ายประสาทหลายชั้น: พารามิเตอร์ θ ถูกปรับให้การประกอบของทรานส์ฟอร์มแบบไม่เชิงเส้นแมปอินพุตมิติสูง (พิกเซล โทเคน เวฟฟอร์ม) ไปยังเอาต์พุตของงาน (ป้ายกำกับ กล่อง เอ็มเบดดิง หรือลำดับที่สุ่มตัวอย่าง) บทสรุปทางเทคนิค TenthMatrix นี้เขียนใหม่ภาพรวมแนวคิดของ AWS สำหรับวิศวกรและเอเจนต์ AI ที่ส่งมอบระบบบน Kubernetes, SageMaker และ Bedrock
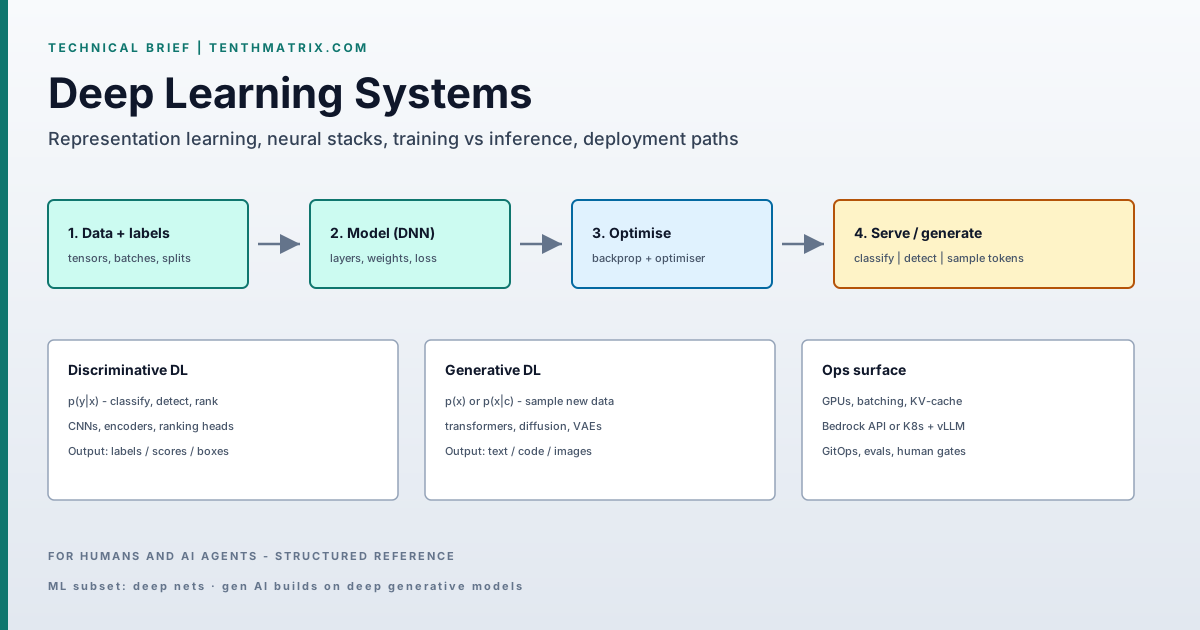
- นิยาม: DL ⊂ ML; ANN หลายชั้นฝึกหลักด้วยการไล่ระดับบนลอสที่หาอนุพันธ์ได้
- แยก: แยกแยะ p(y|x) vs สร้างสรรค์ p(x) หรือ p(x|c)
- Gen AI: มักเป็น transformers ขนาดใหญ่ (หรือดิฟฟิวชัน) + serving + นโยบาย; ไม่ใช่วิทยาศาสตร์แยกจาก DL
- ข้อจำกัดแข็ง: ปริมาณข้อมูลติดป้าย/ทำความสะอาด FLOPs/VRAM ของตัวเร่ง drift/ops
- เส้นทาง: ตาราง → ML คลาสสิก; การรับรู้ → ฝึก/ให้บริการ DL; เอเจนต์ภาษา → API foundation model หรืออินเฟอเรนซ์ open-weight
แหล่งหลัก: AWS — What is Deep Learning? สเปกและชื่อบริการเปลี่ยน; ตรวจสอบเอกสาร AWS ปัจจุบันก่อน provision
1. นิยามอย่างเป็นทางการ
โมเดลลึกเป็นฟังก์ชันพารามิเตอร์ f_θ ประกอบด้วย L ชั้น ชั้น ℓ คำนวณ h^(ℓ) = σ(W^(ℓ) h^(ℓ−1) + b^(ℓ)) สำหรับความไม่เชิงเส้น σ (ReLU, GELU, SiLU ฯลฯ) การฝึกค้นหา θ = {W, b, …} เพื่อลดความเสี่ยงเชิงประจักษ์:
θ* = argmin_θ  (1/N) Σ_i  L( f_θ(x_i), y_i )  +  Ω(θ)
# L = CE / MSE / CTC / contrastive / RL objective, depending on task
# Gradients via reverse-mode autodiff (backpropagation); update with SGD/Adam/…
ต่างจากไปป์ไลน์ตื้นที่พึ่งฟีเจอร์ออกแบบมือ เน็ตลึกเรียนรู้ฟีเจอร์แบบลำดับชั้นจากเทนเซอร์ดิบหรือพรีโพรเซสเบา ๆ จึงทำให้ DL ครองวิชัน สปีช และ NLP ขนาดใหญ่: พื้นที่ฟีเจอร์มิติสูงเกินกว่าการออกแบบมือ
2. ดีปเลิร์นนิงแบบแยกแยะ vs สร้างสรรค์
โมเดลแยกแยะประมาณ p(y|x) หรือขอบเขตการตัดสินใจ — ตัวจำแนก ตัวตรวจจับ ตัวจัดอันดับ ตัวฝัง โมเดลสร้างสรรค์ (deep generative) ประมาณ p(x) หรือ p(x|c) และสามารถสุ่มตัวอย่างอินสแตนซ์ใหม่: next-token LLMs โมเดลภาพดิฟฟิวชัน VAEs GANs
Foundation models ในเอเจนต์ผลิตภัณฑ์เป็นระบบสร้างสรรค์ลึกที่ฝึกขนาดใหญ่แล้วจัดแนวและให้บริการ การเรียก Bedrock Converse หรือเอนด์พอยต์ vLLM ที่โฮสต์เองคืออินเฟอเรนซ์บนโมเดลดังกล่าว — ยังคงเป็นดีปเลิร์นนิงด้านล่าง
3. ทำไมระบบโปรดักชันจึงพึ่งพามัน
พื้นผิวที่ดีพลอยแล้วซึ่งฝัง DL (หรือ foundation models ที่รองรับด้วย DL) อยู่แล้ว:
- เอเจนต์สนทนาและการสังเคราะห์โค้ด
- ASR / TTS และ UI เสียง
- การให้คะแนนทุจริต / ความผิดปกติบนลำดับ
- สแต็กการรับรู้ (ADAS, CV อุตสาหกรรม, การถ่ายภาพทางการแพทย์)
- การปรับเฉพาะบุคคลและการจัดอันดับค้นหาด้วยหอคอยลึก
หากรายการโรดแมปคือ «ฟีเจอร์ AI» การใช้งานเกือบเสมอคือโมเดลลึก API foundation-model หรือไฮบริด (RAG + เครื่องมือ) ทับบนหนึ่งในนั้น
4. อนุกรมวิธานงาน (แผนที่การใช้งาน)
4.1 คอมพิวเตอร์วิชัน
CNNs / ViTs แมปเทนเซอร์ภาพไปยังคลาส กล่อง มาสก์ หรือเอ็มเบดดิง รูปแบบโปรดักชัน: กลั่นกรองเนื้อหา จดจำแอตทริบิวต์ ตรวจจับโลโก้/PPE ตรวจตำหนิแบบอินไลน์ เมตริก: mAP, IoU, เลเทนซีที่ batch size 1 บน GPU เป้าหมาย
4.2 สปีช
โมเดลอะคูสติก + โมเดลภาษา (หรือ ASR ปลายทางถึงปลายทาง) ทนสำเนียง SNR และความแปรผันของความเร็วพูด เวิร์กโหลด: ช่วยศูนย์ติดต่อ เขียนตามคำบอกทางคลินิก คำบรรยาย เมตริก: WER, ตัวคูณเรียลไทม์ (RTF)
4.3 NLP
จากตัวจำแนกเอนโค้ดเดอร์ถึง LLMs แบบ decoder-only เวิร์กโหลด: intent/slot สรุป เอกสาร QA จัดทำดัชนีความรู้สึก LLMs ครองข้อความเปิด; เอนโค้ดเดอร์เล็กกว่ายังชนะใน classify/extract ที่จำกัดด้วยเลเทนซี
4.4 ระบบแนะนำ
ตัวจัดอันดับ two-tower / DeepFM / transformer บนลำดับปฏิสัมพันธ์ user–item เอาต์พุต: รายการจัดอันดับพร้อมความหลากหลายและข้อจำกัดธุรกิจ Offline: NDCG/recall; online: CTR/CVR พร้อมการควบคุมการสำรวจ
4.5 แอปพลิเคชันสร้างสรรค์
การสุ่มตัวอย่าง + การใช้เครื่องมือ: RAG บนคลังส่วนตัว ช่วยโค้ด ร่างเอกสาร เวิร์กโฟลว์หลายเอเจนต์ บน AWS: Bedrock FMs หรือน้ำหนักโฮสต์บน SageMaker บนเอสเตท TenthMatrix: พูล GPU Kubernetes (vLLM/Ollama) ภายใต้ GitOps เมื่อถิ่นที่อยู่หรือเศรษฐศาสตร์ต่อหน่วยต้องการ
5. สถาปัตยกรรม: ชั้นและการส่งผ่านไปข้างหน้า
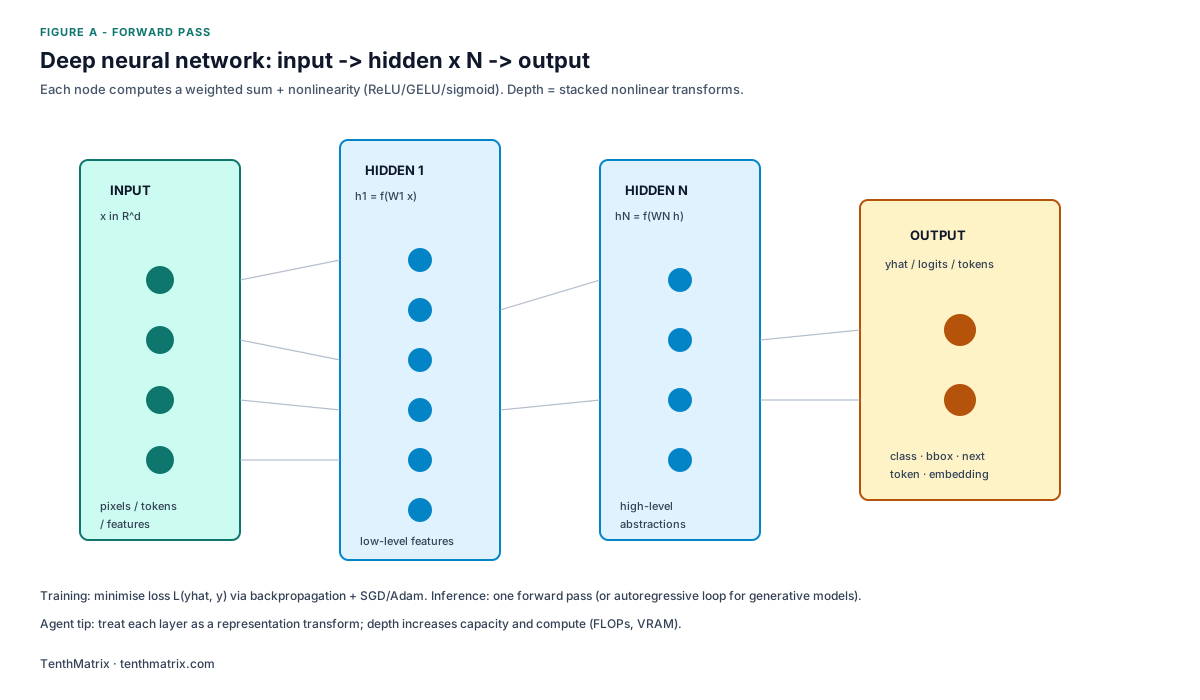
- ชั้นอินพุต — อินเทอร์เฟซเทนเซอร์: พิกเซลที่นอร์มัลไลซ์ รหัสโทเคน เฟรม log-mel หรือเวกเตอร์ตาราง
- ชั้นซ่อน — ทรานส์ฟอร์มตัวแทนต่อเนื่อง ชั้นต้นจับโครงสร้างท้องถิ่น (ขอบ n-grams); ชั้นลึกจับความหมายของงาน ความลึกเพิ่มความสามารถเชิงแสดงออกและการคำนวณ (FLOPs หน่วยความจำแอคทิเวชัน)
- ชั้นเอาต์พุต — หัวงาน: softmax logits การถดถอย bounding-box CTC หรือโปรเจกชัน vocab สำหรับการถอดรหัสแบบออโต้รีเกรสซีฟ
การฝึก = หลาย forward + backward passes อินเฟอเรนซ์ = เฉพาะ forward (บวก KV-cache / speculative decoding สำหรับ LLMs)
6. ML vs DL vs AI สร้างสรรค์
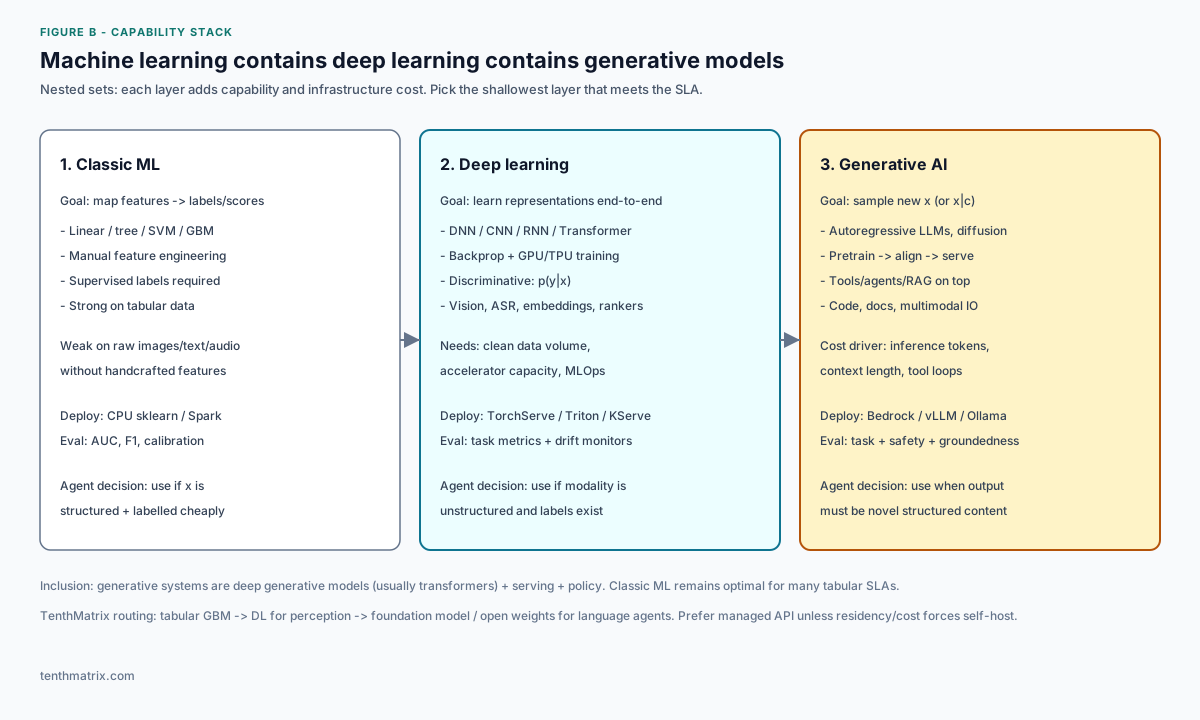
| ชั้น | วัตถุประสงค์ | สแต็กทั่วไป |
|---|---|---|
| ML คลาสสิก | p(y|φ(x)) ด้วย φ ที่ออกแบบ | GBM / เชิงเส้นบนตารางคลัง |
| ดีปเลิร์นนิง | f_θ(x) ปลายทางถึงปลายทางบนโมดัลดิบ | PyTorch + Triton/KServe บนโหนด GPU |
| AI สร้างสรรค์ | สุ่มตัวอย่าง x หรือ x|c; เอเจนต์/เครื่องมือด้านบน | Bedrock Converse หรือ vLLM + RAG |
6.1 ข้อดีของ DL เหนือ ML ตื้น (เมื่อใช้ได้)
- โมดัลไม่มีโครงสร้าง — เอ็มเบดดิงร่วมยุบความแปรผันของการถอดความ («จ่าย» vs «โอนเงิน»)
- การค้นพบฟีเจอร์ — เกรเดียนต์แกะสลักส่วนภายในที่มีประโยชน์โดยไม่มีรายการฟีเจอร์มือ
- ทรานส์เฟอร์ / ไฟน์ทูน — ใช้แบ็กโบนพรีเทรนซ้ำ; ลดข้อมูลติดป้ายเทียบกับการฝึกจากศูนย์
- การสร้างแบบจำลองลำดับ / ชุด — transformers จัดการการพึ่งพาระยะไกลที่ bag-of-features พลาด
DL ไม่เอาชนะ GBM ที่จูนดีบนข้อมูลตารางหนาแน่นที่มีฟีเจอร์แข็งแกร่งโดยอัตโนมัติ เลือกตามโมดัลและระบอบข้อมูล ไม่ใช่ตามแฟชั่น
7. โหมดความล้มเหลวและข้อจำกัด
- คุณภาพข้อมูล — สัญญาณรบกวนป้ายและการเลื่อนการกระจายครองงบข้อผิดพลาด เวอร์ชันชุดข้อมูล; กักกันค่าผิดปกติก่อนเข้าชุดฝึก
- การคำนวณ — การฝึกและอินเฟอเรนซ์แบทช์ใหญ่ถูกจำกัดด้วยตัวเร่ง GPU เล็กเกินไปทำให้เกิดลูปหลายวันและฆ่าความเร็วการวนซ้ำ
- Ops — โดยไม่มีประตู eval จอ drift เทเลเมทรีต้นทุน และการย้อนกลับ (GitOps) โมเดลเน่าในโปรดักชันไม่ว่าไดอะแกรมสถาปัตยกรรมจะเป็นอย่างไร
8. การเร่งคลาวด์ vs โฮสต์เอง
คลาวด์สั้นวงจรทดลอง: พูล GPU/CPU ยืดหยุ่น โน้ตบุ๊ก/ไปป์ไลน์ที่มีการจัดการ และ foundation models เป็น API บล็อกสร้าง AWS:
- Amazon SageMaker — ฝึก จูน โฮสต์อาร์ติแฟกต์ DL แบบกำหนดเอง
- Amazon Bedrock — เรียก foundation models ด้วย IAM, Guardrails และ ZDR ทางเลือก
โฮสต์เองบน Kubernetes เมื่อน้ำหนักเปิด ถิ่นที่อยู่ข้อมูล หรือเศรษฐศาสตร์โทเคนเอื้อ GPU ที่เป็นเจ้าของ รูปแบบ: model registry + KServe/vLLM + ซิงก์ Argo CD
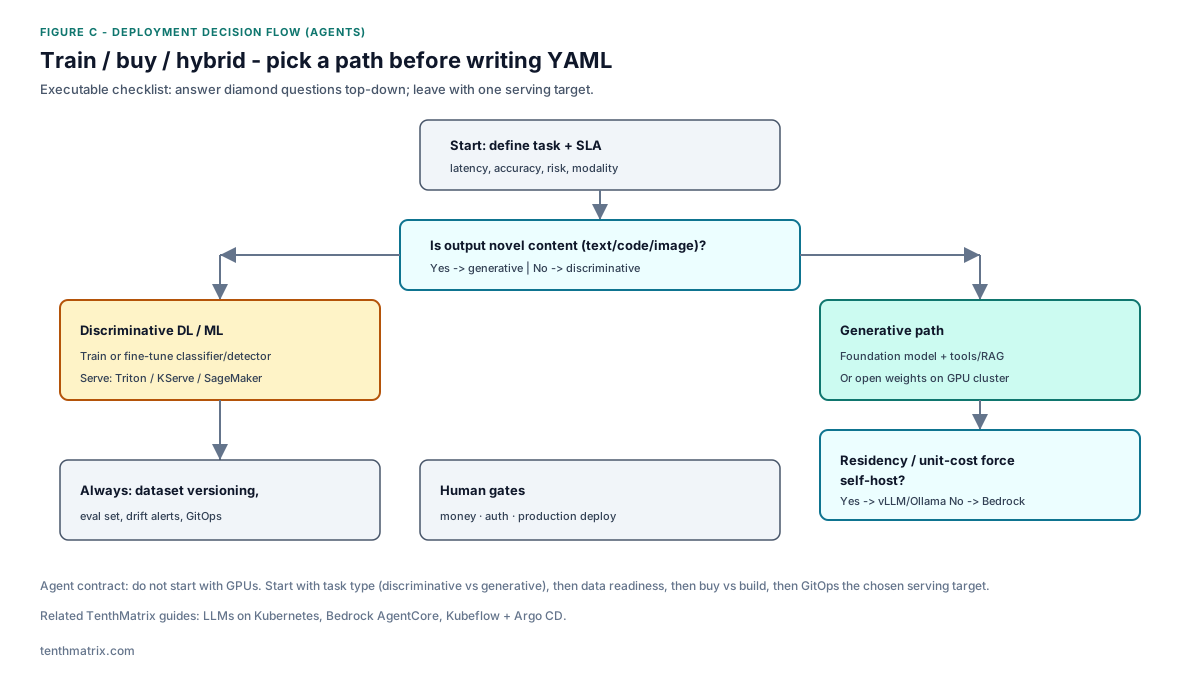
9. เช็กลิสต์การดำเนินการ
- เขียนงานเป็นวัตถุประสงค์ที่วัดได้ (เมตริก + เลเทนซี + ชั้นความเสี่ยง)
- เลือกชั้นสแต็กจากรูป B; อย่ากระโดดไป gen AI สำหรับสกอร์การ์ดตาราง
- กำหนดงบเตรียมข้อมูล + OpEx อินเฟอเรนซ์; การฝึกมักเป็นส่วนน้อยของต้นทุนตลอดอายุ
- ติดตั้ง harness ประเมินก่อนโรลเอาต์กว้าง; ต่อสัญญาณเตือน drift
- อ่านถัดไป: การให้บริการ LLM หรือ เอเจนต์ Bedrock
เผยแพร่โดย TenthMatrix — แพลตฟอร์มอัตโนมัติ ซอฟต์แวร์หลายเอเจนต์ การส่งมอบ Kubernetes


