TenthMatrix บทสรุปทางเทคนิค: วิธีเทอร์โบชาร์จ LLM ให้บริการและตัวแทนด้วย PagedAttention, vLLM, Self-Debugging, PowerInfer, และ EG-MLA. สหาย: บล็อก · ไพรเมอร์: LLMs ในบทความ Kubernetes · ห้องปฏิบัติการ: ห้องปฏิบัติการ AI ขององค์กร.
- คอขวด: การเติบโตและการกระจายตัวของแคช KV ไม่ใช่ "โมเดลช้า" ในนามธรรม
- PagedAttention: การเพจสไตล์ OS ของบล็อก KV; ปรับขนาดบล็อกและลำดับชั้นแคช
- vLLM: ให้บริการเครื่องยนต์ที่มีของเสีย KV ใกล้ศูนย์ + การแบ่งชุดอย่างต่อเนื่อง ดู TTFT เทียบกับโทเค็น/s
- Self-Debugging: การซ่อมแซมโปรแกรมเพียงไม่กี่ช็อตสามารถเอาชนะชุดผู้สมัครจำนวนมาก หมวกกลมในผลิตภัณฑ์
- PowerInfer: แยกร้อน/เย็น; 13.20 tok/s เฉลี่ย / 29.08 จุดสูงสุดบน RTX 4090 (ตัวเลขกระดาษ/repo)
- EG-MLA: การบีบอัด KV ระดับสถาปัตยกรรม (~ 91.6% เทียบกับ MHA); ประเมินใหม่ก่อนสลับ
1. เหตุใดการให้บริการไม่ใช่การฝึกอบรมจึงถือเป็นวิกฤติ
โมเดลภาษาขนาดใหญ่เปลี่ยน NLP: แชท การสร้าง เครื่องมือ การฝึกอบรมมีราคาแพงเพียงครั้งเดียว การให้บริการมีราคาแพงทุกวินาที การถอดรหัสเป็นแบบอัตโนมัติ โทเค็นใหม่แต่ละรายการต้องใช้คีย์และค่าก่อนหน้า หน่วยความจำสำหรับแคช KV นั้นแปรผันตามเลเยอร์ × หัว × ซ่อน × ลำดับ × แบทช์ การกรอกข้อมูลล่วงหน้ามีการประมวลผลอย่างหนัก ถอดรหัสเป็นหน่วยความจำแบนด์วิธหนัก หากคุณจัดสรรเทนเซอร์ KV ที่มีความยาวสูงสุดต่อเนื่องกันต่อคำขอ ส่วนใหญ่จะว่างเปล่าจนกว่าลำดับจะขยายใหญ่ขึ้น — การกระจายตัวภายในแบบคลาสสิก คำขอที่เกิดขึ้นพร้อมกันไม่สามารถขโมยช่องโหว่เหล่านั้นได้ ขนาดแบตช์ลดลง โทเค็นต่อวินาทีลดลง GPU ดูยุ่งและยังคงไม่ได้ใช้งาน
นั่นคือปัญหาที่ PagedAttention และ vLLM โจมตีในปี 2566 และปัญหา PowerInfer และตัวแปรความสนใจรุ่นหลังยังคงโจมตีจากมุมที่ต่างกัน
ชม: โมเดลจิต LLM
วิดีโอบริบท: ข้อมูลเบื้องต้นเกี่ยวกับโมเดลภาษาขนาดใหญ่. ตัวอธิบาย TenthMatrix: LLM ทำงานอย่างไรและใช้งานบน Kubernetes ได้อย่างไร.
2. PagedAttention: การเพจสำหรับแคช KV
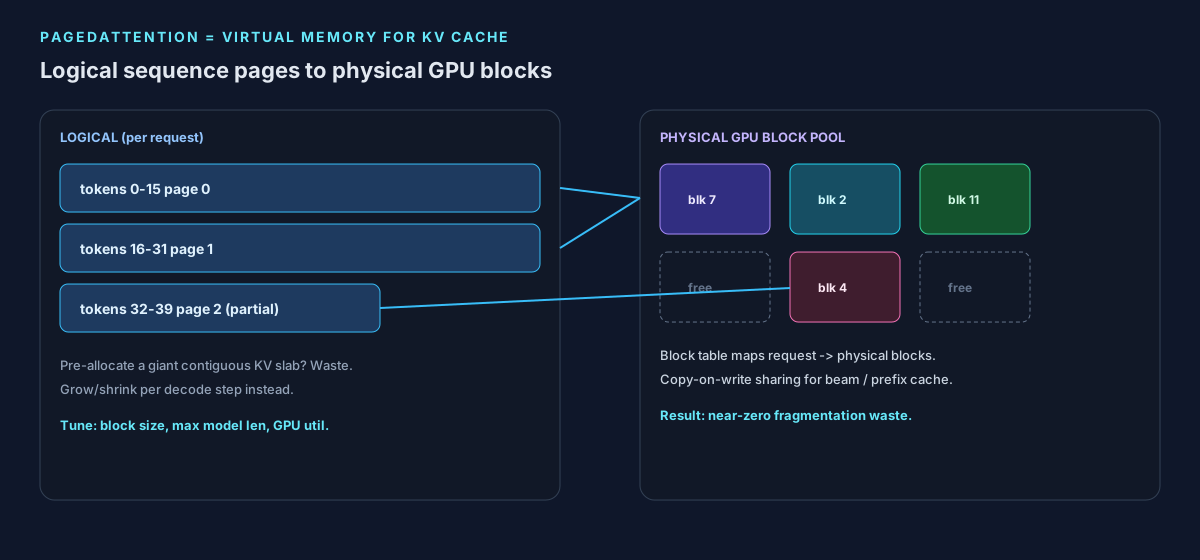
Kwon, Li, Zhuang, Sheng, Zheng, Yu, Gonzalez, Zhang และ Stoica แนะนำ PagedAttention เป็นอัลกอริธึมความสนใจที่ได้รับแรงบันดาลใจจากหน่วยความจำเสมือนและเพจ OS และสร้าง vLLM ไว้ด้านบน [arXiv:2309.06180]. แนวคิด:
- แยก KV ออกเป็น บล็อกขนาดคงที่ (โทเค็นจำนวนเล็กน้อยต่อบล็อก)
- เก็บไว้ บล็อกตาราง จากตำแหน่งโทเค็นแบบลอจิคัลไปจนถึงบล็อก GPU แบบฟิสิคัล (อาจไม่ต่อเนื่องกัน)
- จัดสรร/ว่างบล็อกเมื่อลำดับขยายหรือสิ้นสุด - เหมือนกับการจัดสรรหน้า ไม่ใช่เหมือน malloc ของอาเรย์ขนาดยักษ์ตัวเดียว
- แบ่งปันบล็อก (คัดลอกเมื่อเขียน) สำหรับการใช้คำนำหน้าซ้ำ ค้นหาลำแสง และการสุ่มตัวอย่างแบบขนาน ดังนั้นคุณจึงไม่ทำซ้ำคำนำหน้าที่เหมือนกัน
การนำไปปฏิบัติไม่ใช่ "การปักธงบน BERT" เคอร์เนลความสนใจต้องรวบรวมบล็อกที่กระจัดกระจาย ผู้จัดกำหนดการจะต้องทราบว่าบล็อกใดว่าง ลำดับชั้นของแคชมีความสำคัญ: บล็อกที่มีถิ่นที่อยู่ HBM เทียบกับออฟโหลด CPU เทียบกับเพียร์ NVLink ขนาดบัฟเฟอร์ (บล็อก) เป็นลูกบิดจริง เล็กเกินไป: มีการค้นหาตารางและโอเวอร์เฮดเคอร์เนลเพิ่มขึ้น ใหญ่เกินไป: เสียช่องภายในบล็อกบางส่วนสุดท้าย จับคู่ขนาดบล็อกด้วย max_model_len และการผสมผสานระหว่างพรอมต์/การเสร็จสิ้นที่แท้จริงของการเข้าชมของคุณ
ฝึกฝน: การกระจายตัวของโปรไฟล์ (ไบต์ KV ที่ไม่ได้ใช้ / ไบต์ KV ที่สงวนไว้) และโทเค็น/วินาทีร่วมกัน กราฟหน่วยความจำที่ไม่มีปริมาณงานถือเป็นความไร้สาระ
3. vLLM: ระบบให้บริการรอบเพจเจอร์
คำกล่าวอ้างของ vLLM คือการเสียเปล่าเกือบเป็นศูนย์ในหน่วยความจำแคช KV พร้อมการแบ่งปันที่ยืดหยุ่นภายในและระหว่างคำขอ การประเมินในกระดาษแสดงให้เห็นคร่าวๆ ปริมาณงาน 2–4 × เมื่อเทียบกับระบบ SOTA ในขณะนั้น (FasterTransformer, Orca) ในเวลาแฝงที่ใกล้เคียงกัน โดยได้รับผลประโยชน์มากขึ้นจากลำดับที่ยาวและการถอดรหัสที่แปลกใหม่ยิ่งขึ้น ในปัจจุบัน เครื่องยนต์ยังจัดส่งชุดต่อเนื่อง การเติมล่วงหน้าเป็นก้อน การแคชคำนำหน้า และเทนเซอร์/ไปป์ไลน์แบบขนานสำหรับ multi-GPU
รายการตรวจสอบการปฏิบัติงาน:
- ชุด
gpu_memory_utilizationสูงพอที่จะรับน้ำหนัก + KV ต่ำพอที่จะออกจากพื้นที่ทำงาน CUDA - เปิดใช้งานการแคชคำนำหน้าเฉพาะหลังจากที่คุณยืนยันคะแนนประเมินและเปิด p95 TTFT เท่านั้น ของคุณ แจ้ง
- แยกพูลที่กรอกข้อมูลล่วงหน้าหนักและถอดรหัสหนัก หากการรับส่งข้อมูลแบบผสมทำลาย SLO (การแสดงผลแบบแยกส่วน)
- เปิดเผยตำแหน่งข้อมูลที่รองรับ OpenAI ด้านหลังเกตเวย์ของคุณ (คุณสมบัติ TenthMatrix มักจะทิ้งสิ่งนี้ไว้เบื้องหลัง เกตเวย์ WSL Proxy / API รูปแบบ)
from vllm import LLM, SamplingParams

llm = LLM(
    model="meta-llama/Llama-3.1-8B-Instruct",
    gpu_memory_utilization=0.90,
    max_model_len=8192,
    enable_prefix_caching=True,
)
params = SamplingParams(temperature=0.2, max_tokens=256)
outs = llm.generate(["Summarise PagedAttention for a platform engineer."], params)
print(outs[0].outputs[0].text)
ต่อต้านรูปแบบ (นี่คือ ไม่ PagedAttention):
# Classifier forward pass — logits, not paged KV serving
import torch
from transformers import AutoModelForSequenceClassification
model = AutoModelForSequenceClassification.from_pretrained("bert-base-uncased")
out = model(torch.tensor([[1, 2, 3]]), attention_mask=torch.tensor([[1, 1, 1]]))
print(out.logits)
ชม: ระบบการให้บริการในป่า
การพูดคุยที่ให้บริการตามบริบท การเขียน Canonical: บล็อก vLLM (PagedAttention) · เครื่องยนต์: vllm-โครงการ/vllm.
4. Self-Debugging: คุณภาพต่อผู้สมัครมากขึ้น ไม่ใช่ผู้สมัครมากขึ้น
เฉิน หลิน ไคลน์ และคณะ แสดงให้เห็นว่าการสอน LLM เพื่อดีบักโปรแกรมที่คาดการณ์ไว้ด้วยการสาธิตแบบไม่กี่ช็อต สามารถจับคู่หรือเอาชนะเส้นพื้นฐานที่สร้างผู้สมัครได้มากกว่า 10 เท่า [arXiv:2304.05128]. การวนซ้ำคือ: สร้าง → ดำเนินการหรือทดสอบหน่วย → ติดตามฟีดกลับ → ซ่อมแซม
ข้อดีข้อเสียของการผลิต: ข้อความตอบรับแต่ละข้อความเป็นการกรอกข้อมูลล่วงหน้าและถอดรหัสอื่น (หรือบริบทแบบยาวต่อท้าย) ความแม่นยำมักจะเพิ่มขึ้นเมื่อมีรอบมากขึ้น เวลาแฝงและต้นทุนก็เช่นกัน คำแนะนำ TenthMatrix สำหรับตัวแทน (ดูเพิ่มเติมที่ Muse Glimmer / ตัวแทนท้องถิ่น):
- ฮาร์ดแคปในรอบการแก้ไขข้อบกพร่อง (เช่น 2–4) ต่อการเรียกใช้เครื่องมือ
- โทเค็นงบประมาณแยกจากการแชทที่ผู้ใช้มองเห็น
- ยกระดับไปสู่โมเดลมนุษย์หรือผู้เชี่ยวชาญ แทนที่จะลองซ้ำอย่างไม่มีที่สิ้นสุด
- การติดตามบันทึกสำหรับ eval — Self-Debugging ที่ไม่มีการวัดและส่งข้อมูลทางไกลถือเป็นนิทานพื้นบ้าน
5. PowerInfer: การสร้างโทเค็นที่คำนึงถึงท้องถิ่น
PowerInfer (SJTU IPADS / repos ที่เกี่ยวข้อง) เป็นระบบสร้างโทเค็นที่ใช้ประโยชน์จากพื้นที่ในการเปิดใช้งาน: เซลล์ประสาท "ร้อน" ขนาดเล็กที่ตั้งค่าบน GPU, น้ำหนักที่เย็นกว่าที่สตรีมหรือดำเนินการบน CPU จุดปฏิบัติการที่เผยแพร่ ได้แก่ เฉลี่ย 13.20 โทเค็น/วินาที และ จุดสูงสุดของโทเค็น 29.08/วินาที บน NVIDIA RTX 4090 เดียวและสูงสุด 11.69× เทียบกับ llama.cpp ด้วยความแม่นยำที่คงไว้ [PowerInfer GitHub]. (ส้อมที่หันเข้าหาผู้ใช้ เช่น Tiiny-AI/PowerInfer ติดตามสายงานเดียวกัน)
การขยายขนาดเป็นส่วนที่ยาก โปรไฟล์ท้องถิ่น 4090 เดียวจะไม่กลายเป็นการปรับใช้ Kubernetes ที่มีประสิทธิภาพโดยอัตโนมัติ คุณต้องการ:
- คำขอ/ขีดจำกัด GPU ที่ซื่อสัตย์ และการปักหมุด CPU ที่รับรู้โดย NUMA หากผู้เชี่ยวชาญ CPU ทำงาน
- แผนแบบกระจายหากโมเดลไม่เหมาะกับอีกต่อไป: เทนเซอร์แบบขนานเทียบกับไปป์ไลน์และแบบขนานของผู้เชี่ยวชาญ
- การแยก SLO: การแชทแบบโต้ตอบเทียบกับการเสร็จสิ้นแบทช์เทียบกับลูปเครื่องมือของตัวแทน
ใช้ PowerInfer (หรือ llama.cpp หรือ MLX) บนเวิร์กสเตชันและ Edge Box ใช้ vLLM (หรือ TensorRT-LLM หรือ SGLang) เมื่อคุณเติม GPU ของศูนย์ข้อมูลด้วยการรับส่งข้อมูลสไตล์ OpenAI ที่เกิดขึ้นพร้อมกัน วัดทั้งสอง. ของเรา ห้องปฏิบัติการ AI ขององค์กร ท่าทางเหมือนกับ Polyglot Benchmarks: หลักฐาน แล้วก็ ADR
6. EG-MLA: บีบอัดความสนใจไปที่สถาปัตยกรรม
การแสดงลูกเล่นไม่สามารถแก้ไขโมเดลที่มี KV มีขนาดใหญ่มากได้ รายงาน EG-MLA (ความสนใจแฝงแบบหลายหัวแบบฝังที่มีรั้วรอบขอบชิด) ลดขนาดแคช KV มากกว่า 91.6% เมื่อเทียบกับความสนใจแบบหลายหัว (MHA) ที่มีการลดลงเล็กน้อย การประหยัดเพิ่มเติมเมื่อเทียบกับ MLA (สูงถึง 59.9%) และปรับปรุงความแม่นยำของเกณฑ์มาตรฐานการให้เหตุผล ผู้เขียนโต้แย้งว่าการฝัง gating ทำให้เกิดการโต้ตอบที่มีลำดับสูงโดยนัย และแสดงการปรับขนาดพารามิเตอร์ 1B ที่ผ่านมา [EG-MLA, arXiv].
ความหมายทางวิศวกรรม: นี่คือก การฝึกอบรม / สถาปัตยกรรม การตัดสินใจ. คุณไม่สามารถพลิก EG-MLA บน vLLM แบบสุ่มทุกคืนของ Llama-3 และคาดหวังเปอร์เซ็นต์ของกระดาษ หากคุณควบคุมการฝึกล่วงหน้าหรือการฝึกล่วงหน้าอย่างต่อเนื่อง EG-MLA เป็นตัวเลือกที่จะตัด HBM ก่อนที่คุณจะซื้อ GPU อีก หากคุณให้บริการเฉพาะน้ำหนักสาธารณะ ให้คงใช้ PagedAttention + การหาปริมาณ + MLA รุ่นต่างๆ ที่เครื่องยนต์รองรับอยู่แล้ว และติดตามจุดตรวจสอบ EG-MLA ขณะที่ลงจอด
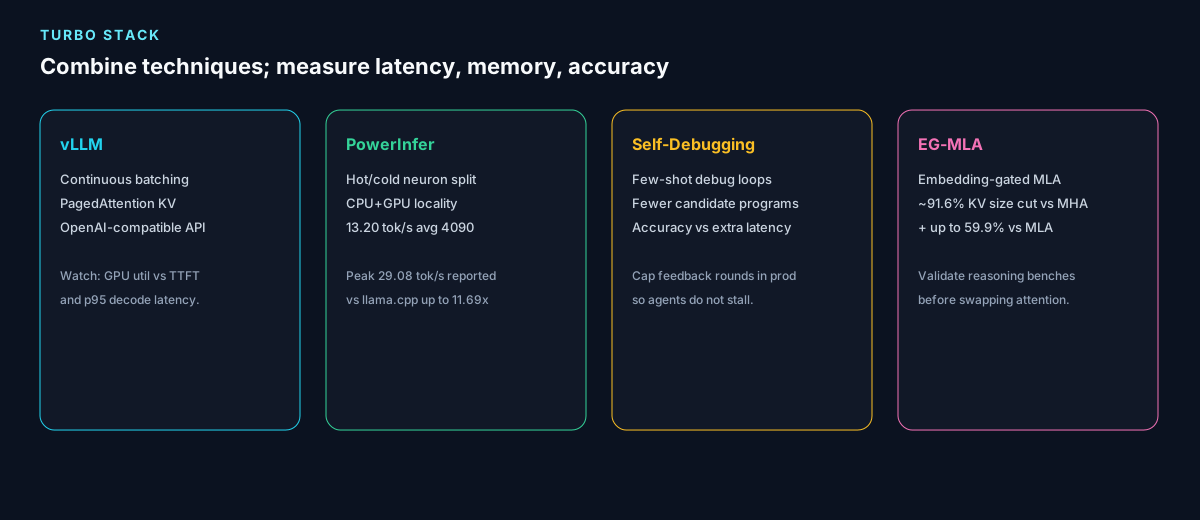
7. รวมปล่องโดยไม่ต้องบรรทุกสินค้า
| ชั้น | ใช้เมื่อ | ระวัง |
|---|---|---|
| PagedAttention / vLLM | การให้บริการ API พร้อมกัน บริบทแบบยาว คำนำหน้าที่ใช้ร่วมกัน | คำนำหน้าแคชเทียบกับความถูกต้อง OOM ใช้ประโยชน์ได้สูง |
| PowerInfer | อัตราโทเค็น GPU ไขมันเดี่ยว / เวิร์กสเตชัน | ท้องถิ่นไม่ตรงกัน; การขยายขนาดที่ยุ่งเหยิง |
| Self-Debugging | โค้ด/เอเจนต์ลูปที่สามารถดำเนินการทดสอบได้ | รอบไม่จำกัด; ต้นทุนการเติมล่วงหน้าเพิ่มเติม |
| EG-MLA | คุณฝึกหรือปรับแต่งกระดูกสันหลัง | ไม่ใช่ธงเสิร์ฟ ดำเนินการประเมินผลเต็มรูปแบบอีกครั้ง |
8. ความสามารถในการปรับขนาดบน Kubernetes
สถาปัตยกรรมแบบกระจายที่ได้รับการออกแบบมาอย่างดีจะเพิ่มปริมาณงาน และยังเพิ่มโหมดความล้มเหลวอีกด้วย: stragglers, การถ่ายโอนแคช KV, tokenizer skew และตัวปรับขนาดอัตโนมัติที่ทำลาย warm prefix รูปแบบการปฏิบัติ (สอดคล้องกับของเรา Ollama / vLLM บน Kubernetes การเขียน):
- โหนดพูล GPU เฉพาะ; อย่าแพ็คพ็อดถอดรหัสด้วยงาน CPU แบบสุ่ม
- แยกการกรอกข้อมูลล่วงหน้าและถอดรหัสหาก TTFT SLO และโทเค็น/SLO ต่อสู้กัน
- HPA เกี่ยวกับความลึกของคิวหรือการครอบครอง GPU KV ไม่ใช่แค่ CPU
- ส่งเสริมการแสดงกองซ้อนผ่านวงแหวน (Ring Promoter) ดังนั้นการสร้างเครื่องยนต์ที่ไม่ดีจึงไม่สามารถข้ามการทดสอบได้
9. บทสรุป
เทอร์โบชาร์จ LLM ไม่ใช่อัลกอริธึมเดียว กำลังเพจแคช KV (PagedAttention) ซึ่งเป็นกลไกการให้บริการที่ไม่ทำให้เพจเหล่านั้นเสียเปล่า (vLLM) การสร้างการรับรู้ท้องถิ่นเมื่อฮาร์ดแวร์เป็นเวิร์กสเตชัน GPU (PowerInfer) เอเจนต์ลูปที่แก้ไขจุดบกพร่องแทนการพ่นผู้สมัคร (Self-Debugging) และ — เมื่อคุณเป็นเจ้าของน้ำหนัก — ความสนใจที่จัดเก็บน้อยลง (EG-MLA) ทุกเลเยอร์ต้องแลกกับหน่วยความจำ เวลาแฝง และความแม่นยำ วัดปริมาณการเข้าชมของคุณ เผยแพร่ ADR เรือ.
อ้างอิง
- ควอน และคณะ — การจัดการหน่วยความจำที่มีประสิทธิภาพสำหรับโมเดลภาษาขนาดใหญ่ที่ให้บริการด้วย PagedAttention (arXiv:2309.06180, 14 ก.ย. 2023)
- เฉินและคณะ — การสอนโมเดลภาษาขนาดใหญ่เพื่อแก้ไขข้อบกพร่องด้วยตนเอง (arXiv:2304.05128, 12 เมษายน 2023)
- PowerInfer — SJTU-ไอแพด/PowerInfer (และส้อม Tiiny-AI ที่เกี่ยวข้อง)
- EG-MLA — ความสนใจแฝงแบบหลายหัวแบบฝังที่มีรั้วรอบขอบชิด (arXiv, 20 ก.ย. 2025)
- บล็อก vLLM — ง่าย รวดเร็ว และราคาถูก LLM ให้บริการด้วย PagedAttention.
จัดพิมพ์โดย TenthMatrix. ตัวเลขในกระดาษอ้างตามที่จัดพิมพ์โดยผู้เขียนต้นฉบับ หมายเลขการผลิตในคลัสเตอร์ของคุณจะแตกต่างกัน


