Blog
Mises à niveau Couchbase avec les portes de pause CAO : un aperçu convivial
Mise à niveau continue contrôlée à l'aide des portes de pause natives CAO, des contrôles de santé et de la surveillance compatible XDCR
Sur cette page
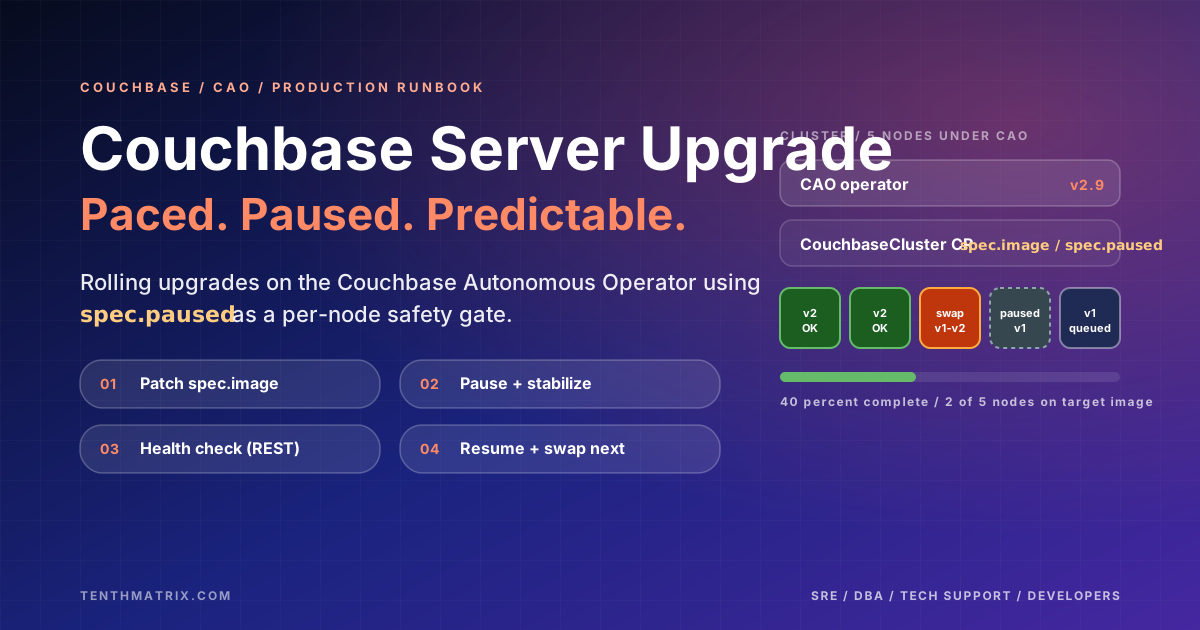
Si vous prenez en charge une plate-forme Couchbase (ou si vous êtes la personne qui est alertée lorsquene se comporte pas), les mises à niveau peuvent ressembler à un choix entre « ne pas intervenir et espérer » et « manuelles et risquées ». Cet article capture un terrain d'entente pragmatique : une mise à niveau continue contrôlée parpour le serveur Couchbase fonctionnant sous l'opérateur autonomeCouchbase (CAO), rythmée par le champspec.pausednatif de CAO.
À qui s'adresse-t-il
- Support technique / intervenants en cas d'incident :à quoi ressemble la « normalité » pendant le rééquilibrage du swap et ce qu'il faut traiter comme un signal d'alarme.
- SRE / ingénieurs de plate-forme : procédure répétableavec contrôles en amont, portes de trempage et déclencheurs de retour en arrière.
- Ingénieurs de base de données :rééquilibre les attentes, le comportement XDCR et la validation post-mise à niveau.
- Développeurs :ce que fait votre plate-forme pendant la fenêtre de maintenance (et ce sur quoi vous devez alerter).
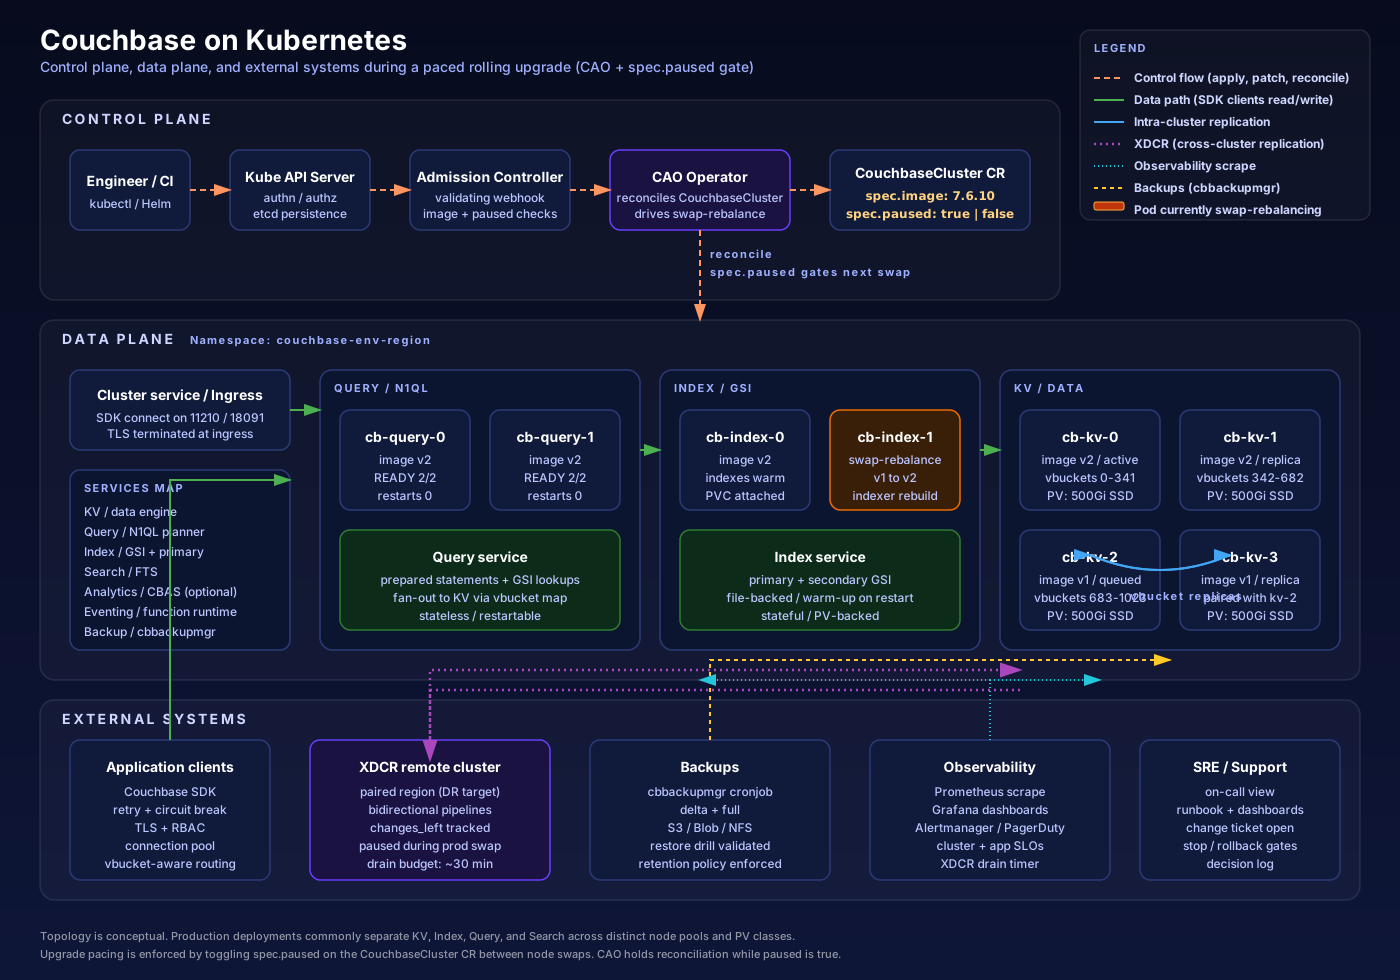
Topologie typique gérée par CAO (conceptuel)
Le diagramme ci-dessous est une carte mentale du runbook : où est assis l'opérateur, ce que contrôle leCouchbaseClusterCR et quels signaux vous devez corréler pendant la mise à niveau.
La grande idée : rythmer CAO avec une porte de pause
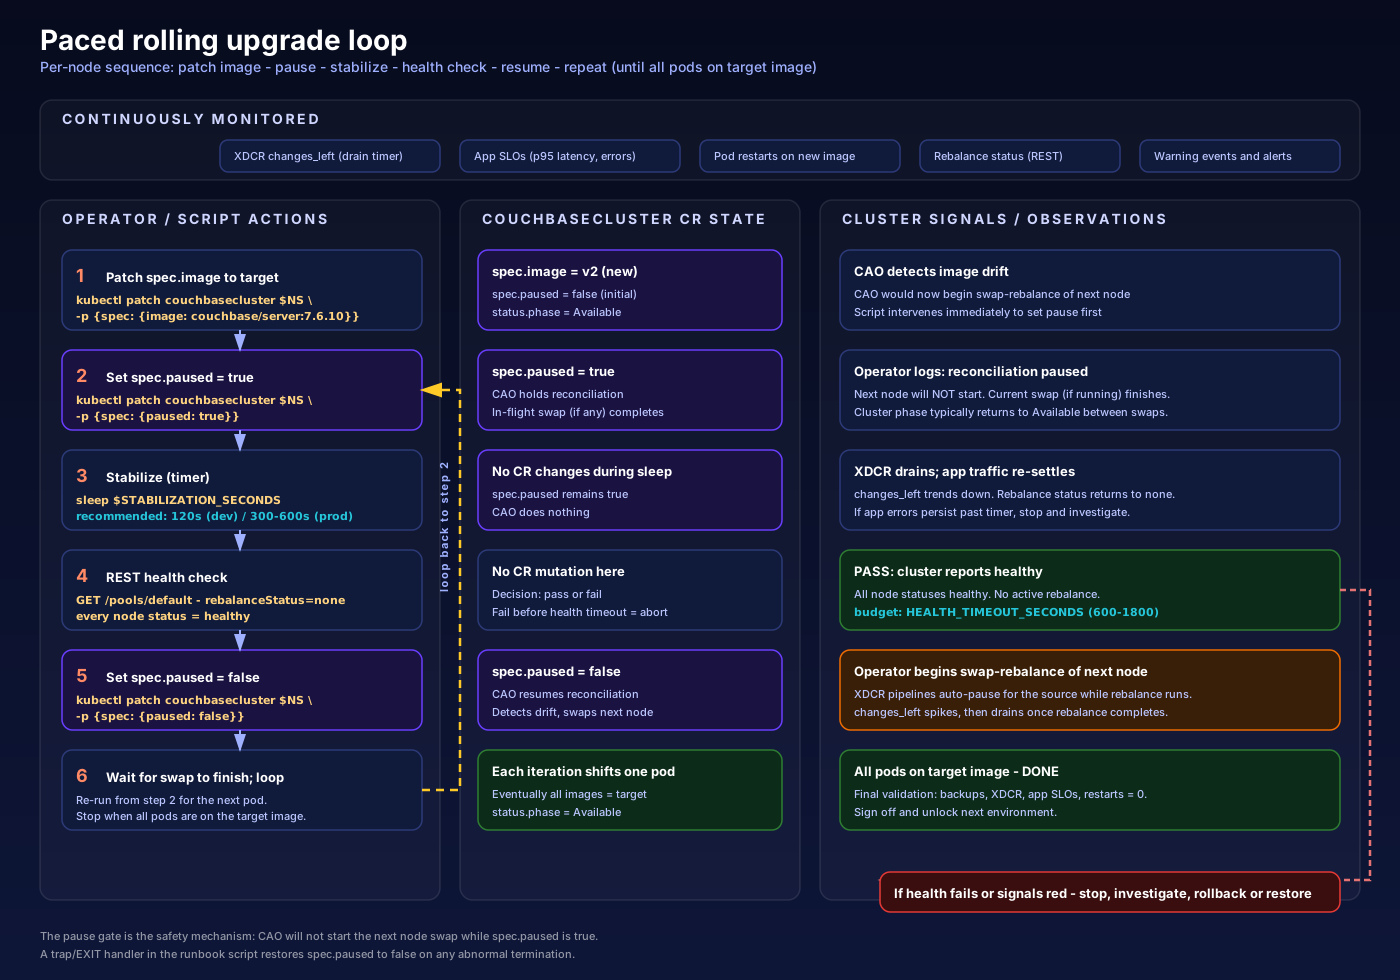
CAO effectue une mise à niveau continue via un rééquilibrage de swap. Le runbook ajoute une barrière de sécurité délibérée : suspendez la réconciliation entre les nœuds, stabilisez, vérifiez l'état, puis reprenez. De cette façon, si le nœud N se comporte mal après son échange, vous l'attrapezavant le démarrage du nœudN+1.
Pourquoi la porte pause en vaut la peine
- Moins de surprises :isole les symptômes d'un seul changement de nœud.
- Signaux plus propres :corrèle la latence, le taux d'erreur, l'état de rééquilibrage et le décalage XDCR avec un seul échange.
- Déploiements plus sûrs :arrête rapidement le « tapis roulant » en maintenant
spec.paused=truependant que vous enquêtez.
À quoi ressemble le « bon » lors de la mise à niveau
- Images du pod :ancien → nouveau progressivement ; idéalement, un échange à la fois.
- Phase de cluster :revient souvent à
Availableentre les swaps ; de brèves transitions pendant le rééquilibrage sont attendues. - XDCR (si activé) :
changes_leftmonte pendant le rééquilibrage, puis se vide pendant la stabilisation. - Redémarre : les nouveaux podsdémarrent à
RESTARTS=0. Toute augmentation est un signal pour faire une pause et enquêter.
Des vérifications en amont qui vous sauvent plus tard
Avant de toucher quoi que ce soit, assurez-vous que le cluster est vert (pas de rééquilibrage actif, aucun événement d'avertissement), que les sauvegardes sont actuelleset restaurableset que vous avez enregistré la balise d'image de restauration. Décidez dès le départ de votre stratégie XDCR : désactivez-la pendant la mise à niveau pour obtenir un signal plus silencieux en production, continuez à fonctionner en pré-prod pour exercer un comportement réel ou utilisez un troisième cluster de secours pour les basculements stratégiques.
Vérification de la réalité de la restauration
La vérité inconfortable que les runbooks matures disent à haute voix : la restauration den'est proprement possible que tant qu'au moins un nœud reste sur l'ancienne version. Une fois que chaque pod a été échangé et que le cluster a été entièrement rééquilibré, la « rétrogradation » peut devenir une « restauration à partir d'une sauvegarde ». C’est pourquoi le rythme est important : il maintient la fenêtre de restauration ouverte plus longtemps.
Étapes suivantes
- Lire le guide opérationnel complet :Mise à niveau continue du serveur Couchbase sous CAO (rythme + porte de pause)
- Contexte connexe :Couchbase haute disponibilité en production (opérateur XDCR + Kubernetes)
Plus d'articles du blog

Observability Is Not Optional: Make It a Business Standard
Why fragmented monitoring creates blind spots, duplicate spend, and slow incidents — and how to make centralised observability a non-negotiable company standard.

WSL Vault for Compliance: One Tenant Never Opens Another’s Secrets
How WSL Vault keeps app, team, and environment tenants cryptographically isolated — so a stolen root-style token cannot empty the estate — and why dual-tenant control beats secrets sprawl.

Workstation AI Shop: Promoting the AI Sales Storefront Through int → test → acc → prod
Workstation AI Shop sells GPU machines with a fully autonomous AI Sales Agent that configures the basket. See how Ring Promoter moves each build through int → test → acc → prod — with Orbit screenshots release engineers and stakeholders share.