Blog
Sistemas de deep learning: brief técnico para ingenieros y agentes
Aprendizaje de representaciones, vías discriminativas vs generativas, métricas y enrutamiento comprar/construir — conceptos de AWS reescritos para equipos de producción
En esta página
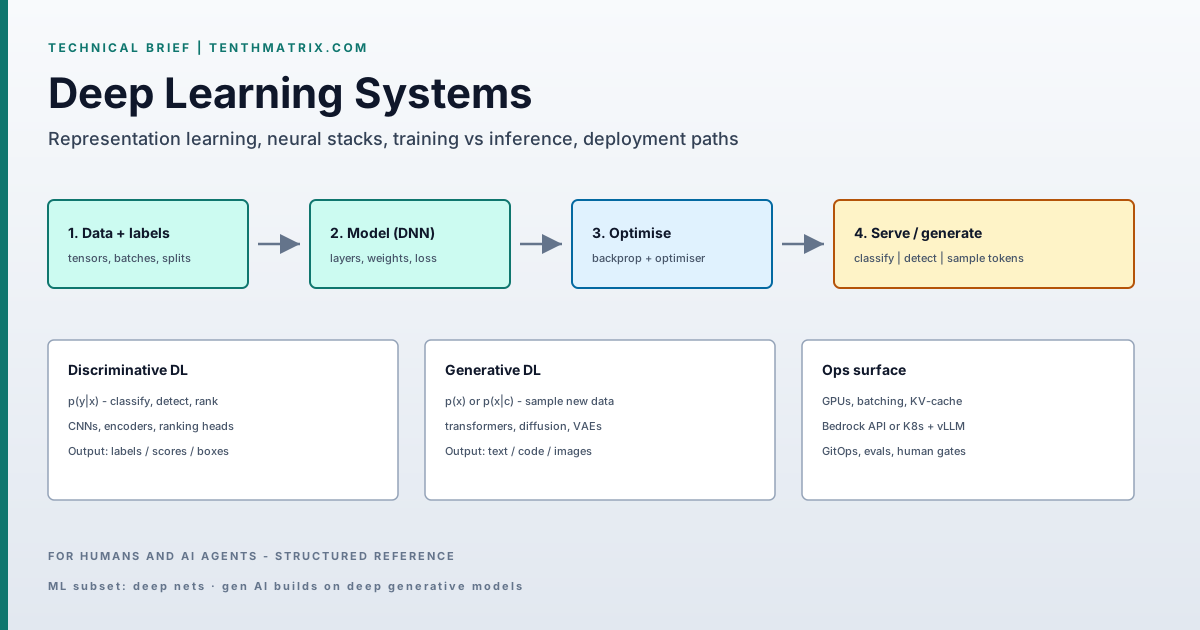
Digest técnico: deep learning como optimización neuronal multicapa, vías discriminativas vs generativas, y cómo enrutar trabajo a ML clásico, DL entrenado o APIs de foundation models. Ecuaciones, figuras y checklist de agente en el artículo largo.
Adaptado de AWS — What is Deep Learning? — para equipos de ingeniería de TenthMatrix.
División de capacidades
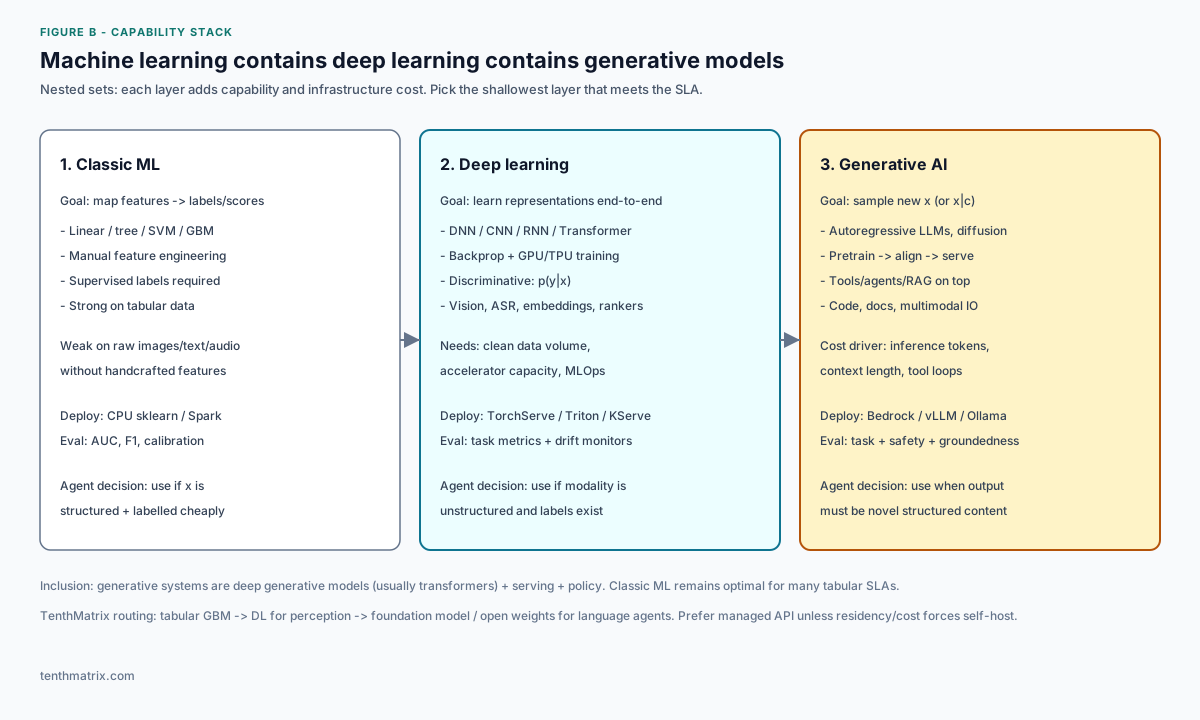
- Classic ML — features diseñadas; árboles/modelos lineales; mejor default para SLAs tabulares densos.
- Deep learning — redes end-to-end en imágenes/texto/audio; backprop + GPUs; servir vía Triton/KServe/SageMaker.
- Generative AI — muestrear contenido nuevo; LLMs/diffusion + RAG/herramientas; API Bedrock o inferencia open-weight.
Familias de tareas (las métricas importan)
| Familia | Objetivo / métrica típica |
|---|---|
| Vision | detectar/clasificar — mAP, IoU, latencia p99 |
| Speech | ASR/TTS — WER, factor en tiempo real |
| NLP | clasificar / generar — F1, exact-match, groundedness |
| Recommend | rankear — NDCG, CTR/CVR |
| Gen AI agents | éxito de tarea + seguridad + $/request |
Restricciones
- Data — el ruido de etiquetas y el shift dominan; versionar datasets.
- Compute — el entrenamiento y el decode de LLM están limitados por aceleradores.
- Ops — harness de eval, drift, coste, rollback GitOps antes de un promote amplio.
Recomendación de TenthMatrix
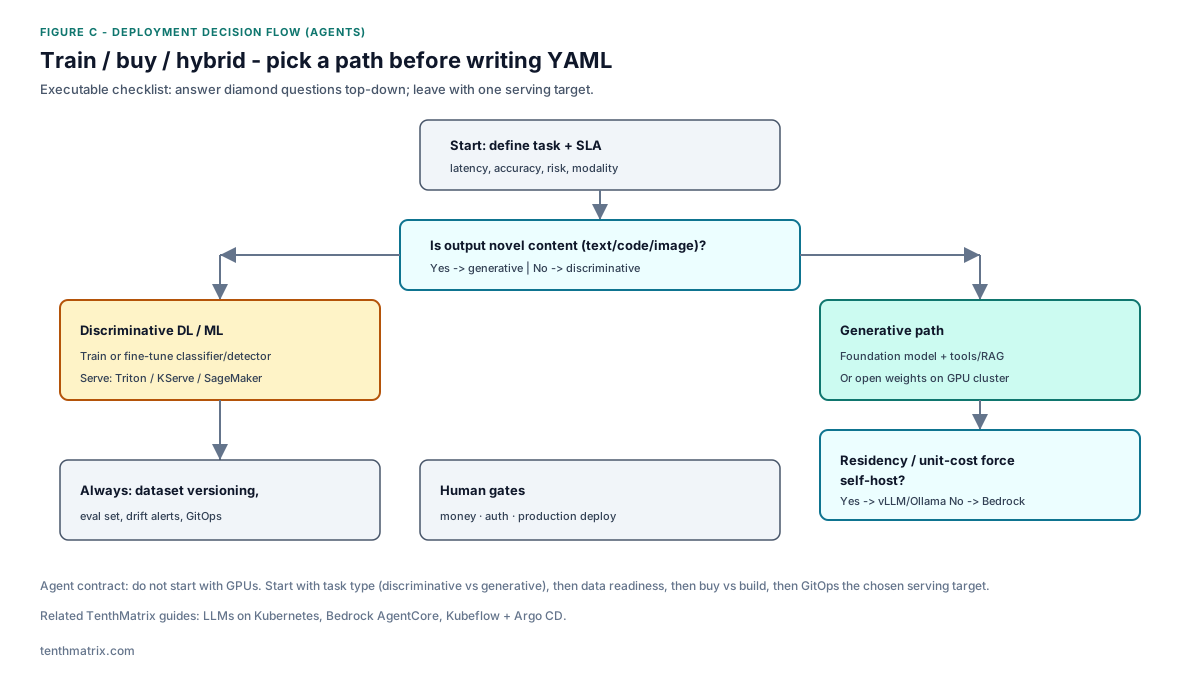
Clasifica primero discriminativo vs generativo. Prefiere foundation models gestionados para agentes de lenguaje salvo que residencia/coste fuerce pesos abiertos. Mantén ML clásico para tabular. Detalles, diagrama de capas y checklist: artículo largo. Publicado por TenthMatrix.
Más del blog

Observability Is Not Optional: Make It a Business Standard
Why fragmented monitoring creates blind spots, duplicate spend, and slow incidents — and how to make centralised observability a non-negotiable company standard.

WSL Vault for Compliance: One Tenant Never Opens Another’s Secrets
How WSL Vault keeps app, team, and environment tenants cryptographically isolated — so a stolen root-style token cannot empty the estate — and why dual-tenant control beats secrets sprawl.

Workstation AI Shop: Promoting the AI Sales Storefront Through int → test → acc → prod
Workstation AI Shop sells GPU machines with a fully autonomous AI Sales Agent that configures the basket. See how Ring Promoter moves each build through int → test → acc → prod — with Orbit screenshots release engineers and stakeholders share.