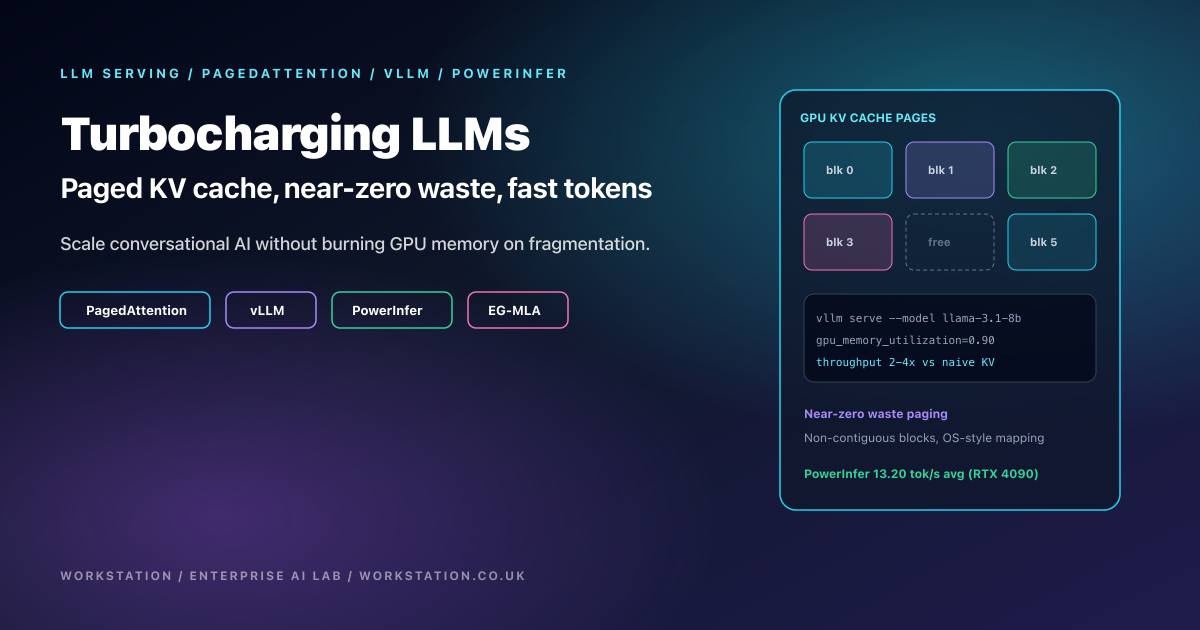
Turbocompresor LLMs
TenthMatrix con turbocompresor LLMs: paginación PagedAttention para caché KV, servicio vLLM, Self-Debugging para agentes, tasas de token PowerInfer y cortes de memoria EG-MLA, con compensaciones en la producción.
Tema
Publicaciones etiquetadas con Machine Learning
TenthMatrix con turbocompresor LLMs: paginación PagedAttention para caché KV, servicio vLLM, Self-Debugging para agentes, tasas de token PowerInfer y cortes de memoria EG-MLA, con compensaciones en la producción.
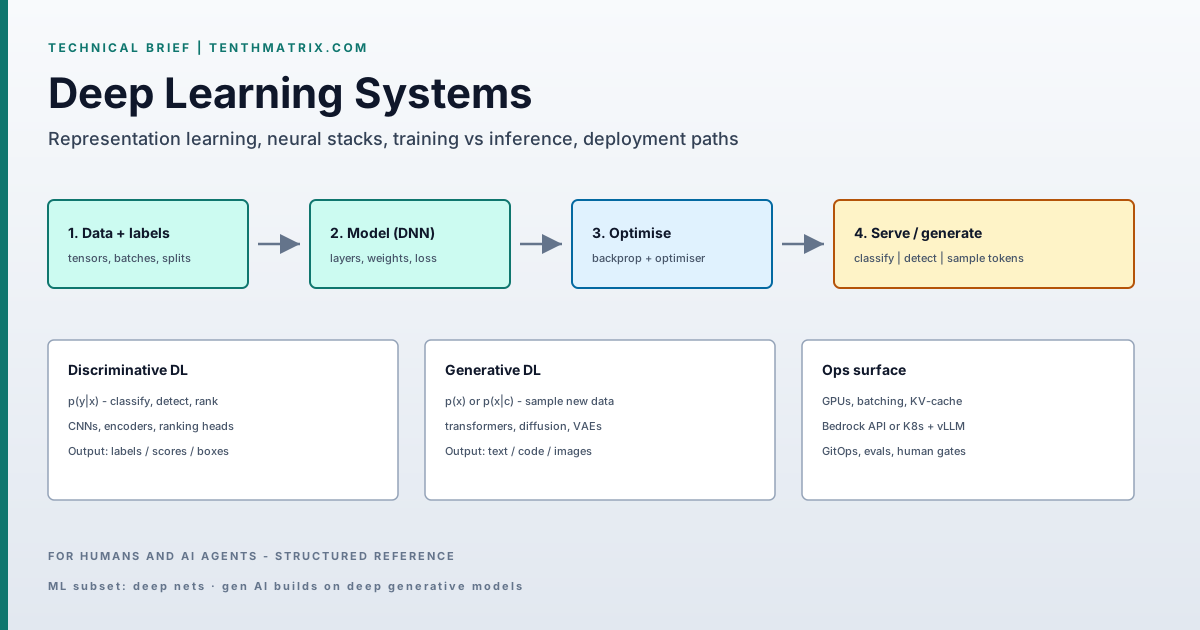
Brief técnico de TenthMatrix sobre deep learning: redes profundas entrenadas por gradiente, modelos discriminativos vs generativos, métricas de tarea y Bedrock vs serving en Kubernetes.
¿Qué son los modelos de lenguaje grande y cómo funcionan? Una explicación clara y no técnica para gerentes e ingenieros (tokens, incorporaciones, transformadores, capacitación e inferencia) además de producción Kubernetes YAML para implementar su propio LLM con Ollama y vLLM.