Блог
Турбонаддув LLMs
PagedAttention, vLLM, Self-Debugging, PowerInfer и EG-MLA — как масштабировать агенты LLM, не тратя впустую KV-кеш GPU
На этой странице
TenthMatrixо том, как усовершенствовать большие языковые модели в производстве: PagedAttention, vLLM, Self-Debugging, PowerInfer и EG-MLA — с учетом компромиссов, которые фактически проявляются на GPU. Подробное описание: длинная статья. Учебное пособие:Объяснение LLMs + Kubernetes.
: что такое LLM на самом деле
Контекст, а не демонстрация продукта:Введение в большие языковые модели(Андрей Карпати). Сопряжение с нашимс простым английским руководством LLM + Kubernetes.
Проблема масштабирования
LLMs разблокировал диалоговый искусственный интеллект и генерацию, после чего сразу же возникла проблема с обслуживанием. На каждом этапе декодирования ключи и значения добавляются в KV-кэш, который увеличивается с длиной последовательности и размером пакета. Наивные движки заранее резервируют огромные смежные плиты. Большая часть этой памяти простаивает, пока ждут другие запросы. Пропускная способность падает, хотя GPU выглядит «полным».
PagedAttention: виртуальная память для внимания
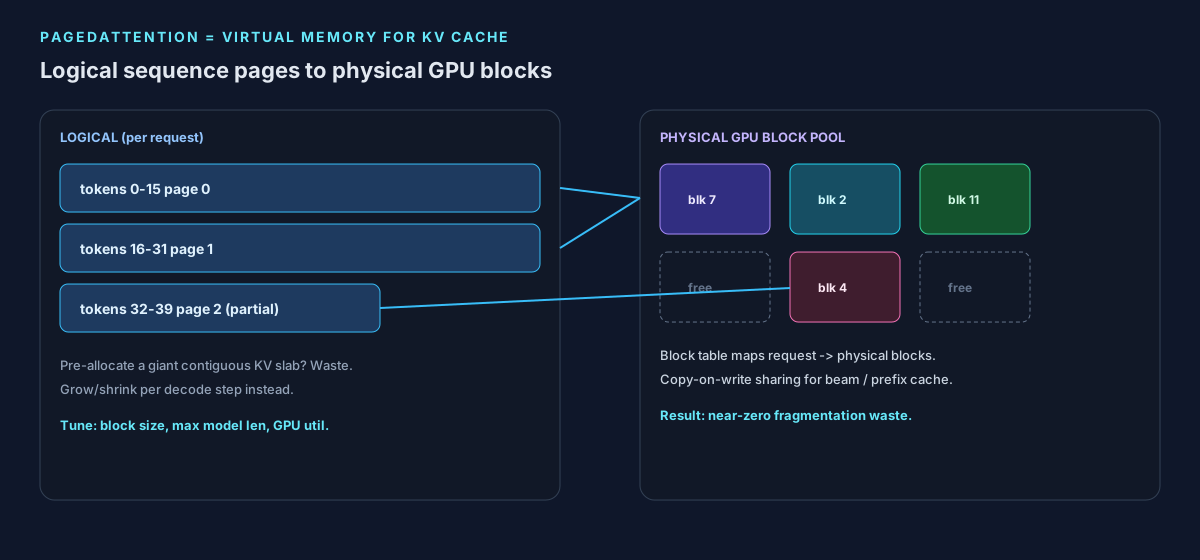
PagedAttention (Квон и др., SOSP 2023) обрабатывает KV-кеш как подкачку ОС: блоки фиксированного размера, таблица блоков на запрос, несмежные физические страницы[arXiv:2309.06180]. Ядро собирает блоки во время внимания. Вам по-прежнему необходимо настроить размер блока, максимальную длину моделии иерархию кэша(GPU HBM против разгрузки CPU против кэша префиксов). Слишком маленькие блоки добавляют накладные расходы на отображение; слишком большие блоки повторно вводят отходы.
vLLM: почти нулевые отходы при обслуживании
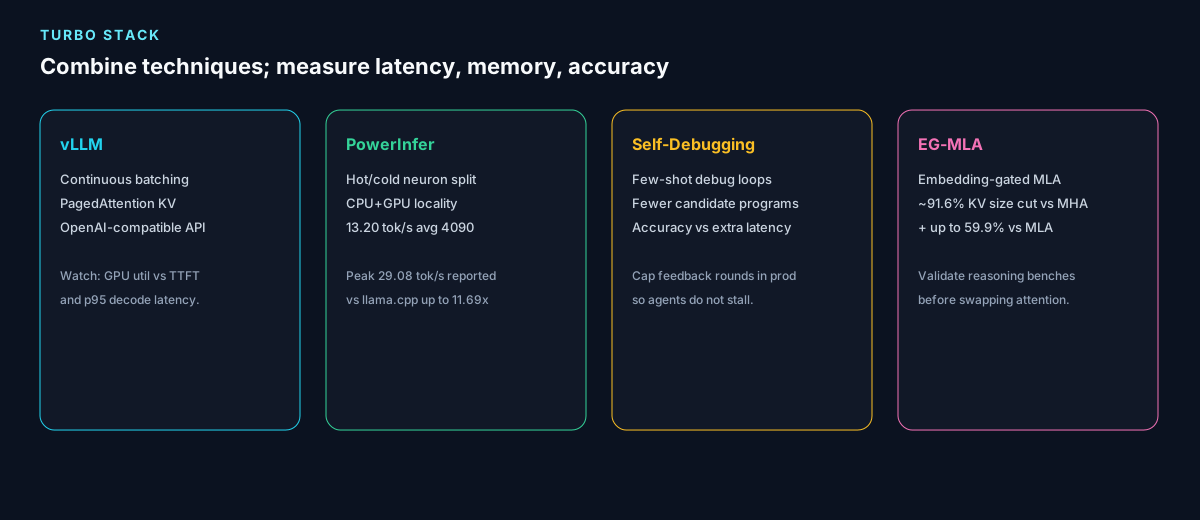
vLLM — это обслуживающая система, построенная на базе PagedAttention. Он нацелен на практически нулевой уровень потерь напряжения, непрерывное дозирование и совместимую с OpenAI поверхность HTTP. В производстве следите за тремя вещами: (1)gpu_memory_utilizationпротив OOM, (2) время до первого токена и токенов декодирования, (3) изменяет ли кэширование префикса/подсказки ответы для вашего набора оценок. Кэширование — это выигрыш в пропускной способности; он не свободен от эффектов корректности и задержки хвоста.
from vllm import LLM, SamplingParams

llm = LLM(model="meta-llama/Llama-3.1-8B-Instruct", gpu_memory_utilization=0.90)
params = SamplingParams(temperature=0.2, max_tokens=256)
outs = llm.generate(["Explain PagedAttention in one paragraph."], params)
print(outs[0].outputs[0].text)
Это реальное использование vLLM. Вызов «Обнимающее лицо» BERTforward()— это, а неPagedAttention — не путайте логиты классификатора с страничным обслуживанием KV.
Self-Debugging: качественные петли с ограниченной задержкой
Self-Debugging (Чен и др.) учит модель исправлять свои собственные предсказанные программы на основе нескольких трассировок, совпадая или превосходя базовые линии, которые выдают в 10 раз больше кандидатов[arXiv:2304.05128]. Для агентов это золото — до тех пор, пока раунды обратной связи не суммируются. Ограничьте количество отладочных сообщений, протоколируйте каждый раунд и закройте проект для человека или более мелкого специалиста, когда бюджет закончится.
Watch: контекст обслуживания и вывода
Контекстный доклад о быстром обслуживании LLM, а не официальная демонстрация TenthMatrix. Выполните сопряжение с бумагой vLLM и документомdocs.vllm.ai.
PowerInfer: токены на одном жире GPU
PowerInfer разделяет «горячие» и «холодные» нейроны, поэтому потребительские модели GPU и CPU могут быстро генерировать токены. Заявленные цифры:13,20 токенов/с в среднем, пик29,08 токенов/сна одном NVIDIA RTX 4090, до11,69xпо сравнению с llama.cpp при сохранении точности[PowerInfer]. В масштабе парка вам по-прежнему необходимо размещение: какие слои остаются на GPU, как вы распределяете между узлами и соответствует ли профиль местоположения, подсказки, моделям в газете.
EG-MLA: уменьшите КВ, не повредив верстак
EG-MLA (встраивание скрытого внимания нескольких головок) сообщает о сокращении кэша KVболее чем на 91,6 %.по сравнению с многоголовочным вниманием с незначительным ухудшением, дополнительной экономией по сравнению с MLA (до 59,9 %) и лучшими показателями по наборам рассуждений, масштабированным по параметрам 1B.[бумага EG-MLA]. Относитесь к этому как к выбору архитектуры, а не как к вставному флагу на зависшей контрольной точке vLLM — проверьте свою оценочную систему, прежде чем отмечать график памяти.
Собираем вместе
Комбинируйте PagedAttention + vLLM для обслуживания кластера, PowerInfer, когда в качестве рабочей станции используется GPU, Self-Debugging внутри агентов кодирования с жестким лимитом округления и EG-MLA, когда вы управляете семейством моделей. Распределенное обслуживание добавляет сложности: параллелизм KV, разделение предварительного заполнения/декодирования и автоматическое масштабирование, которое не перегружает таблицы страниц. Мера. Затем напишите ADR.
Читать далее
- Длинная статья— ручки, режимы отказа, примечания к Kubernetes.
- Объяснение LLMs + запуск самостоятельно на Kubernetes
- Muse Glimmer / локальные агенты·Корпоративная лаборатория искусственного интеллекта
ОпубликованоTenthMatrix.
Ещё из блога

Observability Is Not Optional: Make It a Business Standard
Why fragmented monitoring creates blind spots, duplicate spend, and slow incidents — and how to make centralised observability a non-negotiable company standard.

WSL Vault for Compliance: One Tenant Never Opens Another’s Secrets
How WSL Vault keeps app, team, and environment tenants cryptographically isolated — so a stolen root-style token cannot empty the estate — and why dual-tenant control beats secrets sprawl.

Workstation AI Shop: Promoting the AI Sales Storefront Through int → test → acc → prod
Workstation AI Shop sells GPU machines with a fully autonomous AI Sales Agent that configures the basket. See how Ring Promoter moves each build through int → test → acc → prod — with Orbit screenshots release engineers and stakeholders share.