Blog
Sistemas de deep learning: brief técnico para engenheiros e agentes
Aprendizado de representações, caminhos discriminativos vs generativos, métricas e roteamento buy/build — conceitos da AWS reescritos para equipes de produção
Nesta página
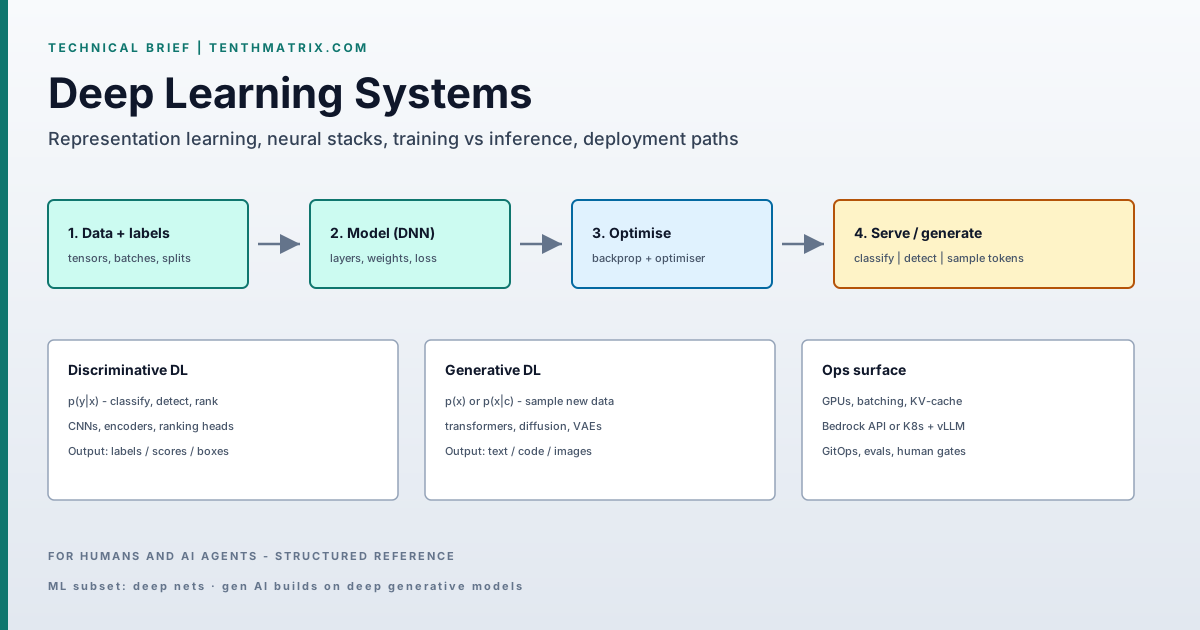
Digest técnico: deep learning como otimização neural multicamada, caminhos discriminativos vs generativos, e como rotear trabalho para ML clássico, DL treinado ou APIs de foundation models. Equações, figuras e checklist de agente no artigo longo.
Adaptado da AWS — What is Deep Learning? — para equipes de engenharia da TenthMatrix.
Divisão de capacidades
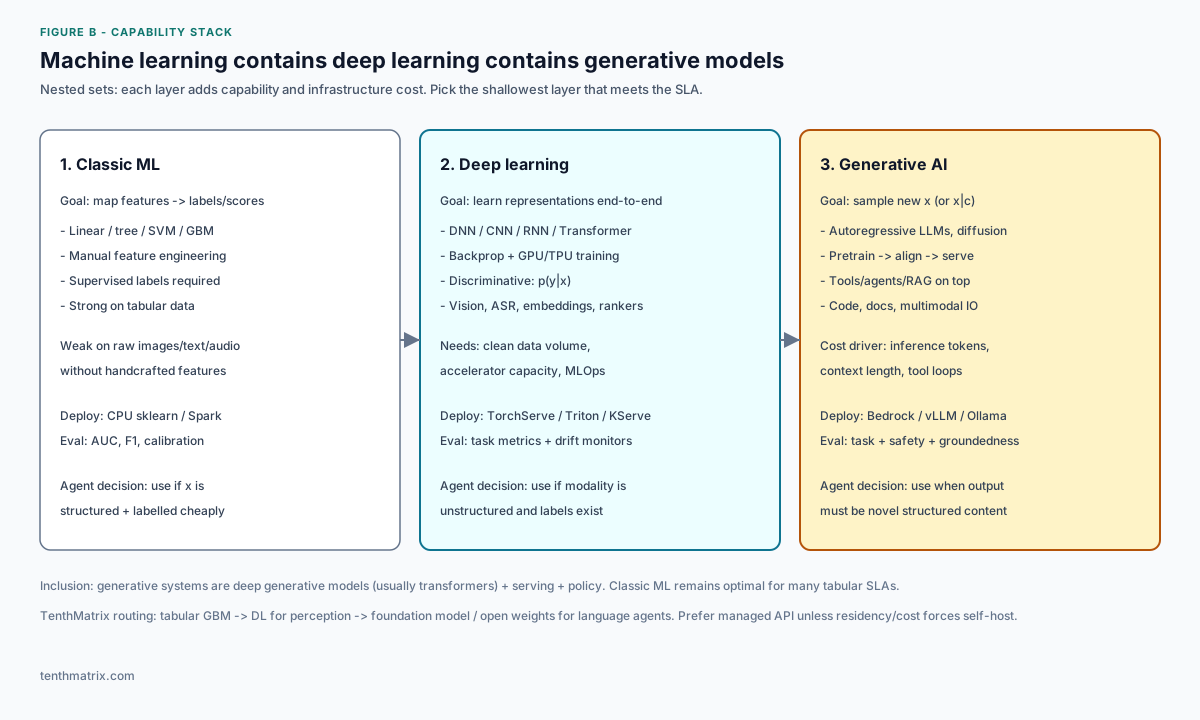
- Classic ML — features engenheiradas; árvores/modelos lineares; melhor default para SLAs tabulares densos.
- Deep learning — redes end-to-end em imagens/texto/áudio; backprop + GPUs; servir via Triton/KServe/SageMaker.
- Generative AI — amostrar novo conteúdo; LLMs/diffusion + RAG/tools; API Bedrock ou inferência open-weight.
Famílias de tarefas (métricas importam)
| Família | Objetivo / métrica típica |
|---|---|
| Vision | detectar/classificar — mAP, IoU, latência p99 |
| Speech | ASR/TTS — WER, fator em tempo real |
| NLP | classificar / gerar — F1, exact-match, groundedness |
| Recommend | rankear — NDCG, CTR/CVR |
| Gen AI agents | sucesso da tarefa + safety + $/request |
Restrições
- Data — ruído de labels e shift dominam; versionar datasets.
- Compute — treinamento e decode de LLM são limitados por aceleradores.
- Ops — eval harness, drift, custo, rollback GitOps antes de promote amplo.
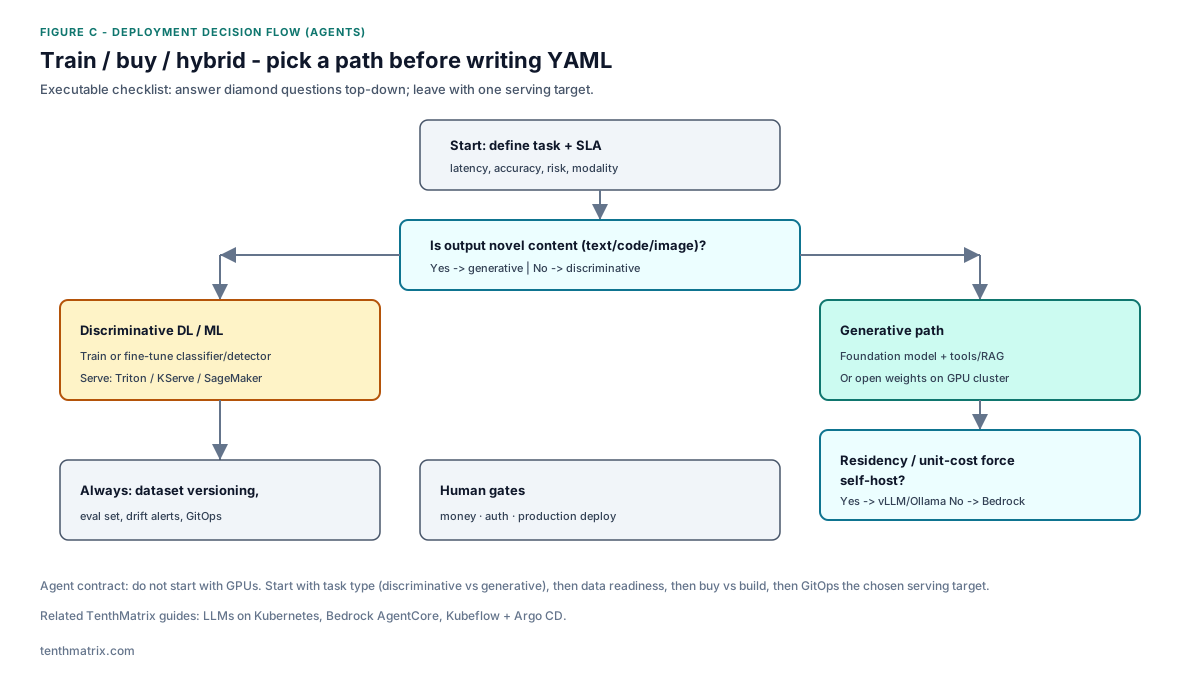
Recomendação TenthMatrix
Classifique primeiro discriminativo vs generativo. Prefira foundation models gerenciados para agentes de linguagem salvo residência/custo forçar open weights. Mantenha ML clássico para tabular. Detalhes, diagrama de camadas e checklist: artigo longo. Publicado por TenthMatrix.
Mais do blog

Observability Is Not Optional: Make It a Business Standard
Why fragmented monitoring creates blind spots, duplicate spend, and slow incidents — and how to make centralised observability a non-negotiable company standard.

WSL Vault for Compliance: One Tenant Never Opens Another’s Secrets
How WSL Vault keeps app, team, and environment tenants cryptographically isolated — so a stolen root-style token cannot empty the estate — and why dual-tenant control beats secrets sprawl.

Workstation AI Shop: Promoting the AI Sales Storefront Through int → test → acc → prod
Workstation AI Shop sells GPU machines with a fully autonomous AI Sales Agent that configures the basket. See how Ring Promoter moves each build through int → test → acc → prod — with Orbit screenshots release engineers and stakeholders share.