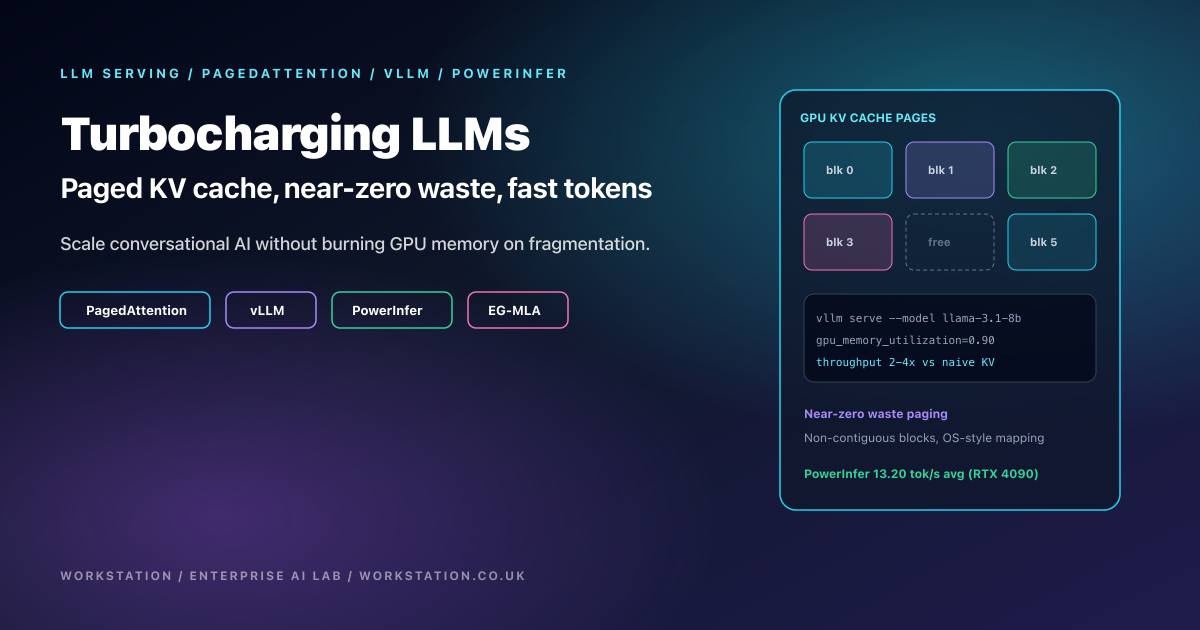
Turbocompressão LLMs
TenthMatrix com turboalimentação LLMs: paginação PagedAttention para cache KV, serviço vLLM, Self-Debugging para agentes, taxas de token PowerInfer e cortes de memória EG-MLA — com compensações de produção.
Tópico
Posts com a tag Machine Learning
TenthMatrix com turboalimentação LLMs: paginação PagedAttention para cache KV, serviço vLLM, Self-Debugging para agentes, taxas de token PowerInfer e cortes de memória EG-MLA — com compensações de produção.
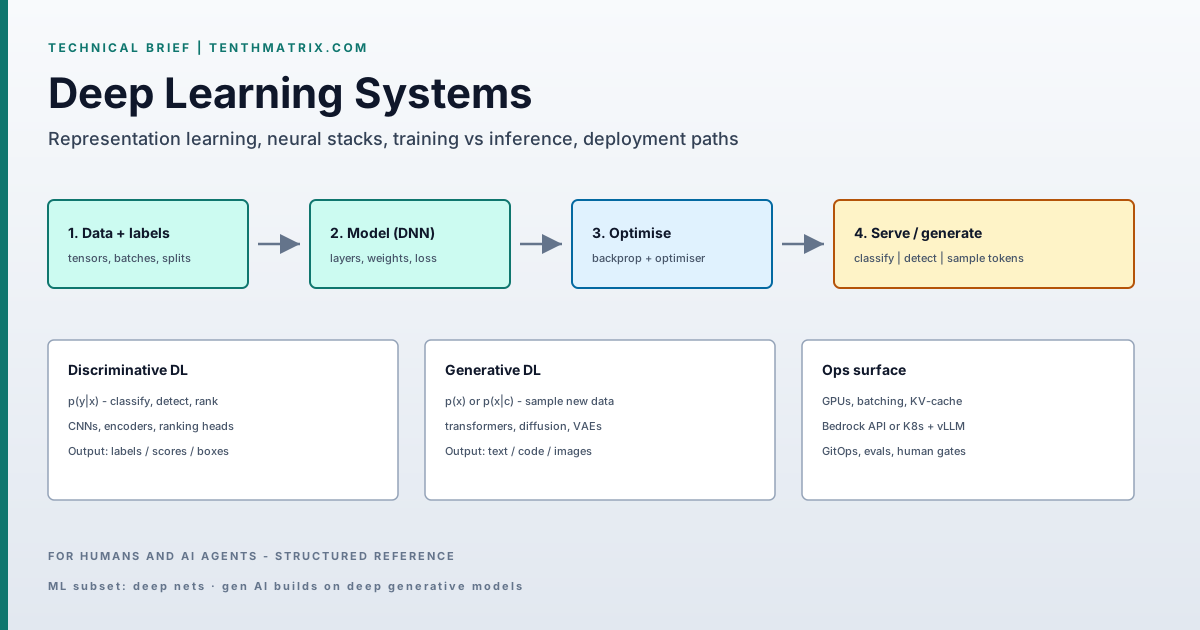
Brief técnico da TenthMatrix sobre deep learning: redes profundas treinadas por gradiente, modelos discriminativos vs generativos, métricas de tarefa e Bedrock vs serving em Kubernetes.
O que são modelos de grandes linguagens e como funcionam? Um explicador claro e não técnico para gerentes e engenheiros — tokens, incorporações, transformadores, treinamento e inferência — além de Kubernetes YAML de produção para implantar seu próprio LLM com Ollama e vLLM.