O Kimi K3 da Moonshot AI não inventou os pesos abertos — Llama, DeepSeek, Qwen e outros já provaram a categoria. O que mudou no final de julho de 2026 é que um modelo open-weight com ~2,8 trilhões de parâmetros, contexto de 1M tokens e serving de produção day-0 agora compete em cargas agent antes reservadas à Anthropic e OpenAI. Este guia TenthMatrix é para developers e líderes de tecnologia que precisam decidir: self-host, API gerenciada ou híbrido — e quais outros modelos abertos merecem estar no radar.
1. O que a Moonshot entregou
Segundo o GitHub e materiais técnicos da Moonshot (pesos públicos ~27 jul 2026):
- Kimi K3 — open-weight, modelo agentic multimodal nativo; ~2,8T parâmetros totais (MoE).
- Destaques de arquitetura: Kimi Delta Attention (KDA), Attention Residuals (AttnRes), Stable LatentMoE; ativação sparse de experts (ordem de 16 de 896 experts / ~100B params ativos por token — confirme no model card ao vivo).
- Contexto de 1M tokens; visão + tool use + coding/knowledge work de longo horizonte.
- Pesos: Hugging Face
moonshotai/Kimi-K3(comumente em MXFP4; footprint ~1,4 TB). - Motores de inferência day-0: vLLM, SGLang, TokenSpeed; API hospedada em platform.kimi.ai.
Licença: Kimi K3 License — não é um passe livre de SaaS. Empresas e provedores Model-as-a-Service devem revisar juridicamente antes de productizar (VentureBeat e análises independentes sinalizaram limiares comerciais). Open weights ≠ aberto para todo modelo de negócio.
2. Consegue acompanhar Anthropic e OpenAI?
Resposta curta para builders: em vários benches relevantes para agents, sim — perto o suficiente para que o default não seja mais «apenas closed».
Avaliações de comunidade e vendors após o lançamento colocaram o K3 na mesma faixa dos modelos proprietários líderes em SWE-bench Verified e suites tipo LiveCodeBench, com tool-use competitivo contra baselines Claude Sonnet e GPT-4o-class. Esse é o marco: open weights cruzando a barra em tarefas agent, não só trivia MMLU.
Caveats que a TenthMatrix insiste:
- Benchmarks são sensíveis ao harness — rode o seu golden set.
- Ganhos de latência p50 podem esconder dor p95/p99 em cadeias multi-tool.
- Labs closed ainda lideram em polish de produto, tooling de segurança e SLAs de suporte.
- Routing híbrido (open para dados privados + closed para peak-critical) continua a arquitetura pragmática.
3. Por que a infraestrutura se moveu em dias, não meses
A virada estratégica é a maturidade do serving:
- vLLM publicou orientação de produção day-0: prefix caching KDA-aware, kernels NVIDIA/AMD, disaggregação prefill/decode, speculative decoding (draft models DSpark), tool calling, structured output.
- Motores de inferência cloud e hyperscalers (incluindo recipes AWS SageMaker HyperPod / EKS) publicaram caminhos de deploy na mesma semana em que os pesos apareceram.
- Resultado: escolher self-host vs managed é cada vez mais uma decisão de config e FinOps, não um projeto de pesquisa de um trimestre — se você já tem capacidade GPU e músculo MLOps.
4. Realidade de hardware (não pule)
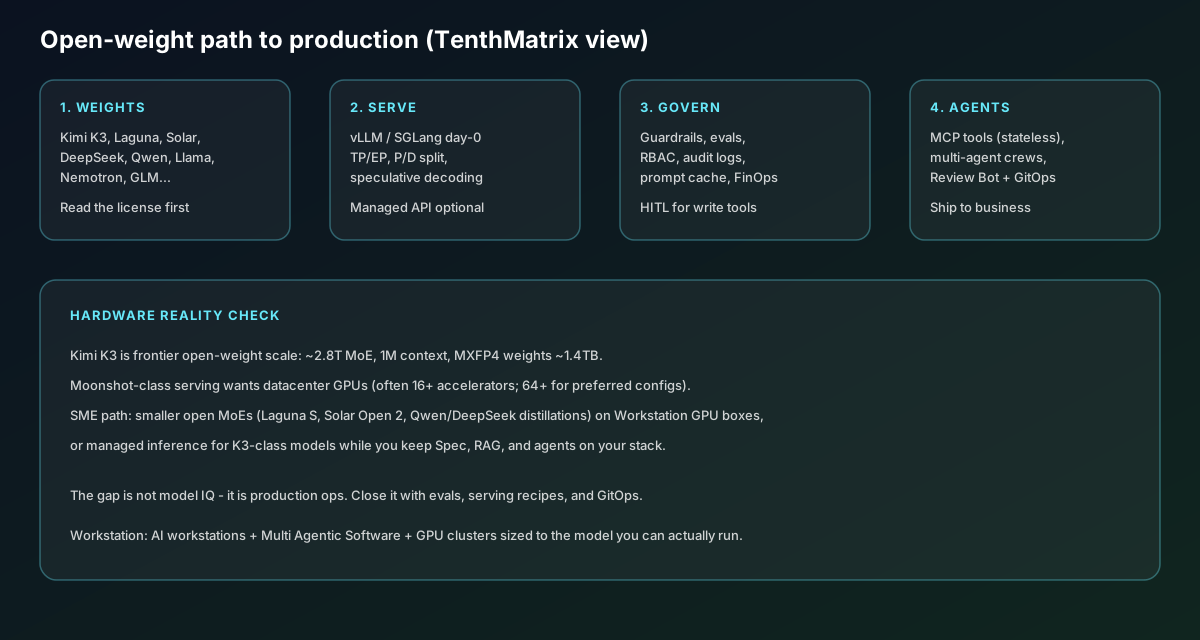
K3 não é um modelo de laptop. A orientação orientada à Moonshot aponta para deploys em escala de datacenter (muitas vezes 16+ GPUs high-end como caminho mínimo crédível nas notes vLLM; configs preferidas até 64+ aceleradores). Só os pesos são classe terabyte.
Caminho SME / mid-market: rode MoEs open menores em boxes AI Workstation; chame K3 via API gerenciada quando precisar desse IQ; mantenha corpora RAG e agents privados.
Caminho enterprise: cluster GPU + vLLM/SGLang + GitOps + evals — ou compre capacidade gerenciada e invista engenharia na camada agent em vez de kernels.
Vídeo: walkthrough prático de serving cloud com vLLM — útil antes de dimensionar um nó classe K3.
5. Panorama de política e segurança
Na mesma janela, NVIDIA e parceiros impulsaram a Open Secure AI Alliance e amplificaram a carta Open Weights and American AI Leadership (270+ orgs). O argumento: open weights não são só uma história econômica — defensores precisam de modelos inspecionáveis para red-teamar agents e cadeias de software. Pare abertura com evals, guardrails e cultura de patch rápido — não um «banir modelos open» ingénuo.
6. MCP ficou stateless (por que agents se importam)
A especificação MCP 2026-07-28 é a maior revisão de protocolo desde o lançamento:
- Remove o handshake initialize e
Mcp-Session-Id— requests carregam version/capabilities em_meta. - Qualquer instância atrás de um load balancer simples pode servir qualquer request (sem imposto de sessão sticky Redis).
- Auth endurecida alinhada a OAuth/OIDC; política formal de depreciação ~12 meses.
- Extensões: MCP Apps (UIs renderizadas no servidor), MCP Tasks (handles de jobs durables de longa duração).
Para stacks multi-agent TenthMatrix, MCP stateless significa que frotas de tools escalam como microserviços HTTP normais — a peça que faltava quando modelos open finalmente ganham IQ agent-grade.
7. O gap de produção (ainda a história real)
Pesquisas da indústria (incluindo reporting open-source AI da Mozilla) repetem um padrão: developers experimentam open weights em altas taxas, mas uma parcela menor chega à produção do que times closed-API — e o gap costuma aumentar com o tamanho da empresa. Vendors closed vendem uma estrada pavimentada; modelos open ainda exigem que você possua serving, scaling, observabilidade e segurança. Kimi K3 eleva o teto; não apaga a metade ops do trabalho.
8. Modelos no nosso radar (expandido)
Além do K3, a TenthMatrix acompanha este conjunto open / semi-open para coding agentic e stacks AI privadas (verifique licenças e benches antes do procurement):
| Modelo | Por que importa | Fit |
|---|---|---|
| Kimi K3 (Moonshot) | MoE 2,8T, ctx 1M, coding agent open frontier | Cluster / API gerenciada |
| Laguna S 2.1 (Poolside) | MoE 118B-A8B, ctx 1M, fortes benches Terminal/SWE, OpenMDW | Agents SWE self-host |
| Solar Open 2 (Upstage) | 250B-A15B, ctx 1M, office/coding agentic, ângulo soberano KR | Classe 4–8× H200 |
| DeepSeek-V4 family | Pressão MoE open contínua em price-performance reasoning/coding | Agents cost-sensitive |
| Qwen 3.x / Max (Alibaba) | Ecossistema multilíngue + tools amplo; destilações para workstations | Stack open padrão |
| Llama 4 class (Meta) | Ecossistema permissivo, enorme fine-tune/tooling comunitário | Fine-tunes / RAG |
| Nemotron 3 (NVIDIA) | Open weights alinhados à história serving/segurança da NVIDIA | Estates GPU-native |
| GLM-4.x / 5 (Zhipu) | Forte linhagem agent/tooling; observe licença + região de hosting | Agents tool-heavy |
| KAT-Coder-V2.5 (Kwaipilot) | Especialista coding MoE ~35B-A3B; Apache 2.0; tamanho SWE-bench | SWE TenthMatrix |
| Mistral Large / Magistral | Opções comerciais open EU-friendly; forte história de tooling | AI privada UE |
| Gemma 3 (Google) | Modelos open eficientes para edge e on-device | Edge / Mac Silicon |
| Phi-4 class (Microsoft) | Reasoners pequenos e capazes para boxes limitados | Workstations SME |
| Mage-Flow (Microsoft) | Text-to-image / edit compacto ~4B; MIT; rivaliza stacks de difusão maiores | Criativo local |
| Inflect v2 (Owen Song) | TTS inglês local tiny (Nano/Micro); Apache 2.0 | Voz offline |
| Claude Opus 5 / Fable 5 (closed) | Ainda o teto de qualidade para muitos caminhos coding/agent no Bedrock | Caminho peak híbrido |
| GPT-5.6 Sol/Terra/Luna (closed) | Inferência closed em tiers para designs de router | Failover gerenciado |
9. Padrões práticos que a TenthMatrix recomenda
Private RAG + tools on open weights (Qwen / Laguna / Solar / DeepSeek)
        │
        ├─ Lead planner on K3 API or Opus 5 (Bedrock) when stuck
        ├─ Builders on mid open MoE self-hosted
        ├─ Review Bot + human gate
        └─ GitOps promote
- Escreva um ADR: modelo open padrão + modelo closed de failover.
- Golden eval set (50–100 tarefas) antes de virar produção.
- Meça p95/p99 em cadeias multi-tool agent — não só o TTFT mediano.
- Prompt-cache com cuidado (um UUID no topo do prompt pode destruir hit rates).
- Atualize servidores MCP para 2026-07-28 antes de escalar horizontalmente.
- Dimensione GPUs para o modelo que você realmente vai servir — não a manchete do blog.
10. Encerramento
Kimi K3 é um proof point: open weights agora contestam o trabalho agent frontier, e o ecossistema de serving (vLLM, SGLang, recipes cloud) acompanha o ritmo em dias. Grupos de policy argumentam que modelos open fazem parte da ciberdefesa, não só do controle de custos. Para empresas, a jogada vencedora é um router híbrido em hardware Workstation-grade e Multi Agentic Software — open onde privacy e custo dominam, closed onde SLAs de qualidade exigem, com MCP, evals e GitOps para que «testamos um modelo open» se torne «fazemos ship em modelos open».
Publicado por TenthMatrix. Specs e benches mudam semanalmente — reconferir model cards, licenças e política regional antes de comprar silicon.


