Artigo
Upgrade rolling do Couchbase Server sob CAO (ritmo + porta de pausa)
Runbook copiar/colar para suporte e equipes SRE: preflight, swap-rebalance nó a nó, estratégia XDCR, gatilhos de rollback e checagens de sign-off
Nesta página
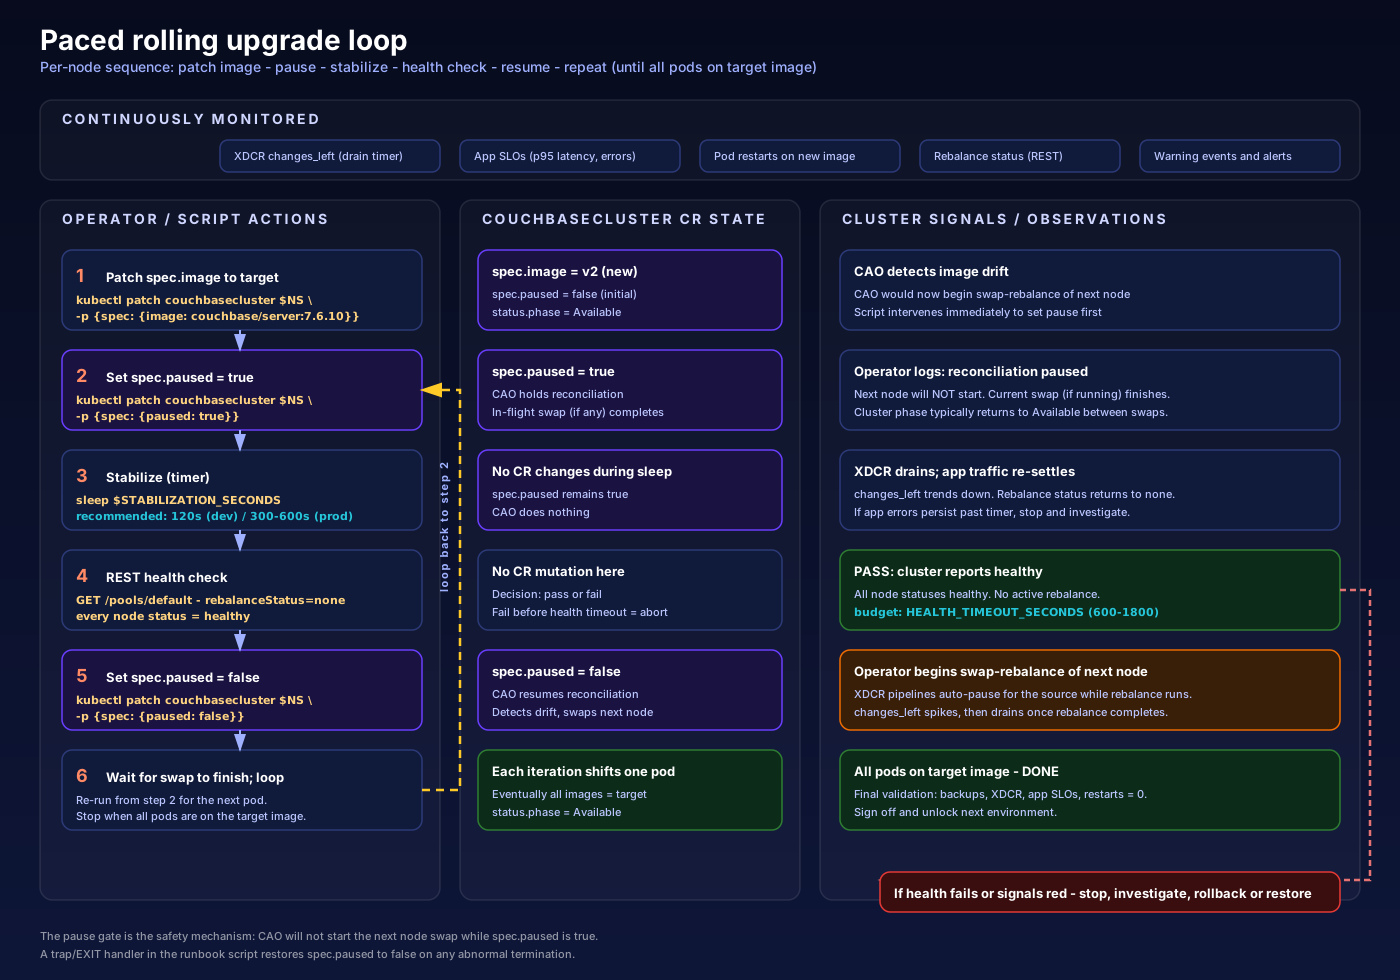
Upgrades são onde a confiabilidade do banco é comprovada ou quebrada. Este artigo oferece um runbook ritmado, amigável ao suporte, para atualizar o Couchbase Server sob o Couchbase Autonomous Operator (CAO), usando o campo nativo spec.paused para controlar o progresso entre nós. Resultado: um nó por vez, janela de estabilização entre swaps, sinais mais claros e janela de rollback maior.
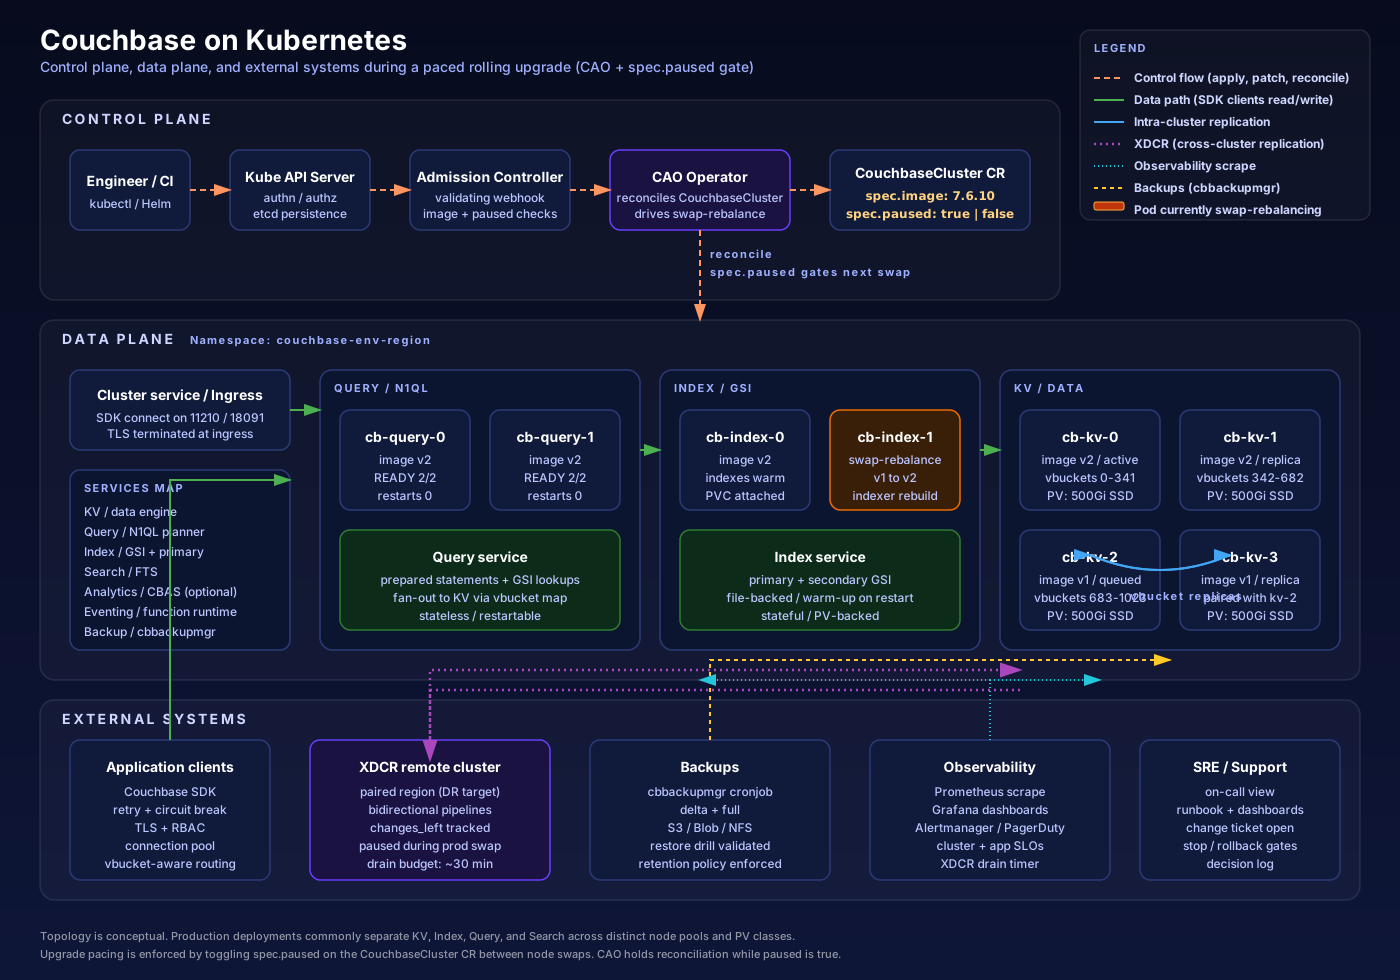
Topologia de referência
O loop de upgrade ritmado
Objetivos
- Atualizar o Couchbase Server com risco mínimo.
- Manter uma janela deliberada de pausa + estabilizar + health check entre nós.
- Manter opções de rollback pelo maior tempo prático.
Checklist pré-upgrade (não pule)
- Tudo verde: fase do cluster
Available, sem rebalance ativo, sem eventos Warning. - Backups atuais e restauráveis: backup completo concluído; drill de restore feito ou tempo compreendido.
- Tag de rollback registrada: verificar que a imagem antiga ainda existe e pode ser puxada.
- Decisão XDCR registrada: desativar durante upgrades de prod para sinal limpo (recomendado), ou manter em pre-prod para exercitar o comportamento.
Comandos rápidos de verificação
export ENV=dev
export REGION=west
export NS=couchbase-${ENV}-${REGION}

kubectl -n "$NS" get couchbasecluster -o wide
kubectl -n "$NS" get pods -l app=couchbase
kubectl -n "$NS" get events --field-selector type=Warning | tail -20
kubectl -n "$NS" get couchbasecluster "$NS" -o jsonpath='paused={.spec.paused} phase={.status.phase} rebalance={.status.rebalanceProgress}{"\n"}'
Caminhos de execução
- Preferido: executar o upgrade do seu workflow de CI (dry-run primeiro, depois real).
- Fallback: executar o script de upgrade ritmado de uma workstation (dry-run primeiro, depois real).
Sinais de monitoramento (o que o suporte deve observar)
- Imagens dos pods: transição antiga → nova; um swap por vez é ideal.
- Estado de pausa:
spec.pausedfica true durante a estabilização; nunca deixar true sem atenção. - Rebalance: volta a none entre swaps; investigar rebalances persistentes.
- XDCR:
changes_leftsobe no rebalance e drena na estabilização; falha em drenar é sinal de incidente. - Restarts: qualquer restart inesperado pós-swap é bandeira vermelha.
Gatilhos de rollback
- O nó não fica healthy dentro da janela de timeout.
- O rebalance falha e não se resolve com uma única retry após investigação.
- A taxa de erro da aplicação excede a tolerância acordada.
- XDCR não se recupera após a janela de recuperação acordada.
- Qualquer bucket indisponível (vbuckets faltando) — tratar como P1.
Validação pós-upgrade (sign-off)
- Todos os pods na imagem alvo
- Fase do cluster
Available - Sem novos eventos Warning por 30+ minutos
- Backup bem-sucedido pós-upgrade
- XDCR em steady-state recuperado (se usado)
- Dashboards da aplicação verdes por 30+ minutos
Dica: Se quiser primeiro uma versão narrativa mais curta, comece pelo resumo do blog: Upgrades Couchbase com portas de pausa CAO.
Mais artigos técnicos

Big Prometheus at Scale: Pros, Cons, and a MoSCoW Map of Observability Tools
TenthMatrix rewrite of the Big Prometheus problem space: Thanos, Cortex/Mimir, VictoriaMetrics, M3/Chronosphere — plus MoSCoW across OTEL, Grafana, SaaS APM and more

WSL Vault Technical Deep Dive: Zero-Trust Secrets, Dual Control, MFA & Multi-Region HA
Technical deep dive: envelope hierarchy, dual-control workflows, MFA, leases, active/active multi-region HA, feature tours, and presentation chapters

Workstation AI Shop on Ring Promoter: Orbit, Version-Verified Health and the Path from INT to PROD
Technical guide: shop Helm/CI mapping, Orbit semantics, version-verified health for the AI agent, secrets per ring, promote API, and a production checklist