Blog
Turbolader LLMs
PagedAttention, vLLM, Self-Debugging, PowerInfer en EG-MLA – hoe u LLM-agents kunt schalen zonder GPU KV-cache te verspillen
Op deze pagina
TenthMatrixover hoe u grote taalmodellen in productie een boost kunt geven: PagedAttention, vLLM, Self-Debugging, PowerInfer en EG-MLA - met de afwegingen die daadwerkelijk opduiken op GPU's. Diepe duik:lang artikel. Primer:LLMs uitgelegd + Kubernetes.
Kijk: wat een LLM eigenlijk is, is
Context, geen productdemo:Inleiding tot grote taalmodellen(Andrej Karpathy). Combineer met onzeeenvoudig-Engelse LLM + Kubernetes-gids.
Het schaalprobleem
LLMs ontgrendelde conversatie-AI en -generatie en werd toen onmiddellijk een serveerprobleem. Elke decoderingsstap voegt sleutels en waarden toe aan een KV-cache die groeit met de reekslengte en batchgrootte. Naïeve motoren reserveren enorme aaneengesloten platen vooraf. Het grootste deel van dat geheugen blijft inactief terwijl andere verzoeken wachten. De doorvoer stort in, ook al ziet de GPU er “vol” uit.
PagedAttention: virtueel geheugen voor aandacht
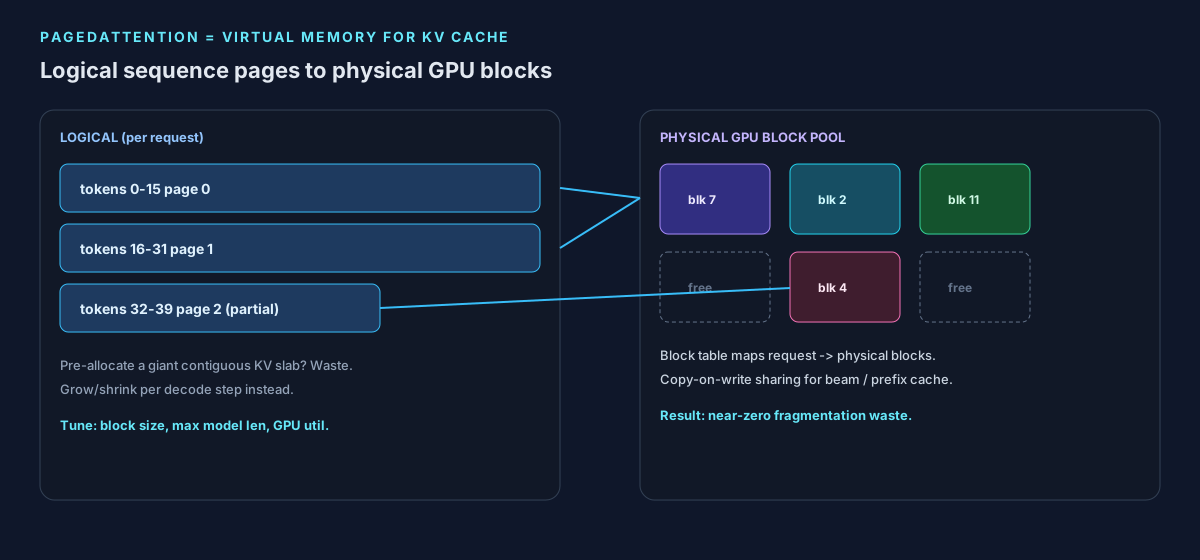
PagedAttention (Kwon et al., SOSP 2023) behandelt KV-cache zoals OS-paging: blokken met een vaste grootte, een bloktabel per verzoek, niet-aaneengesloten fysieke pagina's[arXiv:2309.06180]. De kernel verzamelt blokken op het moment van aandacht. U moet nog steeds de-blokgrootte,maximale modellengteen de-cachehiërarchie(GPU HBM versus CPU offload versus prefix-cache) afstemmen. Te kleine blokken voegen mapping-overhead toe; te grote blokken herintroduceren afval.
vLLM: bijna geen afval voor de
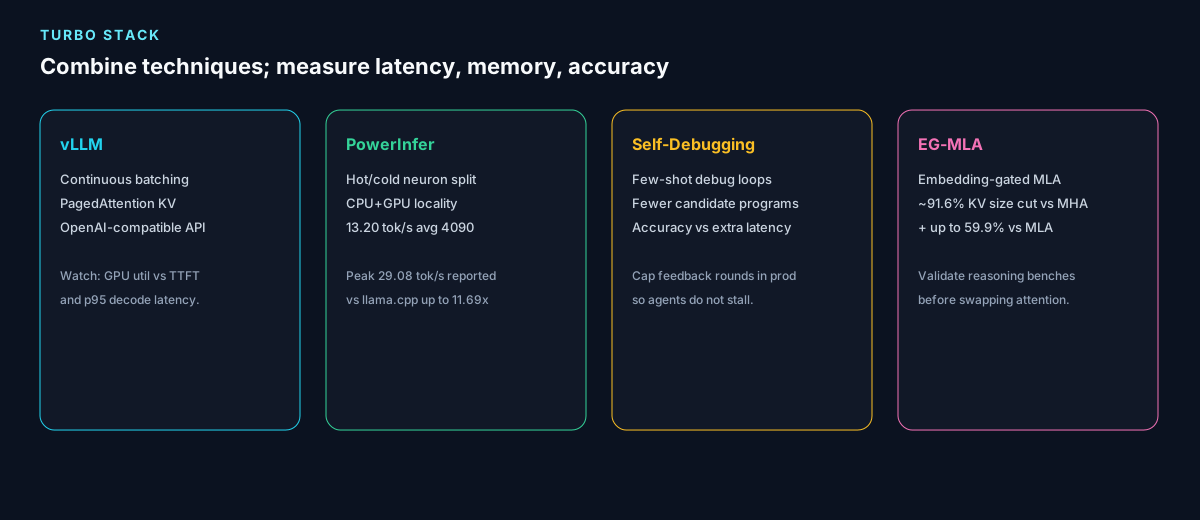
vLLM is het serveersysteem gebouwd rond PagedAttention. Het richt zich op vrijwel nul KV-afval, continue batching en een OpenAI-compatibel HTTP-oppervlak. Let tijdens de productie op drie dingen: (1)gpu_memory_utilizationversus OOM, (2) tijd tot eerste token versus decodeer tokens/s, (3) of prefix/prompt-caching de antwoorden voor uw evaluatieset verandert. Caching is een doorvoerwinst; het is niet vrij van correctheids- en staartlatentie-effecten.
from vllm import LLM, SamplingParams

llm = LLM(model="meta-llama/Llama-3.1-8B-Instruct", gpu_memory_utilization=0.90)
params = SamplingParams(temperature=0.2, max_tokens=256)
outs = llm.generate(["Explain PagedAttention in one paragraph."], params)
print(outs[0].outputs[0].text)
Dat is echt vLLM-gebruik. Een Hugging Face BERTforward()-oproep isen nietPagedAttention - verwar classifier-logits niet met paged KV-serving.
Self-Debugging: kwaliteitslussen met een latentiebudget
Self-Debugging (Chen et al.) leert een model zijn eigen voorspelde programma's te herstellen op basis van een paar sporen, waarbij basislijnen worden gematcht of verbeterd die 10x meer kandidaten uitzenden[arXiv:2304.05128]. Voor agenten is dat goud, totdat de feedbackrondes zich opstapelen. Beperk het aantal foutopsporingsberichten, registreer elke ronde en sluit niet af voor een menselijk of een kleiner specialistisch model als het budget op is.
Bekijk: context voor weergave en gevolgtrekking
Contextueel gesprek over snelle LLM-bediening - geen officiële Workstation-demo. Combineer met het vLLM-papier endocs.vllm.ai.
PowerInfer: tokens op een enkele dikke GPU
PowerInfer splitst warme/koude neuronen zodat een consument GPU plus CPU snel tokens kan genereren. Gerapporteerde cijfers:13,20 tokens/s gemiddeld, piek29,08 tokens/sop één NVIDIA RTX 4090, tot11,69xversus llama.cpp met behoud van nauwkeurigheid[PowerInfer]. Op vlootschaal heb je nog steeds plaatsing nodig: welke lagen blijven op GPU, hoe verdeel je over knooppunten en of het locatieprofiel vandat jevraagt overeenkomt met de modellen van het papier.
EG-MLA: verklein de KV zonder de bank
kapot te makenEG-MLA (embedding-gated latente aandacht met meerdere hoofden) rapporteertmeer dan 91,6% KV-cachereductieversus aandacht met meerdere hoofden met verwaarloosbare degradatie, extra besparingen versus MLA (tot 59,9%) en betere scores op redeneersuites, geschaald voorbij 1B-parameters[EG-MLA-papier]. Beschouw het als een architectuurkeuze, niet als een drop-in-vlag op een bevroren vLLM-controlepunt - valideer uw evaluatieharnas voordat u de geheugengrafiek viert.
In elkaar zetten
Combineer PagedAttention + vLLM voor clusterbediening, PowerInfer als de box een GPU-werkstation is, Self-Debugging in codeeragenten met een harde ronde limiet, en EG-MLA als u de modelfamilie beheert. Gedistribueerde weergave voegt complexiteit toe: KV-parallellisme, prefill/decode-split en automatisch schalen dat de paginatabellen niet vernietigt. Meeteenheid. Schrijf vervolgens het ADR.
Lees volgende
- Lang artikel— knoppen, foutmodi, Kubernetes-opmerkingen.
- LLMs uitgelegd + voer uw eigen uit op Kubernetes
- Muse Glimmer / lokale agenten·Enterprise AI Lab
Gepubliceerd doorTenthMatrix.
Meer van de blog

Observability Is Not Optional: Make It a Business Standard
Why fragmented monitoring creates blind spots, duplicate spend, and slow incidents — and how to make centralised observability a non-negotiable company standard.

WSL Vault for Compliance: One Tenant Never Opens Another’s Secrets
How WSL Vault keeps app, team, and environment tenants cryptographically isolated — so a stolen root-style token cannot empty the estate — and why dual-tenant control beats secrets sprawl.

Workstation AI Shop: Promoting the AI Sales Storefront Through int → test → acc → prod
Workstation AI Shop sells GPU machines with a fully autonomous AI Sales Agent that configures the basket. See how Ring Promoter moves each build through int → test → acc → prod — with Orbit screenshots release engineers and stakeholders share.