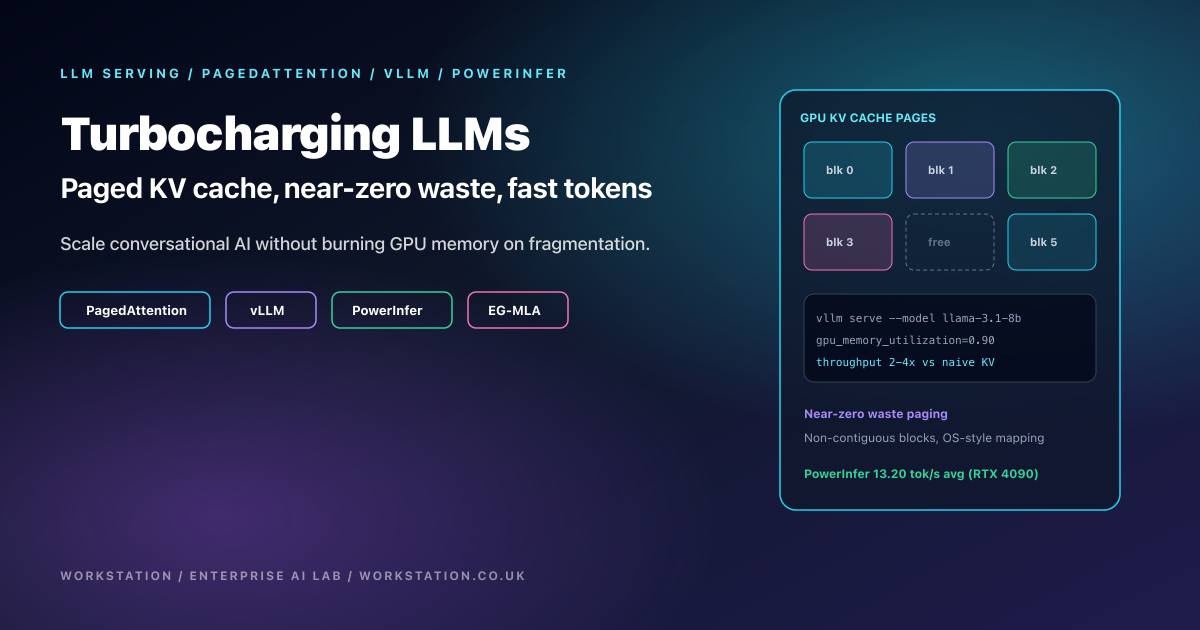
Turbolader LLMs
TenthMatrix op turbo-opladende LLMs: PagedAttention-paging voor KV-cache, vLLM-serving, Self-Debugging voor agenten, PowerInfer-tokensnelheden en EG-MLA-geheugenbesparingen - met productie-afwegingen.
Onderwerp
Berichten met tag GPU
TenthMatrix op turbo-opladende LLMs: PagedAttention-paging voor KV-cache, vLLM-serving, Self-Debugging voor agenten, PowerInfer-tokensnelheden en EG-MLA-geheugenbesparingen - met productie-afwegingen.
Wat zijn grote taalmodellen en hoe werken ze? Een duidelijke, niet-technische uitleg voor managers en technici – tokens, inbedding, transformatoren, training en gevolgtrekking – plus productie-Kubernetes YAML om uw eigen LLM te implementeren met Ollama en vLLM.