Blog
Descubriendo los cuellos de botella de LLM: observabilidad, OTEL y control de costos
Resumen empresarial: OpenTelemetry, Prometheus/Grafana, Langfuse: ventajas, desventajas, costos y métricas de uso que reducen el gasto de los agentes
En esta página
TenthMatrixResumen de negocios: descubra LLM y los cuellos de botella de los agentes con observabilidad (OpenTelemetry, Prometheus/Grafana/Thanos y plataformas LLM como Langfuse) para que pueda reducir costos, ajustar los SLO y enviar pruebas a los agentes. Análisis profundo: artículo técnico extenso de(OTEL, FinOps, presupuestos de agentes). Relacionado:Turbocompresor LLMs·Enterprise AI Lab.
Por qué los cuellos de botella se esconden sin telemetría
Los agentes LLM encadenan mensajes, herramientas, recuperación y reintentos de RAG. La latencia y el gasto se componen entre saltos. Sin intervalos y métricas no se puede saber si el cuello de botella es el modelo, el almacén de vectores, una herramienta deficiente o un bucle de autodepuración ilimitado. Luego, las partes interesadas del negocio compran en exceso las cuotas de GPU o API, mientras que la calidad del producto se mantiene estable.
Postura deTenthMatrix para los activos de IA: trate las canalizaciones de agentes como cualquier otro servicio de producción:observabilidad primero, luego optimice el servicio (consultePagedAttention / vLLM), luego promueva con disciplina (Ring Promoter).
La pila de observabilidad que se amortiza sola
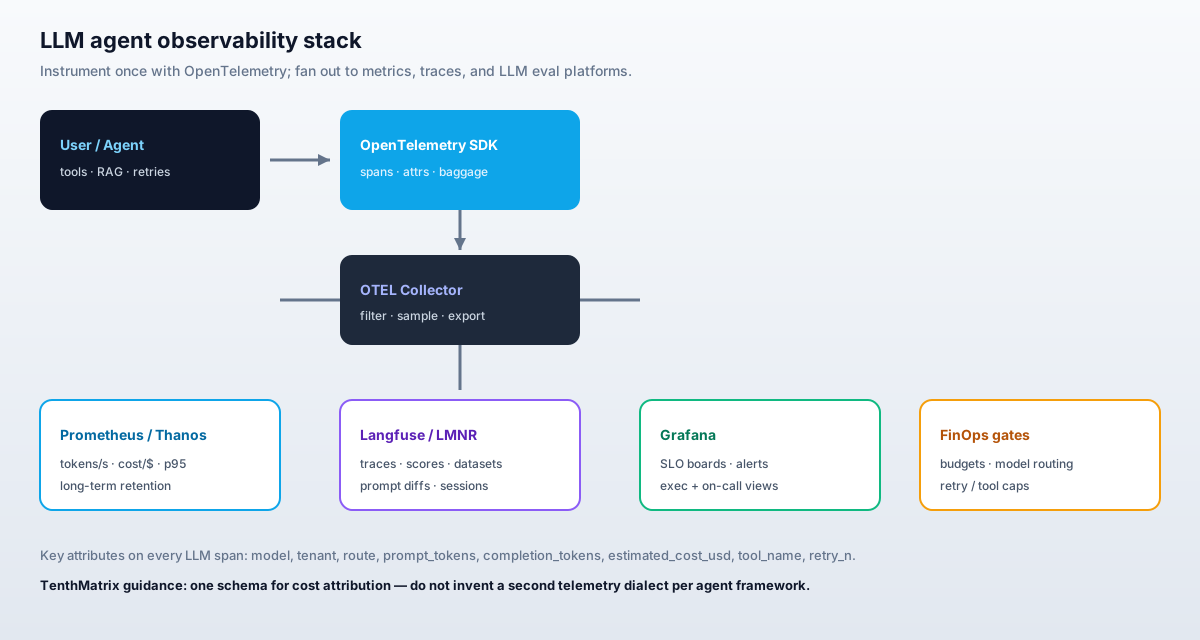
- OpenTelemetry (OTEL): una capa de instrumentación para seguimientos, métricas y (cuando sea útil) registros. Exportar a un coleccionista; desplegarse hacia los backends.
- Prometheus + Grafana (+ Thanos): señales doradas: tasa de solicitudes, tasa de errores, latencia, rendimiento del token, $ estimado/solicitud, utilización de GPU. Thanos (o equivalente) mantiene métricas a largo plazo para las revisiones de FinOps.
- LLM Plataformas de observabilidad(p. ej.Langfuse,LMNR) — UI de sesión/rastreo, versiones de aviso, humanos y humanos. puntuaciones automatizadas, conjuntos de datos para regresión.
Pros y contras de este enfoque
| Dimensión | Ventajas | Contras / compensaciones |
|---|---|---|
| Control de costes | Gasto de atributo al inquilino, característica, modelo y paso del agente; eliminar los reintentos inútiles. | Tiempo de ingeniería para instrumentar; Costo de almacenamiento de rastros si la retención es ingenua. |
| Calidad | Los conjuntos de datos y puntuacionesdetectan regresiones rápidas antes que los clientes. | La puntuación automatizada puede ser ruidosa; todavía se necesitan humanos para rutas críticas. |
| Operaciones | El mismo conjunto de habilidades de OTEL/Prometheus que sus otros microservicios. | Las UI específicas deLLM (Langfuse, etc.) agregan otro producto para ejecutar o comprar. |
| Cumplimiento | Auditoría de quién llamó a qué modelo y con qué versión de aviso. | Las políticas de retención de información/PII deben diseñarse por adelantado. |
| Velocidad a valor | Primeros paneles en días si ya ejecuta Grafana. | La atribución total de costos en gráficos de múltiples agentes lleva más tiempo. |
Costos: lo que gastas vs lo que ahorras
Costo de instrumentación (plataforma típica de agente de tamaño mediano):
- 1 a 2 semanas de ingeniero para adoptar las convenciones de tramo de OTEL + cableado del exportador.
- Collector + retención de métricas: a menudo <5–10 % del gasto mensual de LLM API/GPU una vez que se ajusta el muestreo.
- Observabilidad SaaS LLM opcional: precio por evento/rastreo: presupuesto como porcentaje del gasto del modelo, no como una ocurrencia tardía.
Palancas de ahorro (métricas de uso que mueven la aguja):
- Tokens por tarea exitosa: no tokens por llamada sin formato. Tapar bucles de herramientas y rondas de autodepuración.
- Costo por tarea exitosa— modelos de ruta económicos para clasificación/ruta; reserve los modelos de frontera para pasos difíciles.
- Tasa de aciertos de caché: almacenamiento en caché de avisos/prefijos cuando sea seguro; medir la corrección, no sólo la latencia.
- Tasa de reintento y frecuencia tasa de mensajes fallidos: herramientas inestables disfrazadas de problemas de “calidad del modelo”.
- p95 TTFT y latencia de extremo a extremo: proteja la experiencia de usuario mientras reduce el gasto.
: manual vs automática
| Método | Cuándo utilizar | Nota comercial |
|---|---|---|
| Puntuación manual | Conjuntos Gold, respuestas reguladas, copia sensible a la marca. | Jueces automatizados, caros pero fundamentados. |
| Puntuación automática | Regresión de alto volumen, LLM como juez, verificaciones de rúbricas. | Barato a escala; calibrar contra humanos mensualmente. |
Guía de migración (comience poco a poco)
- InstrumentoUna ruta de agente de producciónde extremo a extremo con OTEL + atributos de token/costo.
- Envíe una placa Grafana para tasa/errores/latencia/$/éxito.
- Agregue Langfuse (o equivalente) para obtener versiones rápidas y puntuaciones en esa ruta.
- Aplicar límites máximos: tokens máximos, llamadas de herramientas máximas, reintentos máximos por sesión.
- Expandir al siguiente agente solo después de que la primera ruta muestre un costo medido o una ganancia de latencia.
Watch: por qué la observabilidad es importante para los sistemas de IA
Charla contextual sobre la cultura de la observabilidad, no una demostración del producto TenthMatrix. Combínelo conOpenTelemetry docsy el artículo técnicoTenthMatrix.
Leer siguiente
- Artículo extenso: esquema de extensión de OTEL, coleccionistas, fórmulas de costos, límites de agentes, notas de Langfuse/LMNR.
- Turbocompresor LLMs: cuellos de botella en el lado del servicio después de que puedas verlos.
- Agentes locales·Laboratorio de IA empresarial·Contacto TenthMatrix
Publicado porTenthMatrix. Referencias:langfuse/langfuse·lmnr-ai/lmnr·OpenTelemetry.
Más del blog

Observability Is Not Optional: Make It a Business Standard
Why fragmented monitoring creates blind spots, duplicate spend, and slow incidents — and how to make centralised observability a non-negotiable company standard.

WSL Vault for Compliance: One Tenant Never Opens Another’s Secrets
How WSL Vault keeps app, team, and environment tenants cryptographically isolated — so a stolen root-style token cannot empty the estate — and why dual-tenant control beats secrets sprawl.

Workstation AI Shop: Promoting the AI Sales Storefront Through int → test → acc → prod
Workstation AI Shop sells GPU machines with a fully autonomous AI Sales Agent that configures the basket. See how Ring Promoter moves each build through int → test → acc → prod — with Orbit screenshots release engineers and stakeholders share.