Artículo
Upgrade rolling de Couchbase Server bajo CAO (ritmo + puerta de pausa)
Runbook copiar/pegar para soporte y equipos SRE: preflight, swap-rebalance nodo a nodo, estrategia XDCR, disparadores de rollback y comprobaciones de cierre
En esta página
Los upgrades son donde se demuestra o se rompe la fiabilidad de la base de datos. Este artículo ofrece un runbook ritmado y amigable para soporte para actualizar Couchbase Server bajo el Couchbase Autonomous Operator (CAO), usando el campo nativo spec.paused para controlar el progreso entre nodos. Resultado: un nodo a la vez, ventana de estabilización entre swaps, señales más claras y una ventana de rollback mayor.
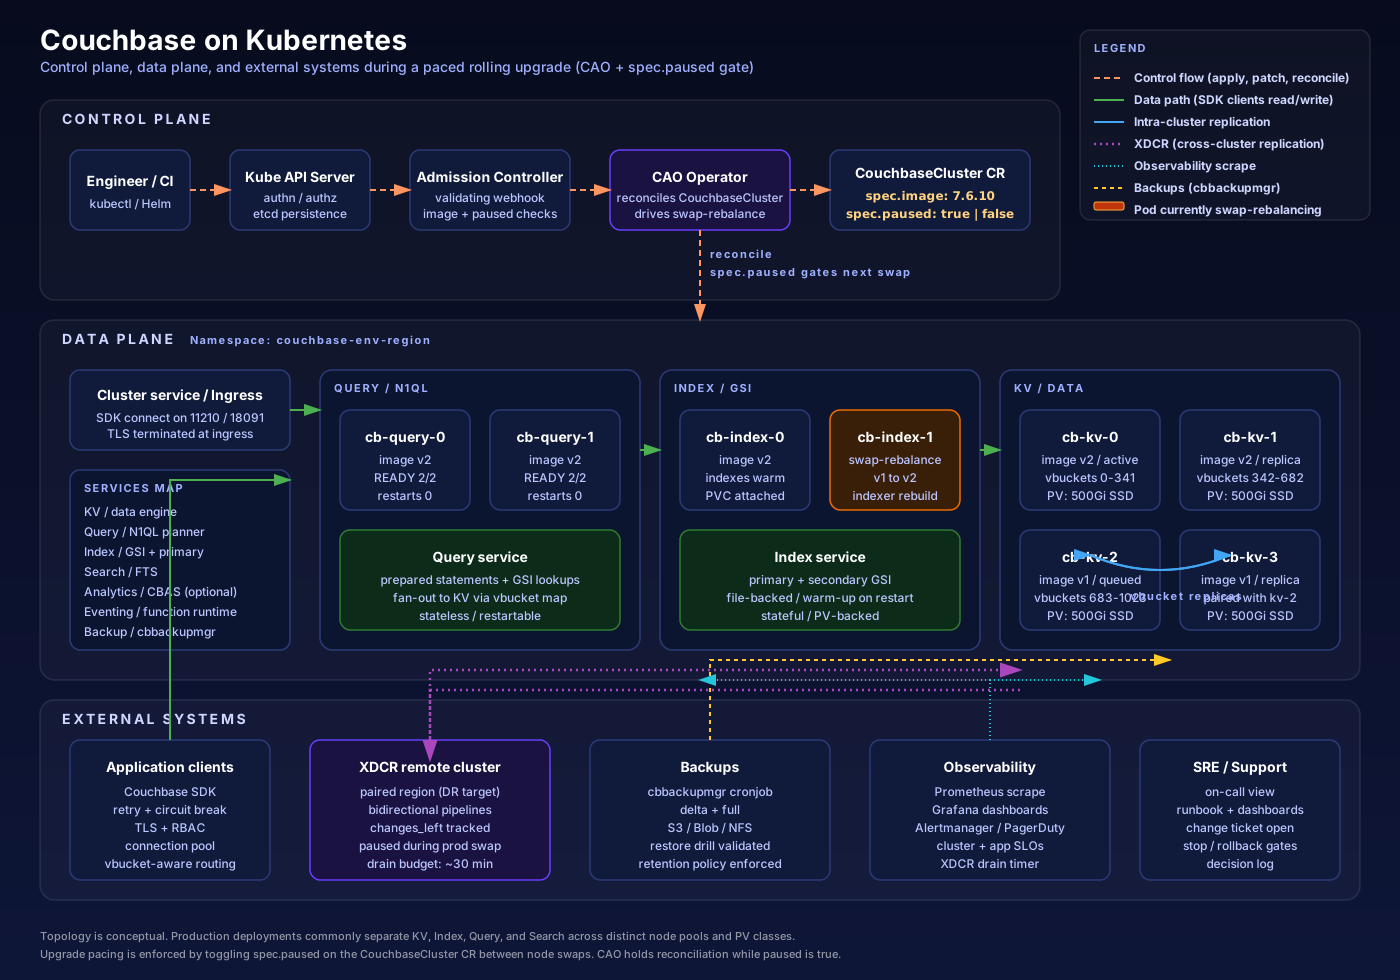
Topología de referencia
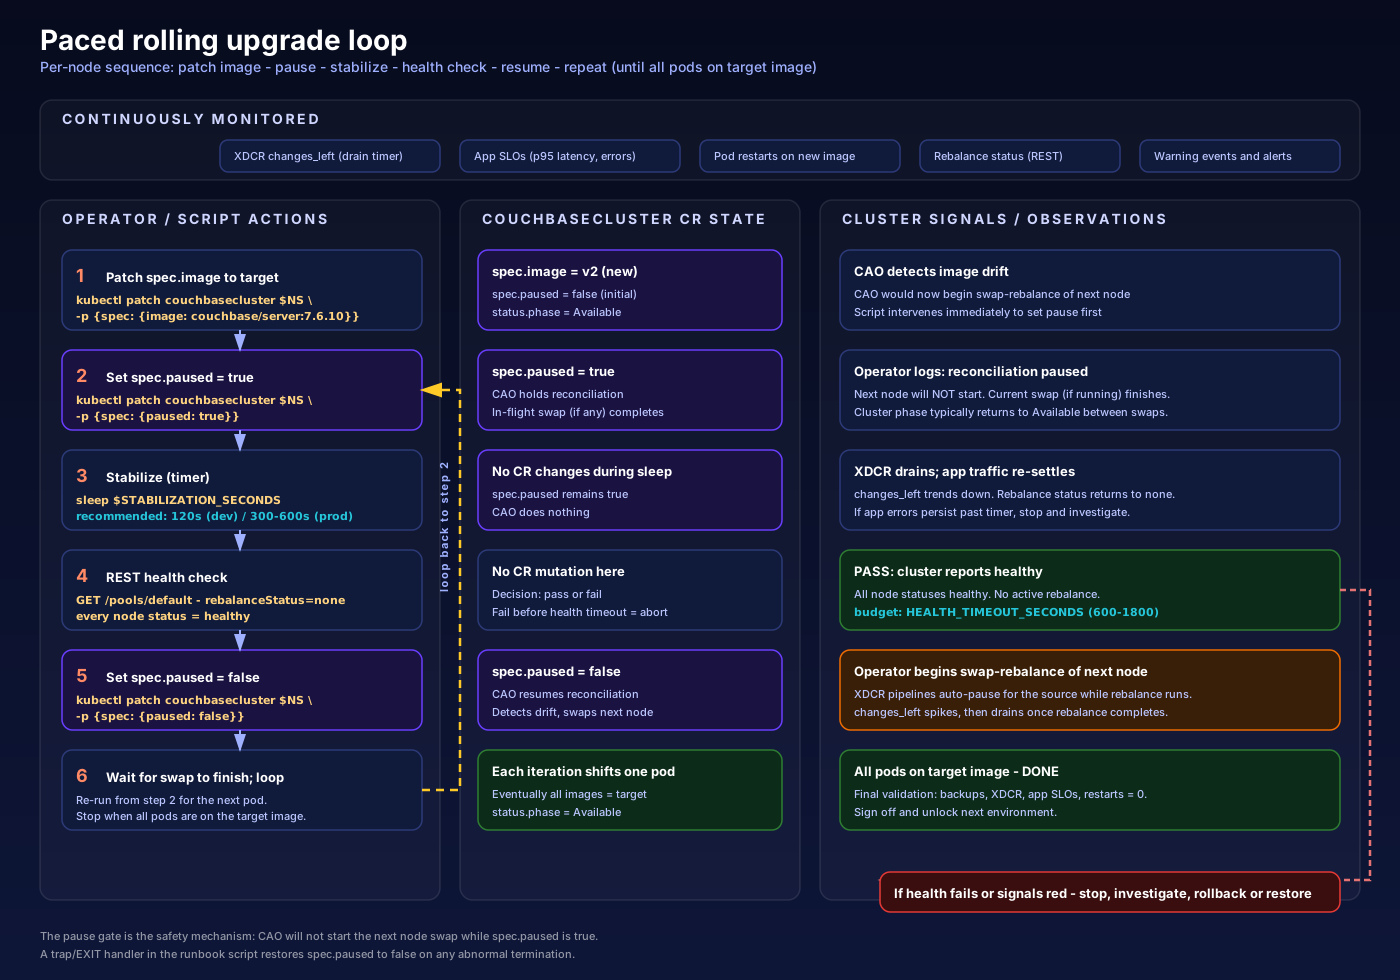
El bucle de upgrade ritmado
Objetivos
- Actualizar Couchbase Server con riesgo mínimo.
- Mantener una ventana deliberada de pausa + estabilizar + comprobación de salud entre nodos.
- Conservar opciones de rollback el mayor tiempo práctico.
Lista previa al upgrade (no omitir)
- Todo en verde: fase del clúster
Available, sin rebalance activo, sin eventos de advertencia. - Backups actuales y restaurables: backup completo terminado; drill de restore hecho o tiempo entendido.
- Etiqueta de rollback registrada: verificar que la imagen antigua aún existe y se puede tirar.
- Decisión XDCR registrada: desactivar durante upgrades de prod para señal limpia (recomendado), o mantener en pre-prod para ejercitar el comportamiento.
Comandos rápidos de verificación
export ENV=dev
export REGION=west
export NS=couchbase-${ENV}-${REGION}

kubectl -n "$NS" get couchbasecluster -o wide
kubectl -n "$NS" get pods -l app=couchbase
kubectl -n "$NS" get events --field-selector type=Warning | tail -20
kubectl -n "$NS" get couchbasecluster "$NS" -o jsonpath='paused={.spec.paused} phase={.status.phase} rebalance={.status.rebalanceProgress}{"\n"}'
Rutas de ejecución
- Preferida: ejecutar el upgrade desde su workflow de CI (dry-run primero, luego ejecución real).
- Alternativa: ejecutar el script de upgrade ritmado desde una workstation (dry-run primero, luego real).
Señales de monitorización (qué debe vigilar soporte)
- Imágenes de pods: paso de antigua → nueva; un swap a la vez es ideal.
- Estado de pausa:
spec.pausedpasa a true durante la estabilización; nunca dejarlo true sin atención. - Rebalance: vuelve a none entre swaps; investigar rebalances persistentes.
- XDCR:
changes_leftsube durante el rebalance y drena en estabilización; no drenar es señal de incidente. - Reinicios: cualquier reinicio inesperado post-swap es bandera roja.
Disparadores de rollback
- El nodo no se pone sano dentro de la ventana de timeout.
- El rebalance falla y no se resuelve con un solo reintento tras investigación.
- La tasa de error de la aplicación supera la tolerancia acordada.
- XDCR no se recupera tras la ventana de recuperación acordada.
- Cualquier bucket no disponible (vbuckets faltantes) — tratar como P1.
Validación post-upgrade (cierre)
- Todos los pods en la imagen objetivo
- Fase del clúster
Available - Sin nuevos eventos de advertencia durante 30+ minutos
- Backup exitoso tras el upgrade
- XDCR en estado estable recuperado (si se usa)
- Dashboards de aplicación en verde durante 30+ minutos
Consejo: Si quiere primero una versión narrativa más corta, empiece por el resumen del blog: Upgrades de Couchbase con puertas de pausa CAO.
Más artículos técnicos

Big Prometheus at Scale: Pros, Cons, and a MoSCoW Map of Observability Tools
TenthMatrix rewrite of the Big Prometheus problem space: Thanos, Cortex/Mimir, VictoriaMetrics, M3/Chronosphere — plus MoSCoW across OTEL, Grafana, SaaS APM and more

WSL Vault Technical Deep Dive: Zero-Trust Secrets, Dual Control, MFA & Multi-Region HA
Technical deep dive: envelope hierarchy, dual-control workflows, MFA, leases, active/active multi-region HA, feature tours, and presentation chapters

Workstation AI Shop on Ring Promoter: Orbit, Version-Verified Health and the Path from INT to PROD
Technical guide: shop Helm/CI mapping, Orbit semantics, version-verified health for the AI agent, secrets per ring, promote API, and a production checklist