บล็อก
การปรับขนาดโครงสร้างพื้นฐานด้วย Kubernetes และ RKE2: การเจาะลึกการผลิต
คู่มือวิศวกรฝ่ายผลิตเกี่ยวกับสถาปัตยกรรมคลัสเตอร์ RKE2 การปรับขนาดอัตโนมัติแนวนอนและแนวตั้ง ความพร้อมใช้งานสูง การกำกับดูแลทรัพยากร และความสามารถในการสังเกต Prometheus/Grafana
ในหน้านี้
การรันคลัสเตอร์ Kubernetes ในการผลิตถือเป็นเรื่องหนึ่ง การดำเนินการที่สามารถดูดซับการจราจรที่พุ่งสูงขึ้นอย่างไม่อาจคาดเดาได้ รอดพ้นจากความล้มเหลวของเครื่องบินควบคุม บังคับใช้การแยกผู้เช่า และช่วยให้ทีมปฏิบัติการของคุณมองเห็นได้ชัดเจนในทุกชั้นของระบบ ซึ่งเป็นความท้าทายที่แตกต่างไปจากเดิมอย่างสิ้นเชิง RKE2 ซึ่งเป็นระบบกระจาย Kubernetes รุ่นใหม่ของ Rancher สร้างขึ้นโดยเฉพาะสำหรับสภาพแวดล้อมที่ข้อกำหนดเหล่านั้นไม่สามารถต่อรองได้
บทความนี้ทำงานตลอดวงจรการใช้งานเต็มรูปแบบของการปรับใช้ RKE2 ระดับการผลิต: สถาปัตยกรรมคลัสเตอร์เริ่มต้น การปรับขนาดอัตโนมัติที่ระดับพ็อดและโหนด ระนาบควบคุมความพร้อมใช้งานสูง การกำกับดูแลทรัพยากร และความสามารถในการสังเกตด้วย Prometheus และ Grafana
ทำไมต้อง RKE2?
RKE2 สร้างความแตกต่างจากอัปสตรีม Kubernetes และจาก RKE1 รุ่นก่อนในสามประเด็นหลัก ประการแรก มาพร้อมกับการกำหนดค่ามาตรฐาน CIS Kubernetes ที่เสริมความแข็งแกร่งด้วยมาตรฐานตั้งแต่แกะกล่อง — ตัวควบคุมการรับเข้า การบันทึกการตรวจสอบ ความปลอดภัยของพ็อด และการตั้งค่า TLS ได้รับการกำหนดค่าไว้ล่วงหน้าเพื่อให้ผ่านการสแกน CIS ระดับ 1 โดยไม่มีการแทรกแซงด้วยตนเอง ประการที่สอง เป็นไปตามมาตรฐาน FIPS 140-2 ทำให้เหมาะสำหรับการใช้งานภาครัฐและอุตสาหกรรมที่ได้รับการควบคุม ประการที่สาม ฝังคอนเทนเนอร์โดยตรงและจัดส่งด้วย CNI ของตัวเอง (Canal หรือ Cilium ขึ้นอยู่กับตัวเลือกการกำหนดค่าของคุณ) ช่วยลดพื้นที่ผิวของการพึ่งพาภายนอกที่คุณต้องจัดการ
RKE2 ยังเป็นมิตรกับช่องว่างอากาศอีกด้วย ชุดการติดตั้งประกอบด้วยคอนเทนเนอร์อิมเมจที่จำเป็นทั้งหมด ซึ่งมีความสำคัญอย่างมากในการปรับใช้ภายในองค์กรและ Edge ซึ่งการเข้าถึงอินเทอร์เน็ตจากโหนดคลัสเตอร์ถูกจำกัดหรือเป็นไปไม่ได้
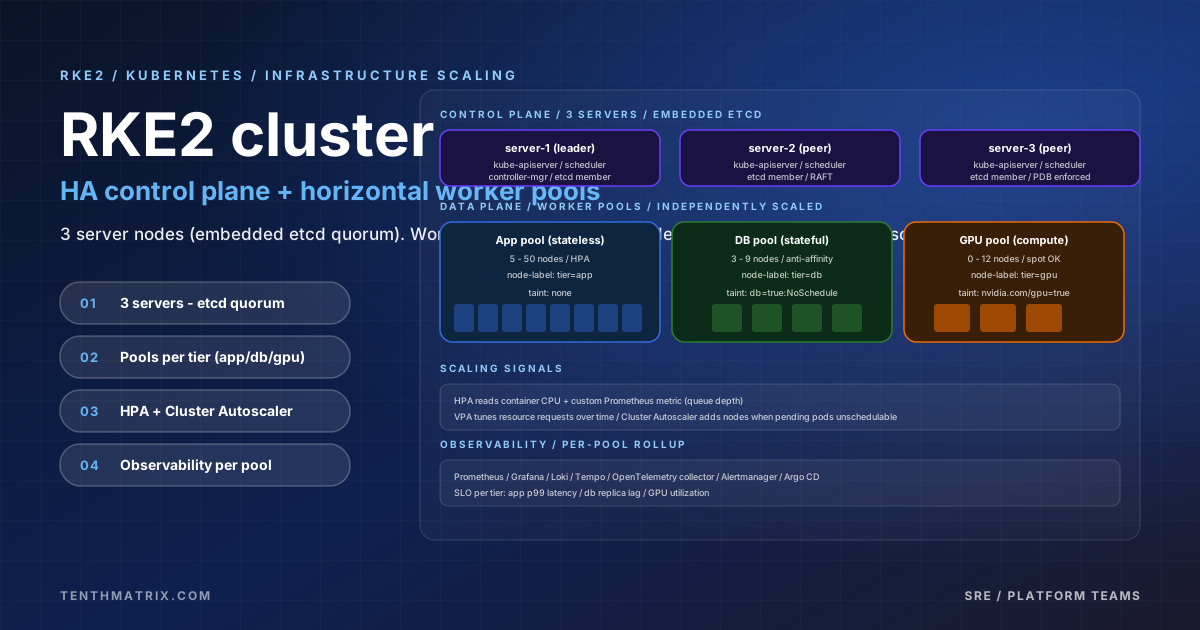
สถาปัตยกรรมคลัสเตอร์คลัสเตอร์ RKE2 ที่ใช้งานจริงแบ่งออกเป็นโหนดเซิร์ฟเวอร์ (ซึ่งรันระนาบควบคุมและอื่นๆ) และโหนดเอเจนต์ (ซึ่งรันเวิร์กโหลด) โทโพโลยีที่แนะนำสำหรับความพร้อมใช้งานสูงคือโหนดเซิร์ฟเวอร์สามหรือห้าโหนด และจำนวนโหนดเอเจนต์ที่เปลี่ยนแปลงได้ซึ่งจัดเป็น Node Pool ตามคลาสเวิร์กโหลด
# /etc/rancher/rke2/config.yaml (server node)
token: <shared-cluster-token>
tls-san:
  - 10.0.0.10          # VIP or load balancer address
  - k8s.internal.example.com
cni: cilium
cluster-cidr: 10.42.0.0/16
service-cidr: 10.43.0.0/16
etcd-expose-metrics: true
kube-apiserver-arg:
  - "audit-log-path=/var/log/kubernetes/audit.log"
  - "audit-log-maxage=30"
  - "audit-log-maxsize=100"
# /etc/rancher/rke2/config.yaml (agent node)
server: https://10.0.0.10:9345
token: <shared-cluster-token>
node-label:
- "workload-class=general"
- "topology.kubernetes.io/zone=eu-west-1a"ติดตั้งเซิร์ฟเวอร์บนโหนดควบคุมแรกของคุณ จากนั้นเข้าร่วมโหนดเซิร์ฟเวอร์ที่เหลือและโหนดเอเจนต์ทั้งหมดโดยใช้โทเค็นและที่อยู่ VIP เดียวกัน RKE2 เลือกผู้นำ ฯลฯ โดยอัตโนมัติและจัดการองค์ประชุม
# Install and start RKE2 server
curl -sfL https://get.rke2.io | INSTALL_RKE2_TYPE=server sh -
systemctl enable --now rke2-server.service

# Retrieve the node token for joining additional nodes
cat /var/lib/rancher/rke2/server/node-token

# Install and start RKE2 agent (on worker nodes)
curl -sfL https://get.rke2.io | INSTALL_RKE2_TYPE=agent sh -
systemctl enable --now rke2-agent.service
Node Pools และการวางตำแหน่งภาระงาน
ไม่ใช่ทุกเวิร์กโหลดที่มีโปรไฟล์ทรัพยากรเหมือนกัน บริการเว็บแบบไร้สถานะมีข้อกำหนดที่แตกต่างจากงานการอนุมาน GPU ปริมาณงานการวิเคราะห์ที่ใช้หน่วยความจำมาก หรือฐานข้อมูลที่ไวต่อความหน่วง การจัดระเบียบโหนดเอเจนต์ลงในพูลที่มีป้ายกำกับและเทนต์ที่แตกต่างกันทำให้ Kubernetes กำหนดเวลาแต่ละคลาสภาระงานบนฮาร์ดแวร์ที่มีขนาดเหมาะสมได้
# Label a node pool for memory-intensive workloads
kubectl label nodes worker-mem-{1..4} workload-class=memory-optimised
kubectl taint nodes worker-mem-{1..4} workload-class=memory-optimised:NoSchedule

# Label a separate pool for general compute
kubectl label nodes worker-gen-{1..8} workload-class=general
# Deployment targeting the memory-optimised pool
apiVersion: apps/v1
kind: Deployment
metadata:
name: analytics-engine
spec:
template:
spec:
nodeSelector:
workload-class: memory-optimised
tolerations:
- key: workload-class
operator: Equal
value: memory-optimised
effect: NoSchedule
containers:
- name: analytics
image: registry.internal/analytics:v2.3.1
resources:
requests:
memory: "8Gi"
cpu: "2"
limits:
memory: "16Gi"
cpu: "4"เครื่องปรับขนาดพ็อดแนวนอนอัตโนมัติ
เครื่องปรับขนาดอัตโนมัติพ็อดแนวนอน (HPA) ปรับจำนวนเรพลิกาของ Deployment หรือ StatefulSet ตามตัววัดที่สังเกตได้ การใช้งาน CPU เป็นตัวกระตุ้นแบบคลาสสิก แต่การกำหนดค่า HPA สมัยใหม่ยังสามารถปรับขนาดตัววัดแบบกำหนดเองที่เปิดเผยโดยแอปพลิเคชันของคุณหรือตัววัดภายนอกจากแหล่งที่มา เช่น ความลึกของคิวข้อความ
ขั้นแรก ตรวจสอบให้แน่ใจว่าเซิร์ฟเวอร์เมตริกทำงานอยู่ — RKE2 ไม่ได้รวมกลุ่มไว้ตามค่าเริ่มต้น
kubectl apply -f https://github.com/kubernetes-sigs/metrics-server/releases/latest/download/components.yamlapiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
name: api-server-hpa
namespace: production
spec:
scaleTargetRef:
apiVersion: apps/v1
kind: Deployment
name: api-server
minReplicas: 3
maxReplicas: 20
metrics:
- type: Resource
resource:
name: cpu
target:
type: Utilization
averageUtilization: 65
- type: Resource
resource:
name: memory
target:
type: Utilization
averageUtilization: 70
behavior:
scaleDown:
stabilizationWindowSeconds: 300 # wait 5 minutes before scaling down
policies:
- type: Percent
value: 25
periodSeconds: 60
scaleUp:
stabilizationWindowSeconds: 0
policies:
- type: Percent
value: 100
periodSeconds: 30บล็อกbehaviorมีความสำคัญอย่างยิ่งต่อความเสถียร หากไม่มีกรอบเวลาการรักษาเสถียรภาพที่ลดขนาดลง ปริมาณการรับส่งข้อมูลที่ลดลงในช่วงสั้นๆ จะนำพ็อดออกก่อนเวลาอันควร ทำให้คุณจัดสรรไม่เพียงพอเมื่อโหลดกลับมา นโยบายที่ไม่สมมาตร — การขยายขนาดเชิงรุก การลดขนาดแบบอนุรักษ์นิยม — เป็นค่าเริ่มต้นที่เหมาะสมสำหรับปริมาณงานการผลิตส่วนใหญ่
เครื่องปรับขนาดอัตโนมัติพ็อดแนวตั้ง
Vertical Pod Autoscaler (VPA) ปรับขนาดที่เหมาะสมให้กับ CPU และคำขอหน่วยความจำบนพ็อดแต่ละรายการตามการใช้งานที่สังเกตได้ โดยจะแก้ไขปัญหาทั่วไป: นักพัฒนาตั้งค่าคำขอทรัพยากรเริ่มแรกโดยยึดตามการคาดเดา และค่าเหล่านั้นจะไม่ได้รับการอัปเดต ซึ่งนำไปสู่การจัดสรรทรัพยากรมากเกินไปอย่างสิ้นเปลืองหรือพ็อด OOMKilled ที่กำลังโหลด
apiVersion: autoscaling.k8s.io/v1
kind: VerticalPodAutoscaler
metadata:
  name: worker-vpa
  namespace: production
spec:
  targetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: background-worker
  updatePolicy:
    updateMode: "Auto"     # or "Off" to only view recommendations
  resourcePolicy:
    containerPolicies:
      - containerName: worker
        minAllowed:
          cpu: 100m
          memory: 256Mi
        maxAllowed:
          cpu: 4
          memory: 8Gi
        controlledResources: ["cpu", "memory"]
โปรดทราบว่า VPA ในโหมดAutoจะไล่ออกและรีสตาร์ทพ็อดเพื่อใช้ค่าทรัพยากรใหม่ สำหรับบริการที่ไม่สามารถขัดจังหวะคำขอในเที่ยวบินได้ ให้เรียกใช้ VPA ในโหมดOffเพื่อสร้างคำแนะนำที่คุณใช้ด้วยตนเองหรือผ่านเวิร์กโฟลว์ GitOps ในระหว่างช่วงเวลาการบำรุงรักษา
ข้อสำคัญ:HPA และ VPA ไม่ควรจัดการทรัพยากรเดียวกัน (CPU หรือหน่วยความจำ) ในการปรับใช้เดียวกันพร้อมกัน ใช้ HPA สำหรับการปรับขนาดแนวนอนที่ขับเคลื่อนด้วย CPU และ VPA ในโหมดOffสำหรับการปรับขนาดหน่วยความจำที่เหมาะสม หรือใช้KEDAสำหรับการปรับขนาดที่ขับเคลื่อนด้วยเหตุการณ์ ซึ่งจำเป็นต้องมีการควบคุมแบบละเอียด
ตัวปรับขนาดคลัสเตอร์อัตโนมัติ
ตัวปรับขนาดอัตโนมัติของPod ทำงานภายในความจุของโหนดที่มีอยู่ เมื่อความจุนั้นหมด — พ็อดติดอยู่ในPendingเนื่องจากไม่มีโหนดใดมีทรัพยากรเพียงพอ — คุณต้องมี Cluster Autoscaler เพื่อจัดเตรียมโหนดใหม่ ในทางกลับกัน เมื่อโหนดมีการใช้งานน้อยเกินไปอย่างมาก Cluster Autoscaler สามารถระบายและเลิกใช้งานโหนดเหล่านั้นเพื่อลดต้นทุนโครงสร้างพื้นฐาน
ในการปรับใช้แบบ Bare Metal หรือในองค์กร Cluster Autoscaler จะผสานรวมกับเลเยอร์การจัดเตรียมโครงสร้างพื้นฐานของคุณ สำหรับการปรับใช้บนคลาวด์ ผู้ให้บริการ เช่น AWS, GCP และ Azure เสนอการผสานรวมกลุ่มโหนดดั้งเดิม ตัวอย่างต่อไปนี้แสดงการกำหนดค่าหลักสำหรับ AWS Auto Scaling Group
apiVersion: apps/v1
kind: Deployment
metadata:
  name: cluster-autoscaler
  namespace: kube-system
spec:
  template:
    spec:
      containers:
        - name: cluster-autoscaler
          image: registry.k8s.io/autoscaling/cluster-autoscaler:v1.29.0
          command:
            - ./cluster-autoscaler
            - --cloud-provider=aws
            - --nodes=2:10:k8s-general-worker-asg
            - --nodes=1:4:k8s-memory-worker-asg
            - --scale-down-delay-after-add=10m
            - --scale-down-unneeded-time=10m
            - --scale-down-utilization-threshold=0.5
            - --skip-nodes-with-local-storage=false
            - --expander=least-waste
          env:
            - name: AWS_REGION
value: eu-west-1ตัวเลือก--expander=least-wasteบอกให้ตัวปรับขนาดอัตโนมัติเลือกกลุ่มโหนดที่จะมีทรัพยากรที่ไม่ได้ใช้น้อยที่สุดหลังจากรองรับพ็อดที่รอดำเนินการ ซึ่งจะช่วยลดต้นทุนให้เหลือน้อยที่สุด ตัวขยายทางเลือก ได้แก่random,most-podsและpriority
ระนาบควบคุมความพร้อมใช้งานสูง
ระนาบควบคุมแบบ 3 โหนดที่มีการฝัง ฯลฯ เป็นโทโพโลยี HA ขั้นต่ำที่ใช้งานได้ ฯลฯd ต้องการองค์ประชุม — สมาชิกส่วนใหญ่จะต้องมีสุขภาพที่ดีเพื่อให้คลัสเตอร์ยอมรับการเขียน ด้วยสมาชิกสามคน คุณสามารถทนต่อความล้มเหลวเพียงครั้งเดียวได้ มีสมาชิกห้าคนคุณสามารถทนสองคนได้
โหนดระนาบควบคุมต้องอยู่ด้านหลังโหลดบาลานเซอร์ สำหรับการปรับใช้บนคลาวด์ TCP load balancer ที่กำหนดเป้าหมายพอร์ต 6443 (kube-apiserver) และ 9345 (การลงทะเบียน RKE2) ทำงานได้ดี การใช้งานภายในองค์กรมักใช้ Keepalived กับที่อยู่ IP เสมือน
# keepalived.conf on control-plane nodes
vrrp_instance VI_1 {
    state MASTER        # BACKUP on the other two nodes
    interface eth0
    virtual_router_id 51
    priority 100        # 90 and 80 on the other two nodes
    advert_int 1
    authentication {
        auth_type PASS
        auth_pass securepassword
    }
    virtual_ipaddress {
        10.0.0.10/24    # VIP used in tls-san and agent server address
    }
}
ตรวจสอบว่า ฯลฯ มีประสิทธิภาพดีหลังจากการดำเนินการบนระนาบควบคุมใดๆ RKE2 รวมetcdctlที่/var/lib/rancher/rke2/bin/etcdctl
ETCDCTL_API=3 /var/lib/rancher/rke2/bin/etcdctl \
  --endpoints=https://127.0.0.1:2379 \
  --cacert=/var/lib/rancher/rke2/server/tls/etcd/server-ca.crt \
  --cert=/var/lib/rancher/rke2/server/tls/etcd/client.crt \
  --key=/var/lib/rancher/rke2/server/tls/etcd/client.key \
endpoint health --clusterและช่วงขีดจำกัด
ในคลัสเตอร์ที่มีผู้เช่าหลายราย — ที่ทีมหรือแอปพลิเคชันที่แตกต่างกันใช้โครงสร้างพื้นฐานทางกายภาพเดียวกัน — ResourceQuotas และ LimitRanges ถือเป็นรั้วที่จำเป็น ResourceQuotas ตั้งค่าฮาร์ดแคปในการใช้ทรัพยากรทั้งหมดภายในเนมสเปซ LimitRanges จะตั้งค่าเริ่มต้นและค่าสูงสุดสำหรับแต่ละคอนเทนเนอร์ เพื่อป้องกันไม่ให้การปรับใช้ที่กำหนดค่าไม่ถูกต้องร้องขอทรัพยากรที่ไม่จำกัด
apiVersion: v1
kind: ResourceQuota
metadata:
  name: team-alpha-quota
  namespace: team-alpha
spec:
  hard:
    requests.cpu: "20"
    requests.memory: 40Gi
    limits.cpu: "40"
    limits.memory: 80Gi
    count/deployments.apps: "20"
    count/services: "15"
    persistentvolumeclaims: "10"
    requests.storage: 500Gi
apiVersion: v1
kind: LimitRange
metadata:
name: team-alpha-limits
namespace: team-alpha
spec:
limits:
- type: Container
default:
cpu: 500m
memory: 512Mi
defaultRequest:
cpu: 100m
memory: 128Mi
max:
cpu: "8"
memory: 16Gi
- type: PersistentVolumeClaim
max:
storage: 100GiLimitRanges ช่วยให้แน่ใจว่านักพัฒนาที่ลืมระบุคำขอทรัพยากรจะยังคงได้รับค่าเริ่มต้นที่สมเหตุสมผล แทนที่จะขอ CPU เป็นศูนย์ ซึ่งจะทำให้ตัวกำหนดเวลาวางพ็อดไว้ที่ใดก็ได้และอาจทำให้ภาระงานอื่นๆ อดอยากบนโหนดเดียวกัน
การตรวจสอบด้วย Prometheus และ Grafana
ความสามารถในการสังเกตในคลัสเตอร์ Kubernetes มีสามเสาหลัก ได้แก่ เมตริก บันทึก และการติดตาม Prometheus จัดการการรวบรวมตัวชี้วัด Grafana จัดการการแสดงภาพ แผนภูมิkube-prometheus-stackHelm ปรับใช้สแต็กทั้งหมด — ตัวดำเนินการ Prometheus, ตัวจัดการการแจ้งเตือน, Grafana, ผู้ส่งออกโหนด และชุดแดชบอร์ดที่สร้างไว้ล่วงหน้าที่ครอบคลุม — ในคำสั่งเดียว
helm repo add prometheus-community https://prometheus-community.github.io/helm-charts
helm repo update

helm install kube-prometheus-stack prometheus-community/kube-prometheus-stack \
  --namespace monitoring \
  --create-namespace \
  --set prometheus.prometheusSpec.retention=30d \
  --set prometheus.prometheusSpec.storageSpec.volumeClaimTemplate.spec.storageClassName=longhorn \
  --set prometheus.prometheusSpec.storageSpec.volumeClaimTemplate.spec.resources.requests.storage=100Gi \
  --set grafana.adminPassword=<secure-password> \
  --set alertmanager.alertmanagerSpec.storage.volumeClaimTemplate.spec.resources.requests.storage=10Gi
RKE2 เปิดเผยตัววัด ฯลฯ เมื่อตั้งค่าetcd-expose-metrics: trueในการกำหนดค่าเซิร์ฟเวอร์ เพิ่ม ServiceMonitor เพื่อให้ Prometheus ทำการขูดข้อมูลเหล่านั้น
apiVersion: monitoring.coreos.com/v1
kind: ServiceMonitor
metadata:
  name: rke2-etcd
  namespace: monitoring
  labels:
    release: kube-prometheus-stack
spec:
  namespaceSelector:
    matchNames: [kube-system]
  selector:
    matchLabels:
      app.kubernetes.io/name: rke2-etcd
  endpoints:
    - port: metrics
      scheme: https
      tlsConfig:
        caFile: /etc/prometheus/secrets/etcd-client-cert/ca.crt
        certFile: /etc/prometheus/secrets/etcd-client-cert/client.crt
        keyFile: /etc/prometheus/secrets/etcd-client-cert/client.key
กฎการแจ้งเตือนที่สำคัญ
แดชบอร์ดที่สร้างไว้ล่วงหน้าเป็นจุดเริ่มต้น แต่กฎการแจ้งเตือนแบบกำหนดเองที่ปรับให้เหมาะกับสภาพแวดล้อมของคุณคือสิ่งที่ช่วยให้วิศวกรที่โทรติดต่อสามารถดำเนินการก่อนที่ผู้ใช้จะสังเกตเห็นปัญหา
apiVersion: monitoring.coreos.com/v1
kind: PrometheusRule
metadata:
  name: workload-alerts
  namespace: monitoring
  labels:
    release: kube-prometheus-stack
spec:
  groups:
    - name: pod-health
      rules:
        - alert: PodCrashLooping
          expr: rate(kube_pod_container_status_restarts_total[10m]) > 0.5
          for: 5m
          labels:
            severity: critical
          annotations:
            summary: "Pod {{ $labels.namespace }}/{{ $labels.pod }} is crash-looping"

        - alert: NodeMemoryPressure
          expr: |
            (node_memory_MemAvailable_bytes / node_memory_MemTotal_bytes) < 0.1
          for: 2m
          labels:
            severity: warning
          annotations:
            summary: "Node {{ $labels.node }} memory below 10%"

        - alert: HPAMaxedOut
          expr: |
            kube_horizontalpodautoscaler_status_current_replicas
            == kube_horizontalpodautoscaler_spec_max_replicas
          for: 15m
          labels:
            severity: warning
          annotations:
summary: "HPA {{ $labels.namespace }}/{{ $labels.horizontalpodautoscaler }} at maximum replicas"การแจ้งเตือนHPAMaxedOutมีประโยชน์อย่างยิ่งในทางปฏิบัติ เมื่อ HPA ถูกตรึงไว้ที่ระดับสูงสุดเป็นระยะเวลานาน หมายความว่าปริมาณการใช้ข้อมูลมีมากกว่าเพดานปัจจุบันของคุณ คุณอาจต้องเพิ่มขีดสูงสุดหรือเพิ่มความจุให้กับ Node Pool และคุณต้องการทราบเรื่องนี้ก่อนการเพิ่มขึ้นครั้งถัดไป ไม่ใช่ในระหว่างนั้น
แนวทางปฏิบัติที่ดีที่สุดในการผลิต
งบประมาณการหยุดชะงักของพ็อด
PodDisruptionBudget (PDB) จำกัดจำนวนพ็อดในการปรับใช้ที่ไม่สามารถใช้งานได้พร้อมกันในระหว่างการหยุดชะงักโดยสมัครใจ เช่น การระบายโหนด หากไม่มี PDB การระบายโหนดเพื่อการบำรุงรักษาอาจทำให้การปรับใช้ทั้งหมดเป็นแบบออฟไลน์
apiVersion: policy/v1
kind: PodDisruptionBudget
metadata:
  name: api-server-pdb
  namespace: production
spec:
  minAvailable: 2       # or use maxUnavailable: 1
  selector:
    matchLabels:
app: api-serverตามค่าเริ่มต้น ตัวกำหนดเวลาจะกระจายเรพลิกาข้ามโหนดโดยใช้อัลกอริธึมความพยายามอย่างดีที่สุด ข้อจำกัดการแพร่กระจายของโทโพโลยีช่วยให้คุณรับประกันได้ว่าแบบจำลองจะกระจายไปตาม Availability Zone หรือ Rack
topologySpreadConstraints:
  - maxSkew: 1
    topologyKey: topology.kubernetes.io/zone
    whenUnsatisfiable: DoNotSchedule
    labelSelector:
      matchLabels:
app: api-serverRKE2 รองรับการอัพเกรดแบบต่อเนื่องผ่านตัวควบคุมการอัพเกรดระบบ คุณกำหนดแผนที่กำหนดเป้าหมายเซิร์ฟเวอร์หรือโหนดตัวแทนและระบุเวอร์ชันเป้าหมาย คอนโทรลเลอร์จะระบาย อัปเกรด และปลดโหนดตามลำดับ
apiVersion: upgrade.cattle.io/v1
kind: Plan
metadata:
  name: rke2-server-upgrade
  namespace: system-upgrade
spec:
  concurrency: 1
  cordon: true
  nodeSelector:
    matchExpressions:
      - { key: node-role.kubernetes.io/control-plane, operator: In, values: ["true"] }
  serviceAccountName: system-upgrade
  upgrade:
    image: rancher/rke2-upgrade
  version: v1.29.4+rke2r1
ฯลฯ สำรองและกู้คืน
RKE2 สามารถถ่ายภาพสแนปชอต ฯลฯ ตามกำหนดเวลาได้โดยอัตโนมัติ ตรวจสอบให้แน่ใจว่าเขียนลงในพื้นที่จัดเก็บข้อมูลที่ทนทานภายนอกคลัสเตอร์ — บัคเก็ต S3 หรือการติดตั้ง NFS ระยะไกล — แทนที่จะเป็นดิสก์ภายในเครื่องบนโหนดระนาบควบคุม
# /etc/rancher/rke2/config.yaml additions for automated snapshots
etcd-snapshot-schedule-cron: "0 */6 * * *"    # every 6 hours
etcd-snapshot-retention: 10
etcd-snapshot-dir: /mnt/nfs/etcd-snapshots

# Manual snapshot
rke2 etcd-snapshot save --name pre-upgrade-$(date +%Y%m%d)

# Restore from snapshot (run on a single server node with cluster stopped)
rke2 server --cluster-reset --cluster-reset-restore-path=/path/to/snapshot.db
สรุป
การปรับขนาดโครงสร้างพื้นฐานด้วย RKE2 ไม่ใช่การเปลี่ยนแปลงการกำหนดค่าเพียงครั้งเดียว แต่เป็นระบบที่มีความสามารถในการเชื่อมต่อกันซึ่งต้องได้รับการออกแบบและดำเนินการร่วมกัน การปรับขนาดอัตโนมัติของพ็อดแนวนอนจะจัดการกับการรับส่งข้อมูลในช่วงเวลาสั้นๆ ที่ระดับภาระงาน การปรับขนาดอัตโนมัติของพ็อดแนวตั้งช่วยให้คำขอทรัพยากรมีความเที่ยงตรงตลอดเวลา ตัวปรับขนาดอัตโนมัติของคลัสเตอร์ช่วยให้มั่นใจว่าความจุของโหนดพื้นฐานจะติดตามความต้องการรวมของตัวปรับขนาดอัตโนมัติของพ็อด โหนดพูลและข้อจำกัดของโทโพโลยีทำให้มั่นใจได้ว่าปริมาณงานจะลงสู่ฮาร์ดแวร์ที่เหมาะสม โควต้าทรัพยากรและช่วงขีดจำกัดจะปกป้องผู้เช่าจากกันและกัน PodDisruptionBudgets และข้อจำกัดในการแพร่กระจายโทโพโลยีทำให้ความพร้อมใช้งานแข็งแกร่งขึ้น และ Prometheus พร้อม Grafana ช่วยให้ทีมของคุณมองเห็นการเสื่อมสภาพก่อนที่จะหยุดทำงาน
RKE2 เข้ามามีบทบาทในการผลิตอย่างแม่นยำเนื่องจากจัดส่งชิ้นส่วนจำนวนมากที่ผ่านกระบวนการชุบแข็งล่วงหน้าและบูรณาการล่วงหน้าแล้ว ความรับผิดชอบของคุณคือการทำความเข้าใจปุ่มต่างๆ ปรับแต่งให้เข้ากับลักษณะปริมาณงานของคุณ และสร้างวินัยในการปฏิบัติงาน เช่น รันบุ๊ก การกำหนดเส้นทางการแจ้งเตือน จังหวะการอัปเกรด การตรวจสอบการสำรองข้อมูล ซึ่งเปลี่ยนคลัสเตอร์ที่ได้รับการกำหนดค่าอย่างดีให้เป็นแพลตฟอร์มที่เชื่อถือได้อย่างแท้จริง
เพิ่มเติมจากบล็อก

Observability Is Not Optional: Make It a Business Standard
Why fragmented monitoring creates blind spots, duplicate spend, and slow incidents — and how to make centralised observability a non-negotiable company standard.

WSL Vault for Compliance: One Tenant Never Opens Another’s Secrets
How WSL Vault keeps app, team, and environment tenants cryptographically isolated — so a stolen root-style token cannot empty the estate — and why dual-tenant control beats secrets sprawl.

Workstation AI Shop: Promoting the AI Sales Storefront Through int → test → acc → prod
Workstation AI Shop sells GPU machines with a fully autonomous AI Sales Agent that configures the basket. See how Ring Promoter moves each build through int → test → acc → prod — with Orbit screenshots release engineers and stakeholders share.