บล็อก
PostgreSQL Native High Availability: Patroni, การจำลองแบบสตรีมมิ่ง และกลยุทธ์ความล้มเหลวในการผลิต
PostgreSQL Native HA พร้อม Patroni, การจำลองแบบสตรีมมิ่ง และ HAProxy
ในหน้านี้
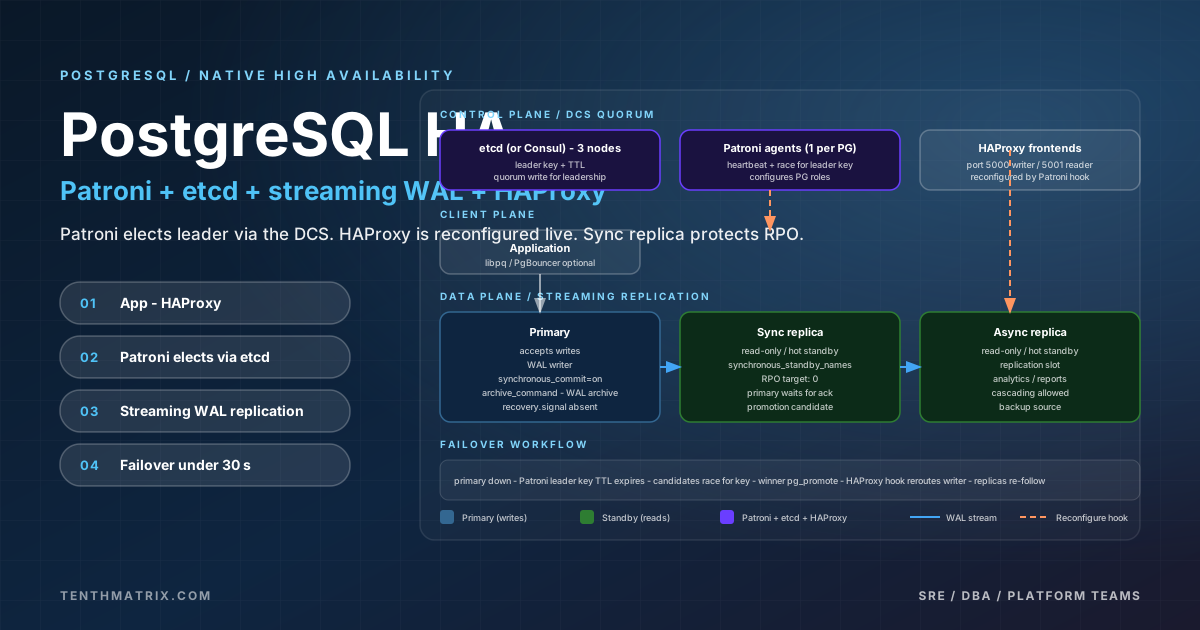
การเรียกใช้อินสแตนซ์ PostgreSQL เดี่ยวจะตรงไปตรงมาจนกว่าการหยุดทำงานโดยไม่ได้วางแผนครั้งแรกจะเตือนคุณว่าฐานข้อมูลจะมีคุณค่าตามความพร้อมใช้งานเท่านั้น ความล้มเหลวของดิสก์ ความตื่นตระหนกเคอร์เนล พาร์ติชันเครือข่าย และการอัพเกรดที่ล้มเหลวไม่ใช่ความเสี่ยงทางทฤษฎี แต่เป็นความแน่นอนในการปฏิบัติงานในไทม์ไลน์ที่ยาวเพียงพอ PostgreSQL ไม่ได้จัดส่งพร้อมกับการเฟลโอเวอร์อัตโนมัติในตัว แต่จะจัดเตรียมการจำลองแบบพื้นฐานทั้งหมดที่จำเป็นในการสร้างคลัสเตอร์ที่มีความพร้อมใช้งานสูง Patroni ซึ่งเป็นเฟรมเวิร์ก HA แบบโอเพ่นซอร์สที่ดูแลโดย Zalando จะประสานพื้นฐานเหล่านั้นเข้ากับระบบเฟลโอเวอร์ระดับการใช้งานจริงที่ได้รับการทดสอบการต่อสู้ในวงกว้างในคลัสเตอร์ PostgreSQL หลายพันคลัสเตอร์ทั่วโลก
บทความนี้เป็นคำแนะนำทางวิศวกรรมแบบเจาะลึก เราจะครอบคลุมการจำลองแบบสตรีมมิ่ง PostgreSQL (ซิงโครนัสและอะซิงโครนัส), สถาปัตยกรรมและการกำหนดค่า Patroni ฯลฯ เป็นที่เก็บการกำหนดค่าแบบกระจาย, HAProxy สำหรับการกำหนดเส้นทางการเชื่อมต่อด้วยการแยกการอ่าน-เขียน, PgBouncer สำหรับการรวมการเชื่อมต่อ, การเก็บถาวร WAL และการกู้คืน ณ เวลาใดเวลาหนึ่ง, การจำลองแบบลอจิคัลสำหรับการซิงโครไนซ์ข้อมูลแบบเลือก, pg_basebackup สำหรับการจัดเตรียมสแตนด์บายเริ่มต้น, repmgr เป็นทางเลือกแทน Patroni, รูปแบบการใช้งานเฉพาะบนคลาวด์สำหรับ AWS, Azure และ GCP, การปรับใช้ k3s แบบ Bare Metal พร้อม Rancher และ Longhorn, การมอนิเตอร์ด้วย pg_stat_replication และ Prometheus/Grafana, กระบวนการสลับเทียบกับเฟลโอเวอร์, การป้องกันแบบแยกสมอง, การปรับแต่งการผลิต และวิศวกรรมความโกลาหลสำหรับการตรวจสอบเฟลโอเวอร์
PostgreSQL พื้นฐานการจำลองแบบสตรีมมิ่ง
การจำลองแบบสตรีมมิ่งเป็นแกนหลักของความพร้อมใช้งานสูงของ PostgreSQL ทำงานโดยจัดส่งบันทึก Write-Ahead Log (WAL) อย่างต่อเนื่องจากเซิร์ฟเวอร์หลักไปยังเซิร์ฟเวอร์สแตนด์บายอย่างน้อยหนึ่งเซิร์ฟเวอร์ การสแตนด์บายจะใช้บันทึก WAL เหล่านั้นแบบเรียลไทม์ โดยรักษาสำเนาข้อมูลหลักที่เกือบจะเหมือนกัน กลไกนี้ถูกนำมาใช้ใน PostgreSQL 9.0 และได้รับการปรับปรุงในทุกรุ่นที่ตามมา
การจำลองแบบสตรีมมิ่งมีสองโหมด:อะซิงโครนัสและซิงโครนัสในโหมดอะซิงโครนัส อุปกรณ์หลักจะไม่รอให้สแตนด์บายยืนยันการรับบันทึก WAL ก่อนที่จะทำธุรกรรม สิ่งนี้ให้ประสิทธิภาพการเขียนสูงสุด แต่ทำให้เกิดช่วงข้อมูลที่อาจสูญหายได้ หากข้อมูลหลักล้มเหลวก่อนที่สแตนด์บายจะได้รับ WAL ล่าสุด ธุรกรรมเหล่านั้นจะสูญหายไป ในโหมดซิงโครนัส อุปกรณ์หลักจะรออย่างน้อยหนึ่งโหมดสแตนด์บายเพื่อยืนยันว่าบันทึก WAL ได้รับการเขียนลงในที่เก็บข้อมูลถาวรก่อนที่จะรายงานธุรกรรมตามข้อผูกพัน วิธีนี้จะช่วยลดการสูญเสียข้อมูลโดยมีต้นทุนเวลาแฝงในการดำเนินการที่เพิ่มขึ้น เนื่องจากการเขียนทุกครั้งจะต้องเดินทางไปกลับที่โหมดสแตนด์บาย
ตัวเลือกระหว่างการจำลองแบบซิงโครนัสและอะซิงโครนัสไม่ใช่ไบนารี PostgreSQL รองรับsynchronous_commitที่ระดับเซสชั่น ดังนั้นปริมาณงานที่ไวต่อความหน่วงจึงสามารถเลือกรับคอมมิตแบบอะซิงโครนัสได้ ในขณะที่ธุรกรรมทางการเงินที่สำคัญใช้คอมมิตแบบซิงโครนัสภายในคลัสเตอร์เดียวกัน
การกำหนดค่าหลักสำหรับการจำลอง
ต้องกำหนดค่าเซิร์ฟเวอร์หลักเพื่อสร้างบันทึก WAL ในระดับที่เพียงพอสำหรับการจำลองแบบและอนุญาตการเชื่อมต่อแบบสแตนด์บาย การตั้งค่าpostgresql.confต่อไปนี้เป็นสิ่งจำเป็น
# postgresql.conf on the primary
wal_level = replica                    # minimum for streaming replication
max_wal_senders = 10                   # max concurrent replication connections
max_replication_slots = 10             # prevent WAL removal before standby consumption
wal_keep_size = 2GB                    # retain WAL as fallback if slots are unused
hot_standby = on                       # allow read queries on standbys
synchronous_commit = on                # 'on' for sync, 'off' for pure async
synchronous_standby_names = 'ANY 1 (standby1, standby2)'  # sync replication targets
archive_mode = on                      # enable WAL archiving for PITR
archive_command = 'test ! -f /archive/%f && cp %p /archive/%f'
listening_addresses = '*'
port = 5432การรับรองความถูกต้องสำหรับการเชื่อมต่อการจำลองได้รับการจัดการในpg_hba.confการเชื่อมต่อการจำลองแบบใช้ประเภทการเชื่อมต่อเฉพาะ
# pg_hba.conf — replication entries
# TYPE   DATABASE        USER            ADDRESS              METHOD
host     replication     replicator      10.0.1.0/24          scram-sha-256
host     replication     replicator      10.0.2.0/24          scram-sha-256
host     all             all             10.0.0.0/16          scram-sha-256
สร้างผู้ใช้การจำลองแบบบนหลัก
CREATE ROLE replicator WITH REPLICATION LOGIN PASSWORD 'strong_replication_password';การจัดเตรียมสแตนด์บายด้วย pg_basebackup
ยูทิลิตีpg_basebackupจะสร้างสำเนาทางกายภาพของไดเร็กทอรีข้อมูลหลัก ซึ่งจะกลายเป็นจุดเริ่มต้นสำหรับการสแตนด์บายใหม่ โดยจะจัดการการสำรองข้อมูลพื้นฐานและการสตรีม WAL แบบอะตอมมิก ดังนั้นสำเนาผลลัพธ์จึงมีความสอดคล้องกัน
# On the standby server
pg_basebackup -h primary-host -U replicator -D /var/lib/postgresql/16/main \
  -Fp -Xs -P -R

# -Fp: plain format
# -Xs: stream WAL during backup
# -P:  show progress
# -R: create standby.signal and configure primary_conninfo in postgresql.auto.confธง-Rมีความสำคัญ โดยจะเขียนprimary_conninfoลงในpostgresql.auto.confและสร้างstandby.signalซึ่งบอกให้ PostgreSQL เริ่มต้นในโหมดสแตนด์บาย ใน PostgreSQL 12 และใหม่กว่าrecovery.confจะถูกแทนที่ด้วยกลไกทั้งสองนี้
# postgresql.auto.conf (generated by pg_basebackup -R)
primary_conninfo = 'host=primary-host port=5432 user=replicator password=strong_replication_password application_name=standby1'
primary_slot_name = 'standby1_slot'
สร้างสล็อตการจำลองบนเครื่องหลักก่อนที่จะเริ่มสแตนด์บาย เพื่อป้องกันไม่ให้ WAL ถูกล้างก่อนที่สแตนด์บายจะสามารถใช้งานได้
SELECT pg_create_physical_replication_slot('standby1_slot');
SELECT pg_create_physical_replication_slot('standby2_slot');
Patroni: การประสาน HA อัตโนมัติ
การจำลองแบบสตรีมมิ่งช่วยให้คุณมีข้อมูลซ้ำซ้อน แต่ไม่ได้ทำให้คุณเกิดข้อผิดพลาดโดยอัตโนมัติ หากเกิดข้อขัดข้องหลัก บุคคล — ผู้ปฏิบัติงานที่เป็นมนุษย์หรือระบบอัตโนมัติ — จะต้องเลื่อนสถานะสแตนด์บายไปเป็นโหมดหลัก กำหนดค่าการสแตนด์บายที่เหลือใหม่ให้เป็นไปตามระบบหลักใหม่ และอัปเดตเส้นทางการเชื่อมต่อ Patroni ดำเนินการทั้งหมดนี้โดยอัตโนมัติ
Patroni คือ Python daemon ที่ทำงานควบคู่ไปกับอินสแตนซ์ PostgreSQL แต่ละตัว มันใช้ Distributed Configuration Store (DCS) — โดยทั่วไปแล้วจะเป็น ฯลฯ แต่ยังใช้ ZooKeeper หรือ Consul ด้วย — เพื่อประสานงานการเลือกตั้งผู้นำและสถานะของคลัสเตอร์ โหนด Patroni ทุกโหนดจะเขียนสถานะความสมบูรณ์ไปยัง DCS อย่างต่อเนื่อง เมื่อผู้นำ (หลัก) ไม่สามารถต่ออายุคีย์ DCS ภายใน TTL ที่กำหนดค่าไว้ Patroni จะเริ่มการเลือกตั้งผู้นำท่ามกลางผู้สแตนด์บายที่ดี ผู้ชนะจะได้รับการเลื่อนขั้นเป็นโหนดหลัก และโหนดที่เหลือจะกำหนดค่าตัวเองใหม่เป็นสแตนด์บายของโหนดหลักใหม่ ซึ่งทั้งหมดโดยอัตโนมัติ โดยทั่วไปจะใช้เวลาภายใน 10-30 วินาที
การกำหนดค่า Patroni YAML
Patroni ได้รับการกำหนดค่าผ่านไฟล์ YAML ที่กำหนดการเชื่อมต่อ DCS, พารามิเตอร์ PostgreSQL, ลักษณะการทำงานของการจำลอง และการตั้งค่าบูตสแตรป ต่อไปนี้คือการกำหนดค่าระดับการใช้งานจริงสำหรับโหนดหลัก
# /etc/patroni/patroni.yml — Node 1 (Primary)
scope: pg-ha-cluster
namespace: /postgresql-ha/
name: node1

restapi:
  listen: 0.0.0.0:8008
  connect_address: 10.0.1.10:8008

etcd3:
  hosts:
    - 10.0.2.10:2379
    - 10.0.2.11:2379
    - 10.0.2.12:2379

bootstrap:
  dcs:
    ttl: 30
    loop_wait: 10
    retry_timeout: 10
    maximum_lag_on_failover: 1048576  # 1MB — only promote standbys within this lag
    synchronous_mode: true
    synchronous_mode_strict: false
    postgresql:
      use_pg_rewind: true
      use_slots: true
      parameters:
        wal_level: replica
        hot_standby: 'on'
        max_connections: 200
        max_wal_senders: 10
        max_replication_slots: 10
        wal_keep_size: 2GB
        synchronous_commit: 'on'
        archive_mode: 'on'
        archive_command: 'test ! -f /archive/%f && cp %p /archive/%f'
        archive_timeout: 60
        wal_log_hints: 'on'
        shared_preload_libraries: 'pg_stat_statements'
        track_commit_timestamp: 'on'
      pg_hba:
        - host replication replicator 10.0.0.0/16 scram-sha-256
        - host all all 10.0.0.0/16 scram-sha-256
        - host all all 0.0.0.0/0 scram-sha-256

  initdb:
    - encoding: UTF8
    - data-checksums

  users:
    admin:
      password: 'admin_secure_password'
      options:
        - createrole
        - createdb
    replicator:
      password: 'repl_secure_password'
      options:
        - replication

postgresql:
  listen: 0.0.0.0:5432
  connect_address: 10.0.1.10:5432
  data_dir: /var/lib/postgresql/16/main
  bin_dir: /usr/lib/postgresql/16/bin
  config_dir: /var/lib/postgresql/16/main
  pgpass: /tmp/pgpass0
  authentication:
    superuser:
      username: postgres
      password: 'postgres_secure_password'
    replication:
      username: replicator
      password: 'repl_secure_password'
    rewind:
      username: postgres
      password: 'postgres_secure_password'
  parameters:
    unix_socket_directories: '/var/run/postgresql'
  create_replica_methods:
    - basebackup
  basebackup:
    max-rate: 100M
    checkpoint: fast

tags:
  nofailover: false
  noloadbalance: false
  clonefrom: false
nosync: falseโหนดสแตนด์บายใช้การกำหนดค่าที่เหมือนกันกับค่าname,connect_addressและlistenของตัวเอง Patroni จัดการส่วนที่เหลือ — โดยตรวจจับว่าโหนดควรเป็นผู้นำหรือแบบจำลองตามสถานะ DCS และกำหนดค่า PostgreSQL ตามนั้น
ฯลฯ เป็นร้านค้าการกำหนดค่าแบบกระจาย
ฯลฯd คือระบบประสาทของคลัสเตอร์ Patroni โดยจัดเก็บข้อมูลประจำตัวของผู้นำในปัจจุบัน โทโพโลยีคลัสเตอร์ การกำหนดค่าที่ต้องการ และสถานะความสมบูรณ์ของแต่ละโหนด คลัสเตอร์ ฯลฯ แบบ 3 โหนดเป็นคลัสเตอร์ขั้นต่ำสำหรับการผลิต โดยยอมรับความล้มเหลวของโหนดเดียวในขณะที่ยังคงรักษาองค์ประชุมไว้
# Install and configure etcd on three dedicated nodes
# /etc/etcd/etcd.conf.yml — Node etcd1 (10.0.2.10)
name: etcd1
data-dir: /var/lib/etcd
listen-client-urls: http://0.0.0.0:2379
listen-peer-urls: http://0.0.0.0:2380
advertise-client-urls: http://10.0.2.10:2379
initial-advertise-peer-urls: http://10.0.2.10:2380
initial-cluster: etcd1=http://10.0.2.10:2380,etcd2=http://10.0.2.11:2380,etcd3=http://10.0.2.12:2380
initial-cluster-state: new
initial-cluster-token: patroni-etcd-cluster

# Start etcd
systemctl enable --now etcd

# Verify cluster health
etcdctl endpoint health --cluster \
  --endpoints=http://10.0.2.10:2379,http://10.0.2.11:2379,http://10.0.2.12:2379
สำหรับการปรับใช้จริง ให้เปิดใช้งาน TLS ระหว่างเพียร์ etcd และระหว่างไคลเอ็นต์ etcd และ Patroni การรับส่งข้อมูล ฯลฯ ที่ไม่ได้เข้ารหัสจะเปิดเผยข้อมูลรับรองคลัสเตอร์และการกำหนดค่าแก่ผู้โจมตีระดับเครือข่าย
HAProxy สำหรับการกำหนดเส้นทางการเชื่อมต่อ
Patroni เปิดเผย REST API บนแต่ละโหนด (พอร์ต 8008 ตามค่าเริ่มต้น) ซึ่งจะรายงานว่าโหนดเป็นผู้นำปัจจุบันหรือแบบจำลอง HAProxy ใช้จุดสิ้นสุดการตรวจสอบสภาพเหล่านี้เพื่อกำหนดเส้นทางการรับส่งข้อมูล: การเขียนไปที่ผู้นำ อ่านไปที่แบบจำลองที่มีประสิทธิภาพ สิ่งนี้ช่วยให้คุณแยกการอ่านและเขียนอัตโนมัติโดยไม่มีการเปลี่ยนแปลงระดับแอปพลิเคชัน
# /etc/haproxy/haproxy.cfg
global
    maxconn 2000
    log /dev/log local0
    stats socket /var/run/haproxy.sock mode 660 level admin

defaults
    mode tcp
    log global
    retries 3
    timeout client 30m
    timeout connect 4s
    timeout server 30m
    timeout check 5s
    maxconn 1000

listen pg_write
    bind *:5000
    option httpchk GET /primary
    http-check expect status 200
    default-server inter 3s fall 3 rise 2 on-marked-down shutdown-sessions
    server node1 10.0.1.10:5432 check port 8008
    server node2 10.0.1.11:5432 check port 8008
    server node3 10.0.1.12:5432 check port 8008

listen pg_read
    bind *:5001
    balance roundrobin
    option httpchk GET /replica
    http-check expect status 200
    default-server inter 3s fall 3 rise 2 on-marked-down shutdown-sessions
    server node1 10.0.1.10:5432 check port 8008
    server node2 10.0.1.11:5432 check port 8008
    server node3 10.0.1.12:5432 check port 8008

listen stats
    bind *:7000
    mode http
    stats enable
    stats uri /
stats refresh 10sตำแหน่งข้อมูล/primaryส่งคืน HTTP 200 บนผู้นำ Patroni ปัจจุบันเท่านั้น ตำแหน่งข้อมูล/replicaส่งคืน 200 เมื่อสแตนด์บายดี เมื่อเกิดข้อผิดพลาด หลักใหม่จะเริ่มส่งคืน 200 บน/primaryและ HAProxy จะเปลี่ยนเส้นทางการรับส่งข้อมูลการเขียนโดยอัตโนมัติ โดยทั่วไปจะอยู่ภายในช่วงเวลาการตรวจสอบสภาพเดียว (3 วินาที) คำสั่งon-marked-down shutdown-sessionsจะยุติการเชื่อมต่อที่มีอยู่กับเครือข่ายหลักที่ล้มเหลวทันที โดยบังคับให้ไคลเอ็นต์เชื่อมต่อกับผู้นำคนใหม่อีกครั้ง
PgBouncer สำหรับการรวมการเชื่อมต่อ
PostgreSQL สร้างกระบวนการแบ็กเอนด์ใหม่สำหรับการเชื่อมต่อไคลเอนต์แต่ละรายการ ในขนาดที่ใหญ่ — ไมโครเซอร์วิสหลายร้อยหรือหลายพันรายการแต่ละแห่งยังคงรักษาพูลการเชื่อมต่อ — ค่าใช้จ่ายในการสร้างกระบวนการและการใช้หน่วยความจำมีความสำคัญ PgBouncer อยู่ระหว่างแอปพลิเคชันและ PostgreSQL โดยจะรักษากลุ่มการเชื่อมต่อฝั่งเซิร์ฟเวอร์และการเชื่อมต่อไคลเอ็นต์แบบมัลติเพล็กซ์ไว้ด้วยกัน
# /etc/pgbouncer/pgbouncer.ini
[databases]
* = host=127.0.0.1 port=5432 dbname=appdb

[pgbouncer]
listen_addr = 0.0.0.0
listen_port = 6432
auth_type = scram-sha-256
auth_file = /etc/pgbouncer/userlist.txt

pool_mode = transaction
max_client_conn = 1000
default_pool_size = 50
min_pool_size = 10
reserve_pool_size = 10
reserve_pool_timeout = 3
server_lifetime = 3600
server_idle_timeout = 600
server_connect_timeout = 5
server_login_retry = 3

log_connections = 1
log_disconnections = 1
stats_period = 60
เมื่อใช้กับ Patroni โดยทั่วไป PgBouncer จะอยู่ร่วมกันบนแต่ละโหนด PostgreSQL หรือบนโหนด HAProxy โหมดพูลtransactionเป็นตัวเลือกที่ดีที่สุดสำหรับปริมาณงานส่วนใหญ่ โดยจะกำหนดการเชื่อมต่อเซิร์ฟเวอร์ในช่วงระยะเวลาของธุรกรรม และส่งคืนไปยังพูลระหว่างธุรกรรม ซึ่งมีประสิทธิภาพมากกว่าโหมดsessionมาก ซึ่งเก็บการเชื่อมต่อสำหรับเซสชันไคลเอ็นต์ทั้งหมด
WAL การเก็บถาวรและการกู้คืนช่วงเวลา
การจำลองแบบสตรีมมิ่งป้องกันความล้มเหลวของเซิร์ฟเวอร์ แต่ไม่ได้ป้องกันข้อผิดพลาดเชิงตรรกะDROP TABLEโดยไม่ตั้งใจหรือการย้ายแอปพลิเคชันที่ไม่ถูกต้องจะถูกจำลองแบบไปยังสแตนด์บายทั้งหมดทันที การเก็บถาวร WAL รวมกับการกู้คืนแบบ point-in-time (PITR) ช่วยให้คุณสามารถกู้คืนในช่วงเวลาใดก็ได้ก่อนเกิดข้อผิดพลาด
WAL จะคัดลอกเซกเมนต์ WAL ที่เสร็จสมบูรณ์ไปยังการเก็บถาวรแบบถาวร — โดยทั่วไปจะเป็นบัคเก็ต S3, การเมาท์ NFS หรือเซิร์ฟเวอร์สำรองข้อมูลเฉพาะ เครื่องมืออย่างpgBackRestและWAL-Gจัดการการเก็บถาวรอย่างมีประสิทธิภาพด้วยการบีบอัด การเข้ารหัส และการถ่ายโอนแบบขนาน
# pgBackRest configuration — /etc/pgbackrest/pgbackrest.conf
[global]
repo1-type=s3
repo1-s3-bucket=pg-wal-archive
repo1-s3-endpoint=s3.eu-west-1.amazonaws.com
repo1-s3-region=eu-west-1
repo1-s3-key=AKIAIOSFODNN7EXAMPLE
repo1-s3-key-secret=wJalrXUtnFEMI/K7MDENG/bPxRfiCYEXAMPLEKEY
repo1-path=/pgbackrest
repo1-retention-full=4
repo1-retention-diff=7
repo1-cipher-type=aes-256-cbc
repo1-cipher-pass=strong_encryption_passphrase
compress-type=zst
compress-level=3
process-max=4

[pg-ha-cluster]
pg1-path=/var/lib/postgresql/16/main
pg1-port=5432

# In postgresql.conf
archive_command = 'pgbackrest --stanza=pg-ha-cluster archive-push %p'
restore_command = 'pgbackrest --stanza=pg-ha-cluster archive-get %f "%p"'
หากต้องการดำเนินการกู้คืน ณ เวลาใดเวลาหนึ่ง ให้ระบุการประทับเวลาเป้าหมาย
# Restore to a specific point in time
pgbackrest --stanza=pg-ha-cluster --type=time \
  --target="2026-04-12 11:25:00" \
  --target-action=promote \
  restore
การจำลองแบบลอจิคัลสำหรับการซิงโครไนซ์ข้อมูลแบบเลือก
ในขณะที่การจำลองแบบสตรีมมิ่งสร้างสำเนาจริงของคลัสเตอร์ฐานข้อมูลทั้งหมด การจำลองแบบลอจิคัลจะทำงานในระดับตาราง โดยจำลองแต่ละตารางหรือชุดย่อยของข้อมูลระหว่างอินสแตนซ์ PostgreSQL อิสระ สิ่งนี้มีประโยชน์สำหรับการอัปเกรดเวอร์ชันหลักที่ไม่ต้องหยุดทำงาน, การจำลองการอ่านข้ามภูมิภาคที่ต้องการเฉพาะตารางเฉพาะ, การป้อนคลังข้อมูล และการกระจายข้อมูลหลายผู้เช่า
# On the publisher (source database)
wal_level = logical  # must be 'logical' — higher than 'replica'

CREATE PUBLICATION app_pub FOR TABLE orders, customers, products;

# On the subscriber (target database)
CREATE SUBSCRIPTION app_sub
  CONNECTION 'host=publisher-host port=5432 dbname=appdb user=replicator password=pass'
PUBLICATION app_pub;สามารถทำงานควบคู่ไปกับการจำลองแบบสตรีมมิ่ง รูปแบบทั่วไปคือการใช้การจำลองแบบสตรีมมิ่งสำหรับ HA (การเฟลโอเวอร์ทางกายภาพที่รวดเร็ว) และการจำลองแบบลอจิคัลสำหรับแบบจำลองการวิเคราะห์ข้ามภูมิภาคที่ต้องการเพียงชุดย่อยของตาราง
การจำลองแบบสตรีมมิ่งหลายภูมิภาค
สำหรับการกู้คืนระบบและประสิทธิภาพการอ่านทั่วโลก คลัสเตอร์ PostgreSQL สามารถขยายได้หลายภูมิภาค รูปแบบมาตรฐานคือการจำลองแบบซิงโครนัสภายในภูมิภาค (สำหรับการสูญเสียข้อมูลเป็นศูนย์บนการเปลี่ยนระบบภายในเครื่อง) และการจำลองแบบอะซิงโครนัสข้ามภูมิภาค (เพื่อหลีกเลี่ยงการลงโทษเวลาแฝงข้ามภูมิภาคในการเขียนทุกครั้ง) แต่ละภูมิภาคมี HAProxy ของตัวเองสำหรับการกำหนดเส้นทางการอ่านในเครื่อง
Failover และขั้นตอนการสลับ
การทำความเข้าใจความแตกต่างระหว่างเฟลโอเวอร์และสวิตช์โอเวอร์เป็นสิ่งสำคัญ ความล้มเหลวของเป็นการเลื่อนระดับที่ไม่ได้วางแผนไว้ซึ่งเกิดจากความล้มเหลวของหลักปัจจุบัน การเปลี่ยนเป็นการเปลี่ยนแปลงบทบาทที่วางแผนไว้และสง่างาม ซึ่งโดยทั่วไปจะดำเนินการก่อนการบำรุงรักษา Patroni สนับสนุนทั้งสองอย่าง
สวิตช์โอเวอร์ที่วางแผนไว้
# List cluster members
patronictlctl -c /etc/patroni/patroni.yml list

# Perform switchover to a specific node
patronictlctl -c /etc/patroni/patroni.yml switchover \
  --master node1 --candidate node2 --force

# Or use the Patroni REST API
curl -s http://10.0.1.10:8008/switchover -XPOST \
  -d '{"leader": "node1", "candidate": "node2"}'
ในระหว่างการเปลี่ยนระบบ Patroni จะลดระดับอุปกรณ์หลักในปัจจุบันเป็นสแตนด์บาย เลื่อนตำแหน่งผู้สมัครที่เป็นเป้าหมาย และกำหนดค่าสแตนด์บายอื่นๆ ทั้งหมดใหม่เพื่อติดตามอุปกรณ์หลักใหม่ กระบวนการนี้ใช้เวลา 5-15 วินาที HAProxy ตรวจจับการเปลี่ยนแปลงผ่านการตรวจสอบสภาพและเปลี่ยนเส้นทางการรับส่งข้อมูลโดยอัตโนมัติ
ลำดับข้อผิดพลาดอัตโนมัติ
เมื่อตัวหลักล้มเหลวโดยไม่คาดคิด Patroni จะปฏิบัติตามลำดับที่แม่นยำเพื่อกู้คืนบริการ แผนภาพต่อไปนี้แสดงขั้นตอนต่างๆ
การป้องกันการแบ่งสมอง
Split-brain — โดยที่โหนดสองโหนดพร้อมกันเชื่อว่าเป็นโหนดหลัก — เป็นโหมดความล้มเหลวที่อันตรายที่สุดในระบบ HA ใดๆ Patroni ป้องกันสมองแตกด้วยกลไกหลายอย่าง:
- การล็อคผู้นำที่ใช้ DCS:มีเพียงโหนดเดียวเท่านั้นที่สามารถเก็บคีย์ผู้นำใน etcd ได้ตลอดเวลา คีย์มี TTL และผู้นำต้องต่ออายุอย่างต่อเนื่อง หากพาร์ติชันเครือข่ายแยกผู้นำออกจาก ฯลฯ คีย์จะหมดอายุ และผู้นำจะลดระดับตัวเอง
- Watchdog:Patroni สามารถกำหนดค่าอุปกรณ์เฝ้าระวัง Linux (
/dev/watchdog) หาก Patroni สูญเสียการเข้าถึง DCS และไม่สามารถยืนยันได้ว่าควรจะยังคงเป็นผู้นำ หน่วยงานเฝ้าระวังจะรีบูตหรือปิดโหนด ซึ่งเป็นกลไกการฟันดาบแบบแข็งที่รับประกันว่าโหนดหลักแบบเก่าจะไม่ยอมรับการเขียนต่อไป - pg_rewind:เมื่อรายการหลักเดิมกลับมาออนไลน์ อาจมีบันทึก WAL ที่ไม่เคยทำซ้ำ
pg_rewindย้อนกลับไทม์ไลน์ไปยังจุดที่แตกต่าง ทำให้โหนดสามารถเข้าร่วมอีกครั้งในฐานะสแตนด์บายโดยไม่ต้องสำรองข้อมูลฐานทั้งหมด การตั้งค่าuse_pg_rewind: trueของ Patroni จะทำให้สิ่งนี้เป็นไปโดยอัตโนมัติ
# Enable watchdog in Patroni config
bootstrap:
  dcs:
    postgresql:
      use_pg_rewind: true
      parameters:
        wal_log_hints: 'on'  # required for pg_rewind

# Watchdog configuration
watchdog:
  mode: required        # 'off', 'automatic', or 'required'
  device: /dev/watchdog
  safety_margin: 5      # seconds before TTL expiry to trigger watchdog
repmgr เป็นทางเลือกแทน Patroni
repmgrเป็นอีกหนึ่งเครื่องมือ HA ยอดนิยมสำหรับ PostgreSQL โดยมีการจัดการสแตนด์บาย การเฟลโอเวอร์อัตโนมัติ และความสามารถในการสลับโอเวอร์ อย่างไรก็ตาม Patroni มีแนวทางพื้นฐานที่แตกต่างจาก Patroni repmgr ใช้โหนดพยานและ daemon (repmgrd) สำหรับการตรวจจับความล้มเหลว แทนที่จะใช้ที่เก็บฉันทามติแบบกระจาย ซึ่งทำให้ปรับใช้ได้ง่ายขึ้น แต่เสี่ยงต่อการแบ่งสมองในสถานการณ์พาร์ติชันเครือข่ายที่ซับซ้อนมากขึ้น
# repmgr.conf on the primary
node_id=1
node_name='node1'
conninfo='host=10.0.1.10 user=repmgr dbname=repmgr connect_timeout=2'
data_directory='/var/lib/postgresql/16/main'
failover=automatic
promote_command='repmgr standby promote -f /etc/repmgr.conf --log-to-file'
follow_command='repmgr standby follow -f /etc/repmgr.conf --log-to-file --upstream-node-id=%n'
monitoring_history=yes
monitor_interval_secs=5
reconnect_attempts=6
reconnect_interval=10
สำหรับการปรับใช้ใหม่ Patroni เป็นตัวเลือกที่แนะนำ เนื่องจากมีการรับประกันการป้องกันการแบ่งสมองที่แข็งแกร่งยิ่งขึ้น และชุมชนการพัฒนาที่กระตือรือร้นมากขึ้น repmgr ยังคงเป็นตัวเลือกที่เหมาะสมสำหรับการตั้งค่าที่ง่ายกว่าหรือองค์กรที่ลงทุนในเครื่องมือนี้แล้ว
รูปแบบการปรับใช้คลาวด์AWS การใช้งาน: EC2, EBS และ Route53
บน AWS ให้ปรับใช้แต่ละโหนด PostgreSQL + Patroni บนอินสแตนซ์ EC2 ที่มีวอลุ่ม EBS gp3 หรือ io2 ใช้อินสแตนซ์แยกกันใน Availability Zone หลายแห่งสำหรับ HA โหนด etcd ควรขยาย AZ ด้วย
# Terraform sketch for PostgreSQL HA on AWS
resource "aws_instance" "pg_node" {
  count                = 3
  ami                  = "ami-0abcdef1234567890"  # Ubuntu 22.04
  instance_type        = "r6g.2xlarge"             # 8 vCPU, 64GB RAM
  subnet_id            = aws_subnet.private[count.index].id
  vpc_security_group_ids = [aws_security_group.pg_sg.id]
  availability_zone    = element(["eu-west-1a", "eu-west-1b", "eu-west-1c"], count.index)

  root_block_device {
    volume_size = 50
    volume_type = "gp3"
  }

  tags = {
    Name = "pg-node-${count.index + 1}"
    Role = "patroni"
  }
}

resource "aws_ebs_volume" "pg_data" {
  count             = 3
  availability_zone = element(["eu-west-1a", "eu-west-1b", "eu-west-1c"], count.index)
  size              = 500
  type              = "gp3"
  iops              = 6000
  throughput        = 250
  encrypted         = true

  tags = {
    Name = "pg-data-${count.index + 1}"
  }
}

resource "aws_route53_health_check" "pg_primary" {
  count             = 3
  ip_address        = aws_instance.pg_node[count.index].private_ip
  port              = 8008
  type              = "HTTP"
  resource_path     = "/primary"
  failure_threshold = 3
  request_interval  = 10
}
ใช้ Network Load Balancer (NLB) แทน HAProxy หากคุณต้องการโซลูชันที่ได้รับการจัดการ AWS NLB สามารถใช้การตรวจสอบสภาพของกลุ่มเป้าหมายกับ Patroni REST API เพื่อกำหนดเส้นทางการรับส่งข้อมูลไปยังเครือข่ายหลักในปัจจุบัน
การปรับใช้Azure: VMs, ดิสก์ที่ได้รับการจัดการ และ Azure LB
บน Azure ให้ใช้ Standard_E8s_v5 VMs (เพิ่มประสิทธิภาพหน่วยความจำ) ด้วย Premium SSD Managed Disks สำหรับวอลุ่มข้อมูล ปรับใช้ข้าม Availability Zone โหลดบาลานเซอร์ Azure ให้เทียบเท่ากับ HAProxy พร้อมโพรบสถานภาพเทียบกับ Patroni REST API
# Azure CLI — create PostgreSQL VM with Managed Disk
az vm create \
  --resource-group pg-ha-rg \
  --name pg-node-1 \
  --image Canonical:0001-com-ubuntu-server-jammy:22_04-lts:latest \
  --size Standard_E8s_v5 \
  --zone 1 \
  --vnet-name pg-vnet \
  --subnet pg-subnet \
  --nsg pg-nsg \
  --admin-username pgadmin \
  --ssh-key-value ~/.ssh/id_rsa.pub

az disk create \
  --resource-group pg-ha-rg \
  --name pg-data-1 \
  --size-gb 512 \
  --sku Premium_LRS \
  --zone 1

az vm disk attach \
  --resource-group pg-ha-rg \
  --vm-name pg-node-1 \
  --name pg-data-1

# Azure Load Balancer health probe for Patroni
az network lb probe create \
  --resource-group pg-ha-rg \
  --lb-name pg-lb \
  --name patroni-primary-probe \
  --protocol Http \
  --port 8008 \
  --path /primary \
  --interval 5 \
--threshold 3GCP: Compute Engine และ Cloud Load Balancing
บน GCP ให้ใช้อินสแตนซ์ n2-highmem-8 (8 vCPU, RAM 64GB) พร้อมดิสก์ถาวร SSD กระจายข้ามโซนภายในภูมิภาค ใช้ตัวจัดสรรภาระงาน TCP/UDP ภายในพร้อมการตรวจสอบประสิทธิภาพการทำงานของ Patroni
# GCP — create instance and persistent disk
gcloud compute instances create pg-node-1 \
  --zone=europe-west1-b \
  --machine-type=n2-highmem-8 \
  --image-family=ubuntu-2204-lts \
  --image-project=ubuntu-os-cloud \
  --boot-disk-size=50GB \
  --network=pg-network \
  --subnet=pg-subnet

gcloud compute disks create pg-data-1 \
  --zone=europe-west1-b \
  --size=500GB \
  --type=pd-ssd

gcloud compute instances attach-disk pg-node-1 \
  --disk=pg-data-1 \
  --zone=europe-west1-b

# Health check for Patroni primary endpoint
gcloud compute health-checks create http patroni-primary-check \
  --port=8008 \
  --request-path=/primary \
  --check-interval=5s \
  --timeout=5s \
  --unhealthy-threshold=3 \
  --healthy-threshold=2
Bare Metal k3s การใช้งานกับ Rancher และ Longhorn
สำหรับองค์กรที่ใช้งานฮาร์ดแวร์ของตนเอง การปรับใช้ PostgreSQL HA บน Bare Metal ด้วย k3s, Rancher และ Longhorn มอบโครงสร้างพื้นฐานแบบโอเพ่นซอร์สเต็มรูปแบบที่ไม่ขึ้นกับระบบคลาวด์ k3s เป็นการกระจาย Kubernetes น้ำหนักเบาที่ทำงานได้อย่างมีประสิทธิภาพบนเซิร์ฟเวอร์ Bare Metal โดยไม่มีค่าใช้จ่ายในการกระจาย Kubernetes เต็มรูปแบบ
k3s และการตั้งค่า Longhorn
# Install k3s on the first server node
curl -sfL https://get.k3s.io | K3S_TOKEN=my-cluster-token \
  INSTALL_K3S_EXEC="server --cluster-init --disable traefik --disable servicelb" sh -

# Join additional server nodes
curl -sfL https://get.k3s.io | K3S_TOKEN=my-cluster-token \
  K3S_URL=https://10.0.0.1:6443 \
  INSTALL_K3S_EXEC="server" sh -

# Install Longhorn for distributed block storage
helm repo add longhorn https://charts.longhorn.io
helm install longhorn longhorn/longhorn \
  --namespace longhorn-system --create-namespace \
  --set defaultSettings.defaultDataPath=/mnt/longhorn \
  --set defaultSettings.replicaCount=3 \
  --set defaultSettings.storageMinimalAvailablePercentage=15

# Deploy PostgreSQL with Patroni using the Zalando Postgres Operator
helm repo add postgres-operator-charts https://opensource.zalando.com/postgres-operator/charts/postgres-operator
helm install postgres-operator postgres-operator-charts/postgres-operator \
  --namespace postgres-system --create-namespace
# PostgreSQL cluster manifest for the Zalando Postgres Operator
apiVersion: acid.zalan.do/v1
kind: postgresql
metadata:
name: pg-ha-cluster
namespace: production
spec:
teamId: "platform"
numberOfInstances: 3
volume:
size: 500Gi
storageClass: longhorn
users:
appuser:
- superuser
- createdb
replicator: []
databases:
appdb: appuser
postgresql:
version: "16"
parameters:
shared_buffers: "16GB"
effective_cache_size: "48GB"
work_mem: "256MB"
maintenance_work_mem: "2GB"
max_connections: "200"
max_wal_senders: "10"
wal_level: replica
synchronous_commit: "on"
wal_keep_size: "2GB"
archive_mode: "on"
track_commit_timestamp: "on"
patroni:
ttl: 30
loop_wait: 10
retry_timeout: 10
maximum_lag_on_failover: 1048576
synchronous_mode: true
resources:
requests:
cpu: "4"
memory: 32Gi
limits:
cpu: "8"
memory: 64GiKeepalive สำหรับ HAProxy VIP
# /etc/keepalived/keepalived.conf on lb1
vrrp_script chk_haproxy {
    script "killall -0 haproxy"
    interval 2
    weight 2
}

vrrp_instance VI_PG {
    state MASTER
    interface eth0
    virtual_router_id 52
    priority 100
    advert_int 1
    authentication {
        auth_type PASS
        auth_pass pgha_vip_pass
    }
    virtual_ipaddress {
        10.0.0.100/24
    }
    track_script {
        chk_haproxy
    }
}
การตรวจสอบการจำลอง PostgreSQL
การตรวจสอบความสมบูรณ์ของการจำลองแบบไม่สามารถต่อรองได้ในการผลิต PostgreSQL มีมุมมองในตัวหลายรายการสำหรับจุดประสงค์นี้ และ Prometheus พร้อม Grafana ให้การมองเห็นในระยะยาวและการแจ้งเตือนที่คุณต้องการ
แบบสอบถามการตรวจสอบในตัว
-- Check replication status on the primary
SELECT
    client_addr,
    application_name,
    state,
    sync_state,
    sent_lsn,
    write_lsn,
    flush_lsn,
    replay_lsn,
    (sent_lsn - replay_lsn) AS replication_lag_bytes,
    write_lag,
    flush_lag,
    replay_lag
FROM pg_stat_replication;

-- Check replication slot status
SELECT
    slot_name,
    slot_type,
    active,
    wal_status,
    pg_size_pretty(pg_wal_lsn_diff(pg_current_wal_lsn(), restart_lsn)) AS slot_lag
FROM pg_replication_slots;

-- Check standby recovery status (run on standby)
SELECT
    pg_is_in_recovery() AS is_standby,
    pg_last_wal_receive_lsn() AS last_received,
    pg_last_wal_replay_lsn() AS last_replayed,
    pg_last_xact_replay_timestamp() AS last_replayed_timestamp,
    EXTRACT(EPOCH FROM (now() - pg_last_xact_replay_timestamp()))::int AS replay_lag_seconds;

-- Monitor WAL generation rate
SELECT
    pg_size_pretty(pg_wal_lsn_diff(pg_current_wal_lsn(), '0/0')) AS total_wal_generated,
    pg_size_pretty(sum(size)) AS wal_directory_size
FROM pg_ls_waldir();

-- Check for long-running queries that could block replication
SELECT
    pid,
    now() - pg_stat_activity.query_start AS duration,
    query,
    state
FROM pg_stat_activity
WHERE (now() - pg_stat_activity.query_start) > interval '5 minutes'
  AND state != 'idle'
ORDER BY duration DESC;
Prometheus และ Grafana สแต็ค
postgres_exporterแสดงเมตริก PostgreSQL ในรูปแบบ Prometheus เมื่อใช้ร่วมกับPatroni_exporterคุณจะมองเห็นทั้งประสิทธิภาพของฐานข้อมูลและสถานะคลัสเตอร์ HA ได้อย่างสมบูรณ์
# Deploy postgres_exporter as a sidecar or standalone
helm repo add prometheus-community https://prometheus-community.github.io/helm-charts

# Custom queries for postgres_exporter
# /etc/postgres_exporter/queries.yaml
pg_replication_lag:
  query: |
    SELECT
      CASE WHEN pg_is_in_recovery() THEN
        EXTRACT(EPOCH FROM (now() - pg_last_xact_replay_timestamp()))::float
      ELSE 0 END AS lag_seconds
  master: true
  metrics:
    - lag_seconds:
        usage: "GAUGE"
        description: "Replication lag in seconds"

pg_replication_slots:
  query: |
    SELECT
      slot_name,
      active::int AS active,
      pg_wal_lsn_diff(pg_current_wal_lsn(), restart_lsn)::float AS slot_lag_bytes
    FROM pg_replication_slots
  master: true
  metrics:
    - slot_name:
        usage: "LABEL"
    - active:
        usage: "GAUGE"
        description: "Whether the slot is active"
    - slot_lag_bytes:
        usage: "GAUGE"
        description: "Slot lag in bytes"
# PrometheusRule for PostgreSQL HA alerts
apiVersion: monitoring.coreos.com/v1
kind: PrometheusRule
metadata:
name: postgresql-ha-alerts
namespace: monitoring
spec:
groups:
- name: postgresql-replication
rules:
- alert: PostgreSQLReplicationLagHigh
expr: pg_replication_lag_seconds > 30
for: 5m
labels:
severity: warning
annotations:
summary: "PostgreSQL replication lag exceeds 30s on {{ $labels.instance }}"
- alert: PostgreSQLReplicationSlotInactive
expr: pg_replication_slots_active == 0
for: 5m
labels:
severity: critical
annotations:
summary: "Replication slot {{ $labels.slot_name }} is inactive"
- alert: PostgreSQLReplicationSlotLagHigh
expr: pg_replication_slots_slot_lag_bytes > 1073741824
for: 10m
labels:
severity: warning
annotations:
summary: "Replication slot lag exceeds 1GB on {{ $labels.slot_name }}"
- alert: PatroniClusterUnhealthy
expr: patroni_cluster_members_count < 3
for: 2m
labels:
severity: critical
annotations:
summary: "Patroni cluster has fewer than 3 members"พารามิเตอร์การปรับแต่งการผลิต
การกำหนดค่าเริ่มต้นของPostgreSQL เป็นแบบอนุรักษ์นิยม ได้รับการปรับแต่งสำหรับสภาพแวดล้อมโฮสติ้งที่ใช้ร่วมกันขนาดเล็ก คลัสเตอร์ HA ที่ใช้งานจริงจำเป็นต้องมีการปรับแต่งการจำลอง หน่วยความจำ และพารามิเตอร์ WAL อย่างระมัดระวัง ตารางต่อไปนี้สรุปการตั้งค่าที่สำคัญที่สุดสำหรับเซิร์ฟเวอร์ RAM ขนาด 64GB พร้อมพื้นที่จัดเก็บ NVMe
# postgresql.conf — Production HA tuning

# === Replication ===
wal_level = replica
max_wal_senders = 10
max_replication_slots = 10
wal_keep_size = 4GB
synchronous_commit = on
synchronous_standby_names = 'ANY 1 (standby1, standby2)'
track_commit_timestamp = on
wal_log_hints = on

# === WAL ===
min_wal_size = 1GB
max_wal_size = 8GB
wal_buffers = 64MB
wal_compression = zstd
archive_mode = on
archive_timeout = 300
checkpoint_completion_target = 0.9
checkpoint_timeout = 15min

# === Memory ===
shared_buffers = 16GB              # 25% of RAM
effective_cache_size = 48GB        # 75% of RAM
work_mem = 256MB                   # per-operation sort/hash memory
maintenance_work_mem = 2GB         # for VACUUM, CREATE INDEX
huge_pages = try

# === Connections ===
max_connections = 200              # use PgBouncer for higher client counts
superuser_reserved_connections = 5

# === Query Performance ===
random_page_cost = 1.1             # SSD storage
effective_io_concurrency = 200     # NVMe SSD
default_statistics_target = 500
jit = on

# === Logging ===
log_min_duration_statement = 500   # log queries > 500ms
log_checkpoints = on
log_connections = on
log_disconnections = on
log_lock_waits = on
log_temp_files = 0
log_autovacuum_min_duration = 0

# === Autovacuum ===
autovacuum_max_workers = 4
autovacuum_naptime = 30s
autovacuum_vacuum_cost_limit = 2000
autovacuum_vacuum_scale_factor = 0.05
autovacuum_analyze_scale_factor = 0.02
การปรับพารามิเตอร์ Patroni DCS
ความสัมพันธ์ระหว่างพารามิเตอร์ttl,loop_waitและretry_timeoutของ Patroni ส่งผลโดยตรงต่อความเร็วการเฟลโอเวอร์และความเสี่ยงที่เป็นผลบวกลวง TTL ที่สั้นกว่าหมายถึงการตรวจจับการเฟลโอเวอร์ที่เร็วขึ้น แต่เพิ่มความเสี่ยงของการเฟลโอเวอร์ที่ไม่จำเป็นในระหว่างที่เครือข่ายขัดข้องในช่วงสั้นๆ
# Conservative (production default)
ttl: 30
loop_wait: 10
retry_timeout: 10
# Failover detection: ~30-40 seconds

# Aggressive (low-latency failover)
ttl: 15
loop_wait: 5
retry_timeout: 5
# Failover detection: ~15-20 seconds
# Warning: Higher risk of false failovers in unstable networks
Chaos Engineering และการทดสอบข้อผิดพลาด
ระบบเฟลโอเวอร์ที่ไม่เคยทดสอบคือระบบที่ใช้งานไม่ได้ Chaos Engineering ใช้ความล้มเหลวที่ได้รับการควบคุมเพื่อตรวจสอบว่าการตั้งค่า HA ของคุณทำงานได้อย่างถูกต้องภายใต้เงื่อนไขความล้มเหลวจริง คลัสเตอร์ Patroni ทุกคลัสเตอร์ควรได้รับการฝึกซ้อมเฟลโอเวอร์เป็นประจำ
คู่มือการทดสอบความล้มเหลว
# 1. Verify cluster health before testing
patronictlctl -c /etc/patroni/patroni.yml list
+----------+---------+---------+----+-----------+
| Member   | Host    | Role    | TL | Lag in MB |
+----------+---------+---------+----+-----------+
| node1    | 10.0.1.10| Leader |  5 |           |
| node2    | 10.0.1.11| Replica |  5 |         0 |
| node3    | 10.0.1.12| Replica |  5 |         0 |
+----------+---------+---------+----+-----------+

# 2. Simulate primary crash (on node1)
sudo systemctl stop patroni
# Or more aggressive: sudo kill -9 $(pgrep -f patroni)

# 3. Monitor failover (from any node with patronictl)
watch -n 1 'patronictl -c /etc/patroni/patroni.yml list'

# 4. Verify new leader is elected (within 30-45 seconds)
# Expected: node2 or node3 promoted to Leader

# 5. Test write availability through HAProxy
PGPASSWORD=app_password psql -h haproxy-host -p 5000 -U appuser -d appdb \
  -c "INSERT INTO health_check (ts) VALUES (now()) RETURNING *;"

# 6. Restart the former primary
sudo systemctl start patroni
# Patroni will use pg_rewind to rejoin as a replica

# 7. Verify the former primary rejoins as replica
patronictlctl -c /etc/patroni/patroni.yml list
การทดสอบพาร์ติชันเครือข่าย
# Simulate network partition on the primary using iptables
# Block all traffic to etcd from the primary
sudo iptables -A OUTPUT -d 10.0.2.10 -j DROP
sudo iptables -A OUTPUT -d 10.0.2.11 -j DROP
sudo iptables -A OUTPUT -d 10.0.2.12 -j DROP

# Expected behaviour:
# 1. Primary loses DCS access
# 2. Leader key TTL expires
# 3. Primary demotes itself (with watchdog, node may reboot)
# 4. Standby acquires leader lock and promotes
# 5. After clearing iptables rules, former primary rejoins as replica

# Clean up
sudo iptables -D OUTPUT -d 10.0.2.10 -j DROP
sudo iptables -D OUTPUT -d 10.0.2.11 -j DROP
sudo iptables -D OUTPUT -d 10.0.2.12 -j DROP
การทดสอบความโกลาหลอัตโนมัติด้วย Toxiproxy
# Run Toxiproxy alongside your Patroni cluster
# Create proxies for etcd and replication connections
toxiproxy-cli create etcd_proxy -l 0.0.0.0:12379 -u 10.0.2.10:2379
toxiproxy-cli create pg_repl_proxy -l 0.0.0.0:15432 -u 10.0.1.10:5432

# Add latency to etcd connections (simulates degraded network)
toxiproxy-cli toxic add etcd_proxy -t latency -a latency=500 -a jitter=200

# Add bandwidth limit to replication (simulates WAN replication)
toxiproxy-cli toxic add pg_repl_proxy -t bandwidth -a rate=1024

# Completely sever the connection (simulates network partition)
toxiproxy-cli toxic add etcd_proxy -t timeout -a timeout=0

# Monitor Patroni behaviour and verify correct failover
watch -n 2 'curl -s http://10.0.1.10:8008/patroni | python3 -m json.tool'
สคริปต์ตรวจสอบอย่างต่อเนื่อง
#!/bin/bash
# continuous_ha_check.sh — Run during chaos tests to measure availability

HAPROXY_HOST="10.0.0.100"
WRITE_PORT=5000
READ_PORT=5001
DATABASE="appdb"
USER="appuser"
LOGFILE="/var/log/ha_test_$(date +%Y%m%d_%H%M%S).log"

write_count=0
write_fail=0
read_count=0
read_fail=0

while true; do
    ts=$(date '+%Y-%m-%d %H:%M:%S.%3N')

    # Test write path
    if PGPASSWORD=app_password psql -h $HAPROXY_HOST -p $WRITE_PORT \
       -U $USER -d $DATABASE -c "SELECT 1" &>/dev/null; then
        ((write_count++))
    else
        ((write_fail++))
        echo "$ts WRITE_FAIL total_fails=$write_fail" >> $LOGFILE
    fi

    # Test read path
    if PGPASSWORD=app_password psql -h $HAPROXY_HOST -p $READ_PORT \
       -U $USER -d $DATABASE -c "SELECT 1" &>/dev/null; then
        ((read_count++))
    else
        ((read_fail++))
        echo "$ts READ_FAIL total_fails=$read_fail" >> $LOGFILE
    fi

    total=$((write_count + write_fail))
    if (( total % 100 == 0 )); then
        write_avail=$(echo "scale=2; $write_count * 100 / $total" | bc)
        read_total=$((read_count + read_fail))
        read_avail=$(echo "scale=2; $read_count * 100 / $read_total" | bc)
        echo "$ts Writes: ${write_avail}% ($write_count/$total) Reads: ${read_avail}% ($read_count/$read_total)"
    fi

    sleep 0.5
done
ขั้นสูง: การจำลองแบบเรียงซ้อนและการสแตนด์บายแบบหน่วงเวลา
สำหรับคลัสเตอร์ขนาดใหญ่ การจำลองแบบเรียงซ้อนจะช่วยลดภาระบนคลัสเตอร์หลัก แทนที่จะแสตนด์บายทั้งหมดที่เรพลิเคตโดยตรงจากแสตนด์บายหลัก แสตนด์บายบางตัวจะจำลองจากแสตนด์บายอื่นๆ สิ่งนี้จะสร้างโทโพโลยีแบบทรีโดยที่ฟีดหลักจะฟีดสแตนด์บาย 2 รายการ และสแตนด์บายเหล่านั้นจะฟีดสแตนด์บายดาวน์สตรีมเพิ่มเติม
# postgresql.auto.conf on a cascading standby
primary_conninfo = 'host=standby1-host port=5432 user=replicator application_name=cascade1'
primary_slot_name = 'cascade1_slot'สแตนด์บายล่าช้าจงใจใช้บันทึก WAL โดยมีการหน่วงเวลา — โดยทั่วไปคือ 1-4 ชั่วโมง ซึ่งจะช่วยป้องกันข้อผิดพลาดเชิงตรรกะ (การลบโดยไม่ตั้งใจ การย้ายข้อมูลที่ไม่ดี) ที่ถูกจำลองแบบทันทีไปยังสแตนด์บายแบบซิงโครนัส หากเกิดภัยพิบัติ คุณสามารถหยุดการเล่นซ้ำ WAL บนสแตนด์บายที่ล่าช้า และกู้คืนข้อมูลก่อนที่จะเกิดข้อผิดพลาดได้
# postgresql.conf on delayed standby
recovery_min_apply_delay = '1h'
กลยุทธ์สตริงการเชื่อมต่อ
แอปพลิเคชันที่เชื่อมต่อกับคลัสเตอร์ที่จัดการโดย Patroni ควรเชื่อมต่อผ่าน HAProxy เสมอ หรือใช้สตริงการเชื่อมต่อหลายโฮสต์ในตัวของ PostgreSQL กับtarget_session_attrsสิ่งนี้จัดให้มีการเฟลโอเวอร์ฝั่งไคลเอ็นต์โดยไม่ต้องขึ้นอยู่กับโหลดบาลานเซอร์
# Multi-host connection string with target_session_attrs
# The client tries each host in order and connects to the one matching the target attribute
postgresql://appuser:password@node1:5432,node2:5432,node3:5432/appdb?target_session_attrs=read-write&sslmode=require

# For read-only connections
postgresql://appuser:password@node1:5432,node2:5432,node3:5432/appdb?target_session_attrs=prefer-standby&sslmode=require
วิธีการนี้ใช้ได้ผลดีกับแอปพลิเคชันที่ไม่สามารถกำหนดค่าใหม่ให้ชี้ไปที่ HAProxy VIP ได้อย่างง่ายดาย ไลบรารีไคลเอ็นต์ PostgreSQL (libpq) จัดการการเฟลโอเวอร์อย่างโปร่งใส
เสริมความปลอดภัย
คลัสเตอร์ PostgreSQL HA ที่ใช้งานจริงจะต้องบังคับใช้การเข้ารหัสระหว่างการส่งผ่านและที่เหลือ ใช้การตรวจสอบสิทธิ์ที่รัดกุม และจำกัดการเปิดเผยเครือข่าย
# Enable TLS in postgresql.conf
ssl = on
ssl_cert_file = '/etc/postgresql/certs/server.crt'
ssl_key_file = '/etc/postgresql/certs/server.key'
ssl_ca_file = '/etc/postgresql/certs/ca.crt'
ssl_min_protocol_version = 'TLSv1.3'

# Require TLS for all connections in pg_hba.conf
hostssl replication replicator 10.0.0.0/16 scram-sha-256
hostssl all         all        10.0.0.0/16 scram-sha-256

# etcd TLS
# In Patroni config
etcd3:
  hosts:
    - 10.0.2.10:2379
    - 10.0.2.11:2379
    - 10.0.2.12:2379
  protocol: https
  cacert: /etc/patroni/certs/etcd-ca.crt
  cert: /etc/patroni/certs/etcd-client.crt
key: /etc/patroni/certs/etcd-client.keyสำหรับคลัสเตอร์ HA
กลยุทธ์การสำรองข้อมูลที่ครอบคลุมสำหรับคลัสเตอร์ Patroni ควรรวมถึงการเก็บถาวร WAL อย่างต่อเนื่อง การสำรองข้อมูลเต็มรูปแบบเป็นประจำ และการสำรองข้อมูลส่วนต่างหรือส่วนเพิ่มระหว่างการสำรองข้อมูลเต็มรูปแบบ pgBackRest เป็นเครื่องมือที่แนะนำสำหรับการจัดการการสำรองข้อมูล PostgreSQL ที่ใช้งานจริง
# Schedule backups via cron
# Full backup weekly (Sunday 2 AM)
0 2 * * 0 pgbackrest --stanza=pg-ha-cluster --type=full backup

# Differential backup daily (2 AM, Mon-Sat)
0 2 * * 1-6 pgbackrest --stanza=pg-ha-cluster --type=diff backup

# Verify backup integrity
pgbackrest --stanza=pg-ha-cluster --set=latest info

# Verify backup can be restored (dry run)
pgbackrest --stanza=pg-ha-cluster --set=latest verify

# List all backups
pgbackrest --stanza=pg-ha-cluster info
            full backup: 20260412-020000F
                timestamp: 2026-04-12 02:00:00 +0000
                wal start/stop: 000000050000000000000040 / 000000050000000000000042
                database size: 150GB, backup size: 150GB
                repository size: 45GB (compressed)
            diff backup: 20260412-020000F_20260413-020000D
                timestamp: 2026-04-13 02:00:00 +0000
                database size: 151GB, backup size: 2.1GB
                repository size: 650MB (compressed)
สรุปรันบุ๊กการปฏิบัติงาน
ทุกทีมที่รันคลัสเตอร์ Patroni ควรดูแลรักษารันบุ๊กที่ครอบคลุมสถานการณ์ต่อไปนี้ การมีขั้นตอนที่ผ่านการทดสอบและบันทึกไว้จะเปลี่ยนการหยุดทำงานที่ตึงเครียดให้กลายเป็นการปฏิบัติงานตามปกติ
# === Quick Reference Commands ===

# Cluster status
patronictlctl -c /etc/patroni/patroni.yml list
patronictlctl -c /etc/patroni/patroni.yml history

# Planned switchover
patronictlctl -c /etc/patroni/patroni.yml switchover --master node1 --candidate node2

# Restart PostgreSQL on a specific node (rolling restart)
patronictlctl -c /etc/patroni/patroni.yml restart pg-ha-cluster node2

# Reload PostgreSQL configuration without restart
patronictlctl -c /etc/patroni/patroni.yml reload pg-ha-cluster

# Pause automatic failover (during maintenance)
patronictlctl -c /etc/patroni/patroni.yml pause

# Resume automatic failover
patronictlctl -c /etc/patroni/patroni.yml resume

# Edit DCS configuration (applies to all nodes)
patronictlctl -c /etc/patroni/patroni.yml edit-config

# Reinitialise a failed replica
patronictlctl -c /etc/patroni/patroni.yml reinit pg-ha-cluster node3

# Check Patroni REST API directly
curl -s http://10.0.1.10:8008/patroni | python3 -m json.tool
curl -s http://10.0.1.10:8008/cluster | python3 -m json.tool
การเปรียบเทียบประสิทธิภาพ
ก่อนเริ่มใช้งานจริง ให้เปรียบเทียบคลัสเตอร์ HA ของคุณเพื่อสร้างประสิทธิภาพพื้นฐาน และตรวจสอบว่าเวลาแฝงของการจำลองแบบซิงโครนัสเป็นที่ยอมรับสำหรับปริมาณงานของคุณ
# Benchmark with pgbench — initialise test data
pgbench -i -s 100 -h haproxy-host -p 5000 -U appuser appdb

# Run write-heavy benchmark (measures sync replication impact)
pgbench -h haproxy-host -p 5000 -U appuser -c 32 -j 8 -T 300 appdb
# Compare with async: temporarily set synchronous_commit = off

# Run read-only benchmark through read replica port
pgbench -h haproxy-host -p 5001 -U appuser -c 64 -j 16 -T 300 -S appdb

# Measure failover impact on transactions
# Run pgbench in background, then trigger a failover
pgbench -h haproxy-host -p 5000 -U appuser -c 8 -j 4 -T 600 appdb &
sleep 60 && patronictl switchover --master node1 --candidate node2 --force
สรุป
PostgreSQL ความพร้อมใช้งานสูงแบบเนทีฟกับ Patroni ไม่ใช่โซลูชันเครื่องมือเดียว แต่เป็นระบบบูรณาการของการจำลองแบบสตรีมมิ่ง การตกลงแบบกระจาย การกำหนดเส้นทางการเชื่อมต่อ การรวมการเชื่อมต่อ การเก็บถาวร WAL การตรวจสอบ และวินัยในการปฏิบัติงาน แต่ละเลเยอร์จะจัดการกับโหมดความล้มเหลวเฉพาะ: การจำลองแบบสตรีมมิ่งจะจัดการความซ้ำซ้อนของข้อมูล, Patroni จัดการการประสานงานเมื่อเกิดข้อผิดพลาดโดยอัตโนมัติ ฯลฯ มอบฉันทามติแบบกระจายที่จำเป็นสำหรับการเลือกตั้งผู้นำโดยไม่ต้องแยกสมอง, HAProxy กำหนดเส้นทางการเชื่อมต่อไปยังผู้นำที่ถูกต้อง, PgBouncer จัดการโอเวอร์เฮดการเชื่อมต่อตามขนาด และการเก็บถาวร WAL ด้วย pgBackRest มอบบรรทัดสุดท้ายของการป้องกันข้อผิดพลาดเชิงตรรกะและการกู้คืนจากความเสียหาย
รูปแบบการปรับใช้แตกต่างกันไปตามสภาพแวดล้อม — AWS พร้อม NLB และ Route53, Azure พร้อม Availability Zones และ Azure Load Balancer, GCP พร้อมกลุ่มอินสแตนซ์ที่ได้รับการจัดการระดับภูมิภาค หรือ Bare Metal พร้อม k3s, Longhorn และ Keepalived — แต่สถาปัตยกรรมหลักยังคงเหมือนเดิม โหนด PostgreSQL อย่างน้อย 3 โหนดที่จัดการโดย Patroni ซึ่งได้รับการสนับสนุนโดยคลัสเตอร์ ฯลฯ 3 โหนด โดยมีโหลดบาลานเซอร์อยู่ด้านหน้าซึ่งติดตามจุดสิ้นสุดการตรวจสอบสภาพของ Patroni
การลงทุนที่สำคัญที่สุดที่คุณสามารถทำได้ไม่ได้อยู่ที่การกำหนดค่า แต่อยู่ในการทดสอบ ดำเนินการฝึกซ้อมเฟลโอเวอร์ทุกเดือน ฉีดพาร์ติชันเครือข่าย ฆ่ากระบวนการโดยไม่คาดคิด วัดเวลาในการกู้คืนและการสูญหายของข้อมูล สร้างแดชบอร์ดที่แสดงความล่าช้าในการจำลอง อัตราการสร้าง WAL ความอิ่มตัวของพูลการเชื่อมต่อ และสถานภาพ DCS แบบเรียลไทม์ ความมั่นใจที่คุณได้รับจากการทดสอบอย่างเป็นระบบคือสิ่งที่แยกคลัสเตอร์ที่รอดพ้นจากการหยุดทำงานจริงครั้งแรกออกจากคลัสเตอร์ที่เปลี่ยนความล้มเหลวของเซิร์ฟเวอร์ให้กลายเป็นเหตุการณ์ที่ส่งผลกระทบต่อธุรกิจ
PostgreSQL ให้การจำลองแบบดั้งเดิมทั้งหมดแก่คุณ Patroni ให้คุณเรียบเรียง ฯลฯ ให้ความเห็นเป็นเอกฉันท์แก่คุณ งานของคุณคือเชื่อมโยงเข้าด้วยกันอย่างถูกต้อง ปรับแต่งให้เหมาะกับปริมาณงานของคุณ และตรวจสอบความถูกต้องอย่างต่อเนื่อง คู่มือนี้ได้ให้พิมพ์เขียวแก่คุณ — ตอนนี้สร้าง ทดสอบ และดำเนินการด้วยความมั่นใจ
เพิ่มเติมจากบล็อก

Observability Is Not Optional: Make It a Business Standard
Why fragmented monitoring creates blind spots, duplicate spend, and slow incidents — and how to make centralised observability a non-negotiable company standard.

WSL Vault for Compliance: One Tenant Never Opens Another’s Secrets
How WSL Vault keeps app, team, and environment tenants cryptographically isolated — so a stolen root-style token cannot empty the estate — and why dual-tenant control beats secrets sprawl.

Workstation AI Shop: Promoting the AI Sales Storefront Through int → test → acc → prod
Workstation AI Shop sells GPU machines with a fully autonomous AI Sales Agent that configures the basket. See how Ring Promoter moves each build through int → test → acc → prod — with Orbit screenshots release engineers and stakeholders share.