บล็อก
PostgreSQL ความพร้อมใช้งานสูงพร้อมข้อมูลที่กรุบกรอบ PGO: การปรับใช้ Kubernetes ระดับองค์กร
PostgreSQL HA ระดับองค์กรพร้อม Crunchy Data PGO บน Kubernetes
ในหน้านี้
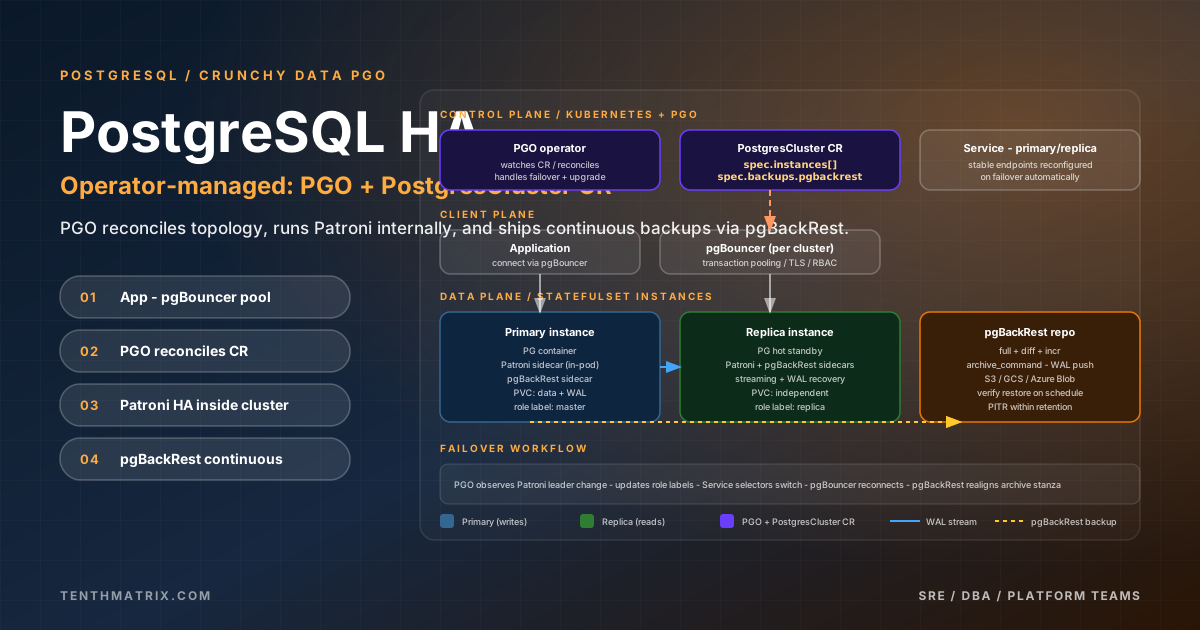
การรัน PostgreSQL ในการใช้งานจริงบน Kubernetes ต้องการมากกว่า StatefulSet ที่มีวอลุ่มถาวร คุณต้องมีการเปลี่ยนระบบอัตโนมัติ การสำรองข้อมูลอย่างต่อเนื่องและการกู้คืนแบบช่วงเวลา การรวมการเชื่อมต่อ การเข้ารหัส TLS การตรวจสอบ และความสามารถในการปรับใช้อย่างสม่ำเสมอระหว่างผู้ให้บริการระบบคลาวด์และ Bare Metal Crunchy Data PGO (Postgres Operator) v5 มอบทั้งหมดนี้ผ่านทรัพยากรแบบกำหนดเอง Kubernetes เดียว —PostgresClusterCRD — ซึ่งได้รับการสนับสนุนโดยส่วนประกอบที่ผ่านการทดสอบการต่อสู้: Patroni สำหรับ HA ตามฉันทามติ, pgBackRest สำหรับการสำรองข้อมูลระดับองค์กร, PgBouncer สำหรับการรวมการเชื่อมต่อ และ pgMonitor สำหรับความสามารถในการสังเกตที่เข้ากันได้กับ Prometheus
คู่มือนี้ครอบคลุมทุกสิ่งที่จำเป็นในการใช้คลัสเตอร์ PostgreSQL ที่จัดการโดย PGO ตั้งแต่การใช้งานครั้งแรกไปจนถึงการดำเนินการระดับการผลิตทั่วทั้ง AWS EKS, Azure AKS, GCP GKE และ Bare Metal k3s พร้อม Rancher ทุกส่วนประกอบด้วยค่า YAML, Helm ที่เป็นรูปธรรม และขั้นตอนการปฏิบัติงานที่คุณสามารถปรับให้เข้ากับสภาพแวดล้อมของคุณได้
ข้อมูลกรุบกรอบสถาปัตยกรรม PGO v5
PGO v5 เป็นการเขียนใหม่ของ Crunchy Postgres Operator โดยแทนที่ pgcluster/pgreplica/pgpolicy CRDs ก่อนหน้าด้วยทรัพยากรPostgresClusterเดียวที่อธิบายทุกแง่มุมของการปรับใช้ PostgreSQL อย่างเปิดเผย ผู้ปฏิบัติงานจะคอยดูการเปลี่ยนแปลงในทรัพยากรนี้และปรับสมดุลออบเจ็กต์ Kubernetes ที่เกี่ยวข้อง — StatefulSets, Services, ConfigMaps, Secrets, Jobs — เพื่อให้ตรงกับสถานะที่ต้องการ
สถาปัตยกรรมถูกสร้างขึ้นบนเสาสี่เสาPatroniทำงานเป็นรถเทียมข้างรถจักรยานยนต์ในพ็อด PostgreSQL ทุกตัว และจัดการการเลือกผู้นำ โทโพโลยีการจำลอง และเฟลโอเวอร์อัตโนมัติโดยใช้ฉันทามติแบบกระจาย Kubernetes ดั้งเดิมpgBackRestจัดการการสำรองข้อมูลเต็มรูปแบบ ส่วนต่าง และการสำรองข้อมูลส่วนเพิ่ม รวมถึงการเก็บถาวร WAL อย่างต่อเนื่องไปยังพื้นที่จัดเก็บอ็อบเจ็กต์ (S3, GCS, Azure Blob) หรือ PVC ภายในเครื่องPgBouncerมอบการรวมการเชื่อมต่อน้ำหนักเบาที่ป้องกัน PostgreSQL จากพายุการเชื่อมต่อpgMonitorเปิดเผยตัววัด PostgreSQL ผ่านตัวช่วยส่งออก Prometheus เพื่อบูรณาการกับสแต็กความสามารถในการสังเกตที่มีอยู่ของคุณ
ตัวดำเนินการเองไม่มีสถานะ — สถานะถาวรทั้งหมดอยู่ในคลัสเตอร์ PostgreSQL และที่เก็บข้อมูลสำรอง ซึ่งหมายความว่าคุณสามารถอัปเกรดหรือรีสตาร์ทตัวดำเนินการได้โดยไม่กระทบต่อฐานข้อมูลที่ทำงานอยู่ ลูปการกระทบยอดตัวดำเนินการเป็นแบบ idempotent: การใช้ข้อมูลจำเพาะPostgresClusterเดียวกันหลายครั้งจะสร้างอ็อบเจ็กต์ Kubernetes ชุดเดียวกัน
กำลังติดตั้ง PGO v5
PGO v5 สามารถติดตั้งผ่าน Helm หรือรายการ kubectl โดยตรง แนวทาง Helm เป็นที่ต้องการสำหรับการผลิต เนื่องจากผสานรวมกับเวิร์กโฟลว์ GitOps ได้อย่างสมบูรณ์ และให้การอัปเกรดที่ควบคุมเวอร์ชัน
# Add the Crunchy Data Helm repository
helm repo add crunchydata https://charts.crunchydata.com
helm repo update

# Install PGO into its own namespace
helm install pgo crunchydata/pgo \
  --namespace postgres-operator \
  --create-namespace \
  --set controllerImages.cluster=registry.crunchydata.com/crunchydata/postgres-operator:ubi8-5.7.2-0 \
  --set relatedImages.postgres_16=registry.crunchydata.com/crunchydata/crunchy-postgres:ubi8-16.6-1 \
  --set relatedImages.pgbackrest=registry.crunchydata.com/crunchydata/crunchy-pgbackrest:ubi8-2.54.1-0 \
  --set relatedImages.pgbouncer=registry.crunchydata.com/crunchydata/crunchy-pgbouncer:ubi8-1.23.1-0 \
  --set relatedImages.pgexporter=registry.crunchydata.com/crunchydata/crunchy-postgres-exporter:ubi8-0.16.0-0
สำหรับสภาพแวดล้อมที่มีช่องว่างอากาศ ให้มิเรอร์อิมเมจที่ต้องการไปยังรีจิสตรีภายในของคุณ และอัปเดตค่าrelatedImagesตามนั้น PGO จะดึงเฉพาะรูปภาพที่ระบุในค่า Helm หรือข้อมูลจำเพาะPostgresClusterเท่านั้น โดยจะไม่เข้าถึงรีจิสทรีภายนอกขณะรันไทม์ เว้นแต่จะได้รับการกำหนดค่าอย่างชัดเจนให้ทำเช่นนั้น
# Verify the operator is running
kubectl get pods -n postgres-operator
NAME                                READY   STATUS    RESTARTS   AGE
pgo-controller-manager-7d8f9b6c4-xk2pt   1/1     Running   0          45s
Postgresคลัสเตอร์ CRD ข้อมูลจำเพาะ
PostgresClusterCRD เป็นพื้นผิวการประกาศเดียวสำหรับการปรับใช้ PostgreSQL ทั้งหมดของคุณ ด้านล่างนี้คือข้อกำหนดเฉพาะที่พร้อมสำหรับการผลิตซึ่งสาธิตส่วนสำคัญๆ แต่ละส่วนจะมีการกล่าวถึงโดยละเอียดในส่วนต่อๆ ไปของคู่มือนี้
apiVersion: postgres-operator.crunchydata.com/v1beta1
kind: PostgresCluster
metadata:
  name: production-db
  namespace: databases
spec:
  postgresVersion: 16
  image: registry.crunchydata.com/crunchydata/crunchy-postgres:ubi8-16.6-1

  instances:
    - name: pgha1
      replicas: 3
      resources:
        requests:
          cpu: "2"
          memory: 8Gi
        limits:
          cpu: "4"
          memory: 16Gi
      dataVolumeClaimSpec:
        storageClassName: gp3-csi
        accessModes: ["ReadWriteOnce"]
        resources:
          requests:
            storage: 100Gi
      walVolumeClaimSpec:
        storageClassName: gp3-csi
        accessModes: ["ReadWriteOnce"]
        resources:
          requests:
            storage: 20Gi
      affinity:
        podAntiAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
            - topologyKey: kubernetes.io/hostname
              labelSelector:
                matchLabels:
                  postgres-operator.crunchydata.com/cluster: production-db
      tolerations:
        - key: "workload"
          operator: "Equal"
          value: "database"
          effect: "NoSchedule"

  backups:
    pgbackrest:
      image: registry.crunchydata.com/crunchydata/crunchy-pgbackrest:ubi8-2.54.1-0
      configuration:
        - secret:
            name: pgbackrest-s3-creds
      global:
        repo1-retention-full: "7"
        repo1-retention-diff: "14"
        repo1-path: /pgbackrest/production-db/repo1
        repo1-s3-uri-style: path
      repos:
        - name: repo1
          schedules:
            full: "0 2 * * 0"         # Sunday 2am
            differential: "0 2 * * 1-6" # Mon-Sat 2am
            incremental: "0 */4 * * *"  # Every 4 hours
          s3:
            bucket: mycompany-pg-backups
            endpoint: s3.eu-west-1.amazonaws.com
            region: eu-west-1

  proxy:
    pgBouncer:
      image: registry.crunchydata.com/crunchydata/crunchy-pgbouncer:ubi8-1.23.1-0
      replicas: 2
      resources:
        requests:
          cpu: 500m
          memory: 256Mi
        limits:
          cpu: "1"
          memory: 512Mi
      config:
        global:
          pool_mode: transaction
          max_client_conn: "1000"
          default_pool_size: "25"
          min_pool_size: "5"
          reserve_pool_size: "5"
          reserve_pool_timeout: "3"

  monitoring:
    pgmonitor:
      exporter:
        image: registry.crunchydata.com/crunchydata/crunchy-postgres-exporter:ubi8-0.16.0-0
        resources:
          requests:
            cpu: 100m
            memory: 128Mi

  patroni:
    dynamicConfiguration:
      synchronous_mode: true
      postgresql:
        parameters:
          shared_buffers: 2GB
          effective_cache_size: 6GB
          work_mem: 32MB
          maintenance_work_mem: 512MB
          max_connections: 200
          wal_buffers: 64MB
          checkpoint_completion_target: 0.9
          random_page_cost: 1.1
          effective_io_concurrency: 200
          min_wal_size: 1GB
          max_wal_size: 4GB
          max_worker_processes: 8
          max_parallel_workers_per_gather: 4
          max_parallel_workers: 8
          log_min_duration_statement: 500
          log_checkpoints: "on"
          log_connections: "on"
          log_disconnections: "on"
          log_lock_waits: "on"

  users:
    - name: appuser
      databases: ["appdb"]
      options: "NOSUPERUSER"
    - name: readonly
      databases: ["appdb"]
      options: "NOSUPERUSER"

  databaseInitSQL:
    name: init-sql-configmap
    key: init.sql
ข้อมูลจำเพาะนี้สร้างคลัสเตอร์ PostgreSQL 16 สามอินสแตนซ์ที่มีข้อมูลและวอลุ่ม WAL แยกกัน, การสำรองข้อมูล S3 ที่สำรองไว้ตามกำหนดเวลาแบบเต็ม/ส่วนต่าง/ส่วนเพิ่ม, การรวมการเชื่อมต่อ PgBouncer ในโหมดธุรกรรม, การส่งออกตัววัด Prometheus และการจำลองแบบซิงโครนัส Patroni กฎการต่อต้านความสัมพันธ์ของพ็อดช่วยให้แน่ใจว่าทั้งสามอินสแตนซ์ลงจอดบนโหนด Kubernetes ที่แตกต่างกัน
Patroni-Based HA และเฟลโอเวอร์อัตโนมัติ
Patroni เป็นเฟรมเวิร์ก HA ที่ฝังอยู่ในพ็อด PostgreSQL ที่จัดการโดย PGO ทุกตัว โดยจะใช้ Kubernetes API เป็นที่จัดเก็บการกำหนดค่าแบบกระจาย (DCS) — ไม่จำเป็นต้องใช้ etcd หรือคลัสเตอร์ ZooKeeper แยกต่างหาก Patroni ตรวจสอบความสมบูรณ์ของ PostgreSQL หลักและแบบจำลองอย่างต่อเนื่อง เมื่อตัวจำลองหลักไม่ตอบสนอง Patroni จะเริ่มเฟลโอเวอร์โดยอัตโนมัติ โดยจะเลื่อนระดับตัวจำลองที่เป็นปัจจุบันที่สุดไปเป็นตัวจำลองหลัก และกำหนดค่าตัวจำลองที่เหลืออีกครั้งเพื่อติดตามผู้นำคนใหม่
กระบวนการเฟลโอเวอร์ใน PGO ทำงานดังนี้ Patroni บนแต่ละพ็อดมีการล็อคผู้นำใน Kubernetes (ผ่านจุดสิ้นสุดหรือออบเจ็กต์ ConfigMap) หลักปัจจุบันจะต้องต่ออายุการล็อคนี้ในช่วงเวลาที่กำหนดได้ (ค่าเริ่มต้น 10 วินาที TTL, รอ 3 วินาทีวนซ้ำ) หากตัวหลักล้มเหลวในการต่ออายุ — เนื่องจากมันขัดข้อง โหนดหยุดทำงาน หรือเครือข่ายถูกแบ่งพาร์ติชัน — แบบจำลองที่ใกล้กับตำแหน่ง WAL ของตัวหลักมากที่สุดจะได้รับการล็อคและเลื่อนระดับตัวเอง โดยทั่วไปกระบวนการทั้งหมดจะเสร็จสิ้นภายใน 10 ถึง 30 วินาที
โหมดการจำลองแบบซิงโครนัสซึ่งเปิดใช้งานผ่านsynchronous_mode: trueในการกำหนดค่า Patroni รับประกันการสูญเสียข้อมูลเป็นศูนย์ (RPO = 0) โดยมีต้นทุนของเวลาแฝงในการเขียนที่สูงขึ้นเล็กน้อย ในโหมดซิงโครนัส ธุรกรรมจะไม่ได้รับการยอมรับจากไคลเอนต์จนกว่าแบบจำลองอย่างน้อยหนึ่งรายการจะยืนยันการรับ WAL หากไม่มีการจำลองแบบซิงโครนัส Patroni จะปิดใช้งานโหมดซิงโครนัสชั่วคราวเพื่อรักษาความพร้อมใช้งาน คุณสามารถแทนที่สิ่งนี้ด้วยsynchronous_mode_strict: trueหากคุณต้องการเสียสละความพร้อมใช้งานเพื่อความสอดคล้อง
# Check Patroni cluster status
kubectl exec -it production-db-pgha1-0 -n databases -- patronictl list

+----------------------------+-------------------+---------+---------+----+-----------+
| Member                     | Host              | Role    | State   | TL | Lag in MB |
+----------------------------+-------------------+---------+---------+----+-----------+
| production-db-pgha1-0      | 10.244.0.15       | Leader  | running |  3 |           |
| production-db-pgha1-1      | 10.244.1.22       | Replica | running |  3 |         0 |
| production-db-pgha1-2      | 10.244.2.18       | Replica | running |  3 |         0 |
+----------------------------+-------------------+---------+---------+----+-----------+

# Manual switchover (planned, zero downtime)
kubectl exec -it production-db-pgha1-0 -n databases -- \
  patronictl switchover --master production-db-pgha1-0 --candidate production-db-pgha1-1 --force

# Manual failover (forced, for emergencies)
kubectl exec -it production-db-pgha1-1 -n databases -- \
  patronictl failover --candidate production-db-pgha1-1 --force
PGO กำหนดค่าบริการ Kubernetes โดยอัตโนมัติเพื่อติดตามผู้นำ Patroni บริการproduction-db-primaryจะชี้ไปที่พ็อดใดก็ตามที่มีการล็อคผู้นำอยู่ตลอดเวลา ดังนั้นแอปพลิเคชันที่เชื่อมต่อผ่านบริการนี้จะพบกับการเฟลโอเวอร์ที่ราบรื่นด้วยการรีเซ็ตการเชื่อมต่อเพียงช่วงสั้นๆ เท่านั้น
pgBackRest สำรองและกู้คืน
pgBackRest คือกลไกสำรองข้อมูลที่รวมอยู่ใน PGO รองรับการสำรองข้อมูลสามประเภท — เต็ม, ส่วนต่าง และส่วนเพิ่ม — บวกกับการเก็บถาวร WAL อย่างต่อเนื่องสำหรับการกู้คืนช่วงเวลา (PITR) การทำความเข้าใจว่าสิ่งเหล่านี้เข้ากันได้อย่างไรเป็นสิ่งสำคัญสำหรับการออกแบบกลยุทธ์การสำรองข้อมูลที่สร้างสมดุลระหว่างต้นทุนการจัดเก็บข้อมูล ความเร็วการสำรองข้อมูล และเวลาในการกู้คืน
การสำรองข้อมูลเต็มรูปแบบจะคัดลอกไดเร็กทอรีข้อมูล PostgreSQL ทั้งหมดและเป็นข้อมูลพื้นฐานสำหรับการสำรองข้อมูลประเภทอื่นๆ ทั้งหมด การสำรองข้อมูลส่วนต่างจะคัดลอกเฉพาะหน้าที่เปลี่ยนแปลงตั้งแต่การสำรองข้อมูลเต็มรูปแบบครั้งล่าสุด การสำรองข้อมูลส่วนเพิ่มจะคัดลอกเฉพาะหน้าที่เปลี่ยนแปลงตั้งแต่การสำรองข้อมูลครั้งล่าสุดทุกประเภท ในระหว่างการกู้คืน pgBackRest จะเชื่อมโยงการสำรองข้อมูลที่จำเป็นเข้าด้วยกันโดยอัตโนมัติ ตัวอย่างเช่น การกู้คืนจากส่วนเพิ่มต้องใช้ส่วนเพิ่มบวกส่วนต่างก่อนหน้า (หรือทั้งหมด) บวกกับการสำรองข้อมูลทั้งหมด รวมถึงส่วน WAL ใด ๆ ที่จำเป็นในการไปถึงจุดการกู้คืนเป้าหมาย
การกำหนดค่ากำหนดการสำรองกำหนดการสำรองข้อมูลถูกกำหนดไว้ในส่วนreposของการกำหนดค่า pgBackRest ภายในข้อกำหนดPostgresClusterโดยปกติแล้ว ตารางการผลิตที่มั่นคงจะดำเนินการสำรองข้อมูลส่วนเพิ่มรายสัปดาห์แบบเต็มรายสัปดาห์ และสำรองข้อมูลส่วนเพิ่มบ่อยขึ้น
backups:
  pgbackrest:
    global:
      repo1-retention-full: "4"        # Keep 4 full backups
      repo1-retention-full-type: count
      repo1-retention-diff: "14"       # Keep 14 differentials
    repos:
      - name: repo1
        schedules:
          full: "0 2 * * 0"            # Weekly full: Sunday 2am
          differential: "0 2 * * 1-6"  # Daily diff: Mon-Sat 2am
          incremental: "0 */6 * * *"   # Every 6 hours
        s3:
          bucket: mycompany-pg-backups
          endpoint: s3.eu-west-1.amazonaws.com
          region: eu-west-1
สำรองและกู้คืน
ด้วยตนเอง# Trigger a manual full backup
kubectl annotate postgrescluster production-db -n databases \
postgres-operator.crunchydata.com/pgbackrest-backup="$(date +%s)" \
--overwrite
# Check backup status
kubectl exec -it production-db-pgha1-0 -n databases -- \
pgbackrest info --stanza=db
# Restore to a specific point in time
# First, update the PostgresCluster spec:
spec:
backups:
pgbackrest:
restore:
enabled: true
repoName: repo1
options:
- --type=time
- --target="2026-04-12 08:30:00+00"
- --target-action=promote
# Apply the restore annotation
kubectl annotate postgrescluster production-db -n databases \
postgres-operator.crunchydata.com/pgbackrest-restore="$(date +%s)" \
--overwriteในระหว่างการกู้คืน PITR PGO จะปิดอินสแตนซ์ PostgreSQL ทั้งหมด กู้คืนจากการสำรองข้อมูลเต็มรูปแบบหรือส่วนต่างที่ใกล้ที่สุด เล่นซ้ำส่วน WAL จนถึงเวลาเป้าหมาย จากนั้นเริ่มคลัสเตอร์ การดำเนินการทั้งหมดได้รับการควบคุมโดยผู้ปฏิบัติงาน โดยไม่จำเป็นต้องใช้คนควบคุมพ็อดแต่ละตัว
การรวมการเชื่อมต่อ PgBouncer
PostgreSQL สร้างกระบวนการใหม่สำหรับการเชื่อมต่อไคลเอ็นต์ทุกครั้ง ในขนาด — พ็อดแอปพลิเคชันนับร้อยหรือหลายพันตัวที่แต่ละพ็อดรักษาพูลการเชื่อมต่อ — โมเดลนี้พังทลายลง PgBouncer อยู่ระหว่างแอปพลิเคชันของคุณกับ PostgreSQL ซึ่งเป็นการมัลติเพล็กซ์การเชื่อมต่อไคลเอนต์จำนวนมากผ่านการเชื่อมต่อเซิร์ฟเวอร์จำนวนน้อยกว่า
PGO ปรับใช้ PgBouncer เป็นการปรับใช้แยกต่างหากด้วยบริการของตัวเอง บริการproduction-db-pgbouncerคือสิ่งที่แอปพลิเคชันของคุณควรเชื่อมต่อ ไม่ใช่บริการหลัก PostgreSQL โดยตรง PgBouncer รองรับโหมดพูลสามโหมด:
- การรวมเซสชัน— การเชื่อมต่อเซิร์ฟเวอร์ถูกกำหนดให้กับไคลเอนต์ตลอดอายุการใช้งานของการเชื่อมต่อไคลเอนต์ ปลอดภัยที่สุด แต่มีประสิทธิภาพน้อยที่สุด
- การรวมธุรกรรม— การเชื่อมต่อเซิร์ฟเวอร์ถูกกำหนดไว้ในช่วงระยะเวลาของธุรกรรมเท่านั้น มีประสิทธิภาพสูงสุดสำหรับปริมาณงานบนเว็บ นี่เป็นค่าเริ่มต้นที่แนะนำ
- การรวมคำสั่ง— การเชื่อมต่อเซิร์ฟเวอร์ถูกกำหนดไว้สำหรับคำสั่งเดียว ใช้งานได้เฉพาะกับปริมาณงานธรรมดาที่ไม่ใช่ธุรกรรมเท่านั้น
proxy:
  pgBouncer:
    replicas: 3
    config:
      global:
        pool_mode: transaction
        max_client_conn: "2000"
        default_pool_size: "30"
        min_pool_size: "10"
        reserve_pool_size: "10"
        reserve_pool_timeout: "3"
        server_idle_timeout: "300"
        server_lifetime: "3600"
        client_idle_timeout: "600"
        tcp_keepalive: "1"
        tcp_keepidle: "30"
        tcp_keepintvl: "10"
        tcp_keepcnt: "3"
    affinity:
      podAntiAffinity:
        preferredDuringSchedulingIgnoredDuringExecution:
          - weight: 100
            podAffinityTerm:
              topologyKey: kubernetes.io/hostname
              labelSelector:
                matchLabels:
postgres-operator.crunchydata.com/role: pgbouncerโปรดทราบการตั้งค่าtcp_keepalive— สิ่งเหล่านี้มีความสำคัญเมื่อ PgBouncer ทำงานอยู่เบื้องหลังโหลดบาลานเซอร์บนคลาวด์หรือบริการ Kubernetes หากไม่มี Keepalive ที่ก้าวร้าว การเชื่อมต่อที่ไม่ได้ใช้งานอาจถูกละทิ้งโดยส่วนประกอบเครือข่ายระดับกลาง ทำให้เกิดข้อผิดพลาดของแอปพลิเคชันในการพยายามสืบค้นครั้งถัดไป
pgMonitor และ Prometheus/Grafana การตรวจสอบ
การผสานรวมการตรวจสอบของPGO ใช้งานรถเทียมข้างรถจักรยานยนต์crunchy-postgres-exporterในพ็อด PostgreSQL ทุกตัว ผู้ส่งออกรายนี้ขูดมุมมองสถิติภายในของ PostgreSQL และเปิดเผยเป็นตัวชี้วัด Prometheus บนพอร์ต 9187 ผู้ส่งออกครอบคลุมตัวชี้วัดมากกว่า 150 รายการตั้งแต่แกะกล่อง รวมถึงการเชื่อมต่อ ความล่าช้าในการจำลอง อัตราการทำธุรกรรม อัตราส่วนการเข้าถึงแคช สถิติของตารางและดัชนี การช่วงชิงการล็อค และอัตราการสร้าง WAL
# ServiceMonitor for Prometheus Operator auto-discovery
apiVersion: monitoring.coreos.com/v1
kind: ServiceMonitor
metadata:
  name: postgres-monitoring
  namespace: databases
  labels:
    release: kube-prometheus-stack
spec:
  selector:
    matchLabels:
      postgres-operator.crunchydata.com/cluster: production-db
      postgres-operator.crunchydata.com/crunchy-postgres-exporter: "true"
  endpoints:
    - port: exporter
      interval: 15s
      scrapeTimeout: 10s
Crunchy Data มอบชุดแดชบอร์ด Grafana ที่สร้างไว้ล่วงหน้าซึ่งคุณสามารถนำเข้าได้โดยตรง สิ่งเหล่านี้ครอบคลุมภาพรวม PostgreSQL สถานะการจำลอง สถานะการสำรองข้อมูล pgBackRest สถิติ PgBouncer และการใช้ทรัพยากรระดับพ็อด นำเข้าผ่านการจัดเตรียมแดชบอร์ดของ Grafana หรือด้วยตนเองจากที่เก็บข้อมูลตัวอย่าง Crunchy Data
# Install Grafana dashboards as ConfigMaps
kubectl create configmap grafana-pg-overview \
  --from-file=pg-overview.json=dashboards/pg-overview.json \
  -n monitoring
kubectl label configmap grafana-pg-overview grafana_dashboard=1 -n monitoring
กฎการแจ้งเตือนที่สำคัญสำหรับ PostgreSQL
apiVersion: monitoring.coreos.com/v1
kind: PrometheusRule
metadata:
  name: postgres-alerts
  namespace: databases
  labels:
    release: kube-prometheus-stack
spec:
  groups:
    - name: postgresql-health
      rules:
        - alert: PostgresReplicationLagHigh
          expr: ccp_replication_lag_size_bytes > 104857600
          for: 5m
          labels:
            severity: warning
          annotations:
            summary: "Replica {{ $labels.pod }} lag exceeds 100MB"

        - alert: PostgresConnectionsExhausted
          expr: ccp_connection_stats_active / ccp_connection_stats_max_connections > 0.85
          for: 2m
          labels:
            severity: critical
          annotations:
            summary: "PostgreSQL connections above 85% capacity"

        - alert: PostgresDeadlockDetected
          expr: rate(ccp_stat_database_deadlocks[5m]) > 0
          for: 1m
          labels:
            severity: warning
          annotations:
            summary: "Deadlocks detected in {{ $labels.datname }}"

        - alert: PostgresCacheHitRatioLow
          expr: ccp_stat_database_blks_hit / (ccp_stat_database_blks_hit + ccp_stat_database_blks_read) < 0.95
          for: 10m
          labels:
            severity: warning
          annotations:
            summary: "Cache hit ratio below 95% for {{ $labels.datname }}"

        - alert: PgBackRestStaleBackup
          expr: time() - ccp_backrest_last_full_backup_time_since_completion_seconds > 604800
          for: 1h
          labels:
            severity: critical
          annotations:
            summary: "No full backup in the last 7 days"
AWS EKS การใช้งาน
การปรับใช้ PGO บน AWS EKS จำเป็นต้องกำหนดค่าไดรเวอร์ EBS CSI สำหรับวอลุ่มถาวรและบทบาท IAM สำหรับบัญชีบริการ (IRSA) สำหรับการเข้าถึงข้อมูลสำรอง S3 วิธีนี้จะช่วยหลีกเลี่ยงการจัดเก็บข้อมูลประจำตัว AWS ที่มีอายุยาวนานในความลับ Kubernetes
# Install the EBS CSI driver (required for gp3 volumes)
eksctl create addon --name aws-ebs-csi-driver --cluster my-cluster --region eu-west-1 \
  --service-account-role-arn arn:aws:iam::111122223333:role/AmazonEKS_EBS_CSI_DriverRole

# Create a gp3 StorageClass
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: gp3-csi
provisioner: ebs.csi.aws.com
parameters:
  type: gp3
  iops: "3000"
  throughput: "125"
  encrypted: "true"
volumeBindingMode: WaitForFirstConsumer
allowVolumeExpansion: true
# IAM policy for pgBackRest S3 access
{
"Version": "2012-10-17",
"Statement": [
{
"Effect": "Allow",
"Action": [
"s3:PutObject",
"s3:GetObject",
"s3:DeleteObject",
"s3:ListBucket"
],
"Resource": [
"arn:aws:s3:::mycompany-pg-backups",
"arn:aws:s3:::mycompany-pg-backups/*"
]
}
]
}
# Create an IRSA-enabled service account
eksctl create iamserviceaccount \
--name pgbackrest-sa \
--namespace databases \
--cluster my-cluster \
--attach-policy-arn arn:aws:iam::111122223333:policy/PGBackRestS3Policy \
--approveในข้อมูลจำเพาะPostgresClusterให้อ้างอิงบัคเก็ต S3 และภูมิภาค PGO จะใช้ข้อมูลรับรองบัญชีบริการของพ็อด (ผ่าน IRSA) โดยอัตโนมัติ โดยไม่ต้องใช้คีย์การเข้าถึงที่ชัดเจน
backups:
  pgbackrest:
    repos:
      - name: repo1
        s3:
          bucket: mycompany-pg-backups
          endpoint: s3.eu-west-1.amazonaws.com
          region: eu-west-1
สำหรับความยืดหยุ่นหลาย AZ ตรวจสอบให้แน่ใจว่ากลุ่มโหนด EKS ของคุณขยายโซนความพร้อมใช้งานอย่างน้อยสามโซน และใช้ข้อจำกัดการแพร่กระจายโทโพโลยีที่แสดงก่อนหน้านี้เพื่อกระจายพ็อด PostgreSQL ข้ามโซนเหล่านั้น
Azure AKS การปรับใช้
Azure AKS ใช้ดิสก์ที่ได้รับการจัดการสำหรับพื้นที่จัดเก็บข้อมูลถาวร และ Azure Blob Storage สำหรับการสำรองข้อมูล pgBackRest คลาสพื้นที่จัดเก็บข้อมูลที่แนะนำใช้ Premium SSD v2 หรือ Premium LRS สำหรับเวิร์กโหลดฐานข้อมูล
# StorageClass for Azure Premium SSD
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: azure-premium-ssd
provisioner: disk.csi.azure.com
parameters:
  skuName: Premium_LRS
  kind: Managed
volumeBindingMode: WaitForFirstConsumer
allowVolumeExpansion: true

---
# pgBackRest with Azure Blob Storage
backups:
  pgbackrest:
    configuration:
      - secret:
          name: pgbackrest-azure-creds
    global:
      repo1-azure-account: mystorageaccount
      repo1-retention-full: "7"
    repos:
      - name: repo1
        schedules:
          full: "0 2 * * 0"
          differential: "0 2 * * 1-6"
        azure:
          container: pg-backups

---
# Secret with Azure credentials
apiVersion: v1
kind: Secret
metadata:
  name: pgbackrest-azure-creds
  namespace: databases
stringData:
  azure.conf: |
    [global]
    repo1-azure-key=BASE64_STORAGE_ACCOUNT_KEY
สำหรับ Workload Identity (เทียบเท่า Azure ของ AWS IRSA) ให้กำหนดค่าคลัสเตอร์ AKS กับผู้ออก OIDC และสร้างข้อมูลรับรองตัวตนแบบรวมศูนย์สำหรับบัญชีบริการ pgBackRest วิธีนี้ช่วยลดความจำเป็นในการเก็บคีย์บัญชีที่เป็นความลับ
GCP GKE การปรับใช้
GKE ใช้ Persistent Disk (pd-ssd) สำหรับการจัดเก็บข้อมูลและ GCS สำหรับการสำรองข้อมูล pgBackRest GKE Workload Identity จะจับคู่บัญชีบริการ Kubernetes กับบัญชีบริการ Google Cloud เพื่อการตรวจสอบสิทธิ์แบบไม่ใช้คีย์ที่ปลอดภัย
# StorageClass for GKE SSD Persistent Disk
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: pd-ssd
provisioner: pd.csi.storage.gke.io
parameters:
  type: pd-ssd
volumeBindingMode: WaitForFirstConsumer
allowVolumeExpansion: true

---
# pgBackRest with GCS
backups:
  pgbackrest:
    configuration:
      - secret:
          name: pgbackrest-gcs-creds
    repos:
      - name: repo1
        gcs:
          bucket: mycompany-pg-backups

---
# GCS service account key secret
apiVersion: v1
kind: Secret
metadata:
  name: pgbackrest-gcs-creds
  namespace: databases
stringData:
  gcs-key.json: |
    {
      "type": "service_account",
      "project_id": "my-project",
      ...
    }
# Enable Workload Identity on GKE
gcloud container clusters update my-cluster \
--workload-pool=my-project.svc.id.goog
# Create and bind IAM service account
gcloud iam service-accounts create pgbackrest-gcs \
--display-name="pgBackRest GCS Access"
gcloud projects add-iam-policy-binding my-project \
--member="serviceAccount:pgbackrest-gcs@my-project.iam.gserviceaccount.com" \
--role="roles/storage.objectAdmin"
gcloud iam service-accounts add-iam-policy-binding \
pgbackrest-gcs@my-project.iam.gserviceaccount.com \
--role="roles/iam.workloadIdentityUser" \
--member="serviceAccount:my-project.svc.id.goog[databases/production-db-pgbackrest]"การกู้คืนความเสียหายหลายภูมิภาค
PGO รองรับคลัสเตอร์สแตนด์บายสำหรับการกู้คืนความเสียหายข้ามภูมิภาค คลัสเตอร์สแตนด์บายเล่นซ้ำ WAL จากที่เก็บ pgBackRest ของคลัสเตอร์หลักอย่างต่อเนื่อง โดยคงสำเนาวอร์มไว้ซึ่งสามารถเลื่อนระดับเป็นคลัสเตอร์หลักอิสระในกรณีที่เกิดความล้มเหลวในระดับภูมิภาค
# Standby cluster in Region B
apiVersion: postgres-operator.crunchydata.com/v1beta1
kind: PostgresCluster
metadata:
  name: production-db-standby
  namespace: databases
spec:
  postgresVersion: 16
  image: registry.crunchydata.com/crunchydata/crunchy-postgres:ubi8-16.6-1

  standby:
    enabled: true
    repoName: repo1

  instances:
    - name: pgha1
      replicas: 2
      dataVolumeClaimSpec:
        storageClassName: gp3-csi
        accessModes: ["ReadWriteOnce"]
        resources:
          requests:
            storage: 100Gi

  backups:
    pgbackrest:
      image: registry.crunchydata.com/crunchydata/crunchy-pgbackrest:ubi8-2.54.1-0
      configuration:
        - secret:
            name: pgbackrest-s3-creds
      repos:
        - name: repo1
          s3:
            bucket: mycompany-pg-backups
            endpoint: s3.us-east-1.amazonaws.com
            region: us-east-1
หากต้องการเลื่อนระดับคลัสเตอร์สแตนด์บายระหว่างเกิดภัยพิบัติ ให้ตั้งค่าstandby.enabled: falseในข้อมูลจำเพาะและใช้การเปลี่ยนแปลง PGO ส่งเสริมการสแตนด์บายให้กับคลัสเตอร์หลักที่เป็นอิสระ โปรโมชันนี้ไม่สามารถย้อนกลับได้ คุณจะต้องสร้างความสัมพันธ์ในการจำลองใหม่ตั้งแต่ต้นหลังจากที่ภูมิภาคหลักเดิมฟื้นตัวแล้ว
การปรับใช้โลหะเปลือย k3s/Rancher
การรัน PGO บน Bare Metal k3s พร้อมการจัดการ Rancher จำเป็นต้องได้รับความเอาใจใส่อย่างระมัดระวังในด้านพื้นที่จัดเก็บและเครือข่าย เนื่องจากคุณไม่มีดิสก์หรือโหลดบาลานเซอร์ที่ผู้ให้บริการระบบคลาวด์จัดการ
ที่เก็บของทรงยาว
Longhorn เป็นระบบจัดเก็บข้อมูลบล็อกแบบกระจายน้ำหนักเบาสำหรับ Kubernetes ซึ่งเหมาะสำหรับสภาพแวดล้อมที่เป็นโลหะเปลือย โดยจำลองวอลุ่มข้ามหลายโหนดเพื่อความคงทนและรองรับสแน็ปช็อต การสำรองข้อมูล และการขยายวอลุ่ม
# Install Longhorn via Helm
helm repo add longhorn https://charts.longhorn.io
helm repo update

helm install longhorn longhorn/longhorn \
  --namespace longhorn-system \
  --create-namespace \
  --set defaultSettings.defaultReplicaCount=3 \
  --set defaultSettings.storageOverProvisioningPercentage=100 \
  --set defaultSettings.storageMinimalAvailablePercentage=15

---
# Longhorn StorageClass for PostgreSQL
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: longhorn-pg
provisioner: driver.longhorn.io
parameters:
  numberOfReplicas: "3"
  staleReplicaTimeout: "2880"
  fsType: ext4
  dataLocality: best-effort
volumeBindingMode: WaitForFirstConsumer
allowVolumeExpansion: true
reclaimPolicy: Retain
MetalLB สำหรับโหลดบาลานซ์
# Install MetalLB
helm repo add metallb https://metallb.github.io/metallb
helm install metallb metallb/metallb --namespace metallb-system --create-namespace

---
# Configure IP address pool
apiVersion: metallb.io/v1beta1
kind: IPAddressPool
metadata:
  name: pg-pool
  namespace: metallb-system
spec:
  addresses:
    - 192.168.1.200-192.168.1.210
---
apiVersion: metallb.io/v1beta1
kind: L2Advertisement
metadata:
  name: pg-l2
  namespace: metallb-system
spec:
  ipAddressPools:
    - pg-pool
ด้วยการกำหนดค่า MetalLB บริการของ PGO ประเภทLoadBalancerจะได้รับที่อยู่ IP จากพูลของคุณ ทำให้จุดสิ้นสุด PostgreSQL หลักและ PgBouncer สามารถเข้าถึงได้โดยตรงจากเครือข่ายของคุณ โดยไม่ต้องส่งต่อพอร์ตด้วยตนเอง
pgBackRest พร้อม Local PVC หรือ NFS สำหรับ Bare Metal
# For environments without S3/GCS/Azure Blob, use a PVC-based repo
backups:
  pgbackrest:
    repos:
      - name: repo1
        schedules:
          full: "0 2 * * 0"
          differential: "0 2 * * 1-6"
        volume:
          volumeClaimSpec:
            storageClassName: longhorn-pg
            accessModes: ["ReadWriteOnce"]
            resources:
              requests:
                storage: 200Gi
สำหรับสภาพแวดล้อมแบบช่องว่างอากาศ คุณยังสามารถกำหนดค่าพื้นที่เก็บข้อมูล pgBackRest สำรองที่จัดส่งการสำรองข้อมูลไปยังการแบ่งปัน NFS หรืออินสแตนซ์ MiniIO ที่ทำงานภายในองค์กร โดยจัดเตรียมสำเนาสำรองนอกคลัสเตอร์โดยไม่ต้องพึ่งพาระบบคลาวด์
การกำหนดค่าการเข้ารหัสTLS/SSL
PGO สร้างใบรับรอง TLS ที่ลงนามด้วยตนเองสำหรับการสื่อสารภายในทั้งหมดตามค่าเริ่มต้น — อินสแตนซ์ PostgreSQL, การจำลอง, pgBackRest และ PgBouncer ล้วนสื่อสารผ่านช่องทางที่เข้ารหัสโดยไม่มีการจัดการใบรับรองด้วยตนเอง อย่างไรก็ตาม สำหรับสภาพแวดล้อมการใช้งานจริง คุณมักจะต้องการใช้ใบรับรองที่ลงนามโดย CA ขององค์กรของคุณ
# Create a TLS secret with your CA-signed certificates
kubectl create secret tls production-db-tls \
  --cert=server.crt \
  --key=server.key \
  -n databases

kubectl create secret generic production-db-ca \
  --from-file=ca.crt=ca.crt \
  -n databases

---
# Reference in PostgresCluster spec
spec:
  customTLSSecret:
    name: production-db-tls
  customReplicationTLSSecret:
    name: production-db-replication-tls
PGO กำหนดค่า PostgreSQL ด้วยssl = onและตั้งค่าพารามิเตอร์ssl_cert_file,ssl_key_fileและssl_ca_fileที่เหมาะสม PgBouncer ได้รับการกำหนดค่าในทำนองเดียวกันให้ต้องใช้ TLS สำหรับการเชื่อมต่อไคลเอนต์ และใช้ TLS เมื่อเชื่อมต่อกับแบ็กเอนด์ PostgreSQL
# Enforce TLS for all client connections via pg_hba.conf
spec:
  patroni:
    dynamicConfiguration:
      postgresql:
        pg_hba:
          - hostssl all all 0.0.0.0/0 scram-sha-256
          - hostssl replication all 0.0.0.0/0 scram-sha-256
การกำหนดค่า PostgreSQL แบบกำหนดเอง
PGO แสดงการกำหนดค่า PostgreSQL ผ่านส่วนการกำหนดค่าไดนามิก Patroni นี่เป็นแนวทางที่แนะนำเนื่องจาก Patroni รับประกันว่าอินสแตนซ์ทั้งหมดจะรักษาการกำหนดค่าที่สอดคล้องกันและจัดการการรีสตาร์ทเมื่อจำเป็น
patroni:
  dynamicConfiguration:
    postgresql:
      parameters:
        # Memory
        shared_buffers: 4GB
        effective_cache_size: 12GB
        work_mem: 64MB
        maintenance_work_mem: 1GB
        huge_pages: "try"

        # WAL
        wal_buffers: 128MB
        min_wal_size: 2GB
        max_wal_size: 8GB
        checkpoint_completion_target: 0.9
        wal_compression: lz4

        # Query Planning
        random_page_cost: 1.1
        effective_io_concurrency: 200
        default_statistics_target: 200

        # Parallelism
        max_worker_processes: 16
        max_parallel_workers_per_gather: 4
        max_parallel_workers: 8
        max_parallel_maintenance_workers: 4

        # Connections
        max_connections: 200
        idle_in_transaction_session_timeout: 60000
        statement_timeout: 300000

        # Logging
        log_min_duration_statement: 250
        log_checkpoints: "on"
        log_connections: "on"
        log_disconnections: "on"
        log_lock_waits: "on"
        log_temp_files: 0
        log_autovacuum_min_duration: 0

        # Autovacuum Tuning
        autovacuum_max_workers: 5
        autovacuum_naptime: 30
        autovacuum_vacuum_cost_limit: 800
        autovacuum_vacuum_scale_factor: 0.02
        autovacuum_analyze_scale_factor: 0.01
พารามิเตอร์เหล่านี้ถือว่าโหนดที่มีแกน CPU 16 แกน และ RAM ขนาด 32 GB สำหรับ PostgreSQL โดยเฉพาะ ปรับshared_buffersเป็นประมาณ 25% ของ RAM ที่มีอยู่ และeffective_cache_sizeเป็นประมาณ 75% การตั้งค่า WAL และจุดตรวจสอบได้รับการปรับแต่งสำหรับปริมาณงานที่มีการเขียนข้อมูลจำนวนมาก — ลดmax_wal_sizeสำหรับระบบที่อ่านข้อมูลจำนวนมาก ซึ่งความถี่ของจุดตรวจสอบมีความสำคัญน้อยกว่า
การจัดการผู้ใช้และฐานข้อมูล
PGO จัดการผู้ใช้ PostgreSQL และฐานข้อมูลอย่างชัดเจนผ่านส่วนusersของข้อมูลจำเพาะPostgresClusterเมื่อคุณเพิ่มผู้ใช้ PGO จะสร้างบทบาทใน PostgreSQL สร้างรหัสผ่านแบบสุ่ม และจัดเก็บข้อมูลประจำตัวไว้ใน Kubernetes Secret
users:
  - name: appuser
    databases: ["appdb"]
    options: "NOSUPERUSER NOCREATEDB NOCREATEROLE"
  - name: readonly
    databases: ["appdb"]
    options: "NOSUPERUSER NOCREATEDB NOCREATEROLE"
  - name: migrations
    databases: ["appdb"]
    options: "NOSUPERUSER CREATEDB"
  - name: monitoring
    databases: ["postgres"]
    options: "NOSUPERUSER LOGIN"

---
# Access credentials from the generated secret
kubectl get secret production-db-pguser-appuser -n databases -o jsonpath='{.data.password}' | base64 -d

# The secret also contains a full connection URI
kubectl get secret production-db-pguser-appuser -n databases -o jsonpath='{.data.uri}' | base64 -d
# postgresql://appuser:PASSWORD@production-db-primary.databases.svc:5432/appdb
สำหรับการให้สิทธิ์การเข้าถึงแบบอ่านอย่างเดียว ให้ใช้คุณสมบัติdatabaseInitSQLเพื่อรัน SQL ในการสร้างคลัสเตอร์ที่สร้างบทบาทแบบอ่านอย่างเดียวและให้สิทธิ์ SELECT บนตารางทั้งหมด
# init.sql ConfigMap
apiVersion: v1
kind: ConfigMap
metadata:
  name: init-sql-configmap
  namespace: databases
data:
  init.sql: |
    -- Read-only role for reporting users
    ALTER DEFAULT PRIVILEGES IN SCHEMA public GRANT SELECT ON TABLES TO readonly;
    GRANT CONNECT ON DATABASE appdb TO readonly;
    GRANT USAGE ON SCHEMA public TO readonly;
    GRANT SELECT ON ALL TABLES IN SCHEMA public TO readonly;

    -- Extensions
    CREATE EXTENSION IF NOT EXISTS pg_stat_statements;
    CREATE EXTENSION IF NOT EXISTS pgcrypto;
    CREATE EXTENSION IF NOT EXISTS pg_trgm;
การอัปเดตแบบ Rolling และการอัปเกรดเวอร์ชันหลัก
PGO จัดการการอัพเกรดเวอร์ชันรองผ่านการอัปเดตแบบต่อเนื่อง เมื่อคุณเปลี่ยนแท็กรูปภาพในข้อมูลจำเพาะPostgresClusterไปเป็นแพตช์ที่ใหม่กว่า PGO จะอัปเดตอินสแตนซ์ทีละรายการ โดยเริ่มจากแบบจำลองและจบด้วยอินสแตนซ์หลัก (ซึ่งจะทริกเกอร์การเปลี่ยน Patroni เพื่อลดเวลาหยุดทำงานให้เหลือน้อยที่สุด)
# Minor version upgrade: change the image tag
spec:
image: registry.crunchydata.com/crunchydata/crunchy-postgres:ubi8-16.7-0เวอร์ชันหลัก (เช่น PostgreSQL 15 ถึง 16) ต้องใช้pg_upgradeซึ่ง PGO จัดเตรียมผ่านPGUpgradeCRD ที่แยกต่างหาก
apiVersion: postgres-operator.crunchydata.com/v1beta1
kind: PGUpgrade
metadata:
  name: production-db-upgrade
  namespace: databases
spec:
  postgresClusterName: production-db
  fromPostgresVersion: 15
  toPostgresVersion: 16
  image: registry.crunchydata.com/crunchydata/crunchy-upgrade:ubi8-5.7.2-0
กระบวนการอัปเกรดจะปิดคลัสเตอร์ที่มีอยู่ รันpg_upgrade --linkเพื่อดำเนินการอัปเกรดแบบแทนที่โดยใช้ฮาร์ดลิงก์ (ลดการคัดลอกข้อมูล) ตรวจสอบการอัพเกรด และเริ่มคลัสเตอร์ในเวอร์ชันใหม่ ทำการสำรองข้อมูลทั้งหมดก่อนที่จะเริ่มการอัพเกรดเวอร์ชันหลักและทดสอบขั้นตอนบนคลัสเตอร์ที่ไม่ใช่การใช้งานจริงก่อน
# Pre-upgrade checklist
# 1. Take a full backup
kubectl annotate postgrescluster production-db -n databases \
  postgres-operator.crunchydata.com/pgbackrest-backup="$(date +%s)" \
  --overwrite

# 2. Verify backup completed
kubectl exec -it production-db-pgha1-0 -n databases -- pgbackrest info --stanza=db

# 3. Shutdown the cluster (set replicas to 0 or use PGO shutdown annotation)
kubectl annotate postgrescluster production-db -n databases \
  postgres-operator.crunchydata.com/shutdown="$(date +%s)" \
  --overwrite

# 4. Apply the PGUpgrade resource
kubectl apply -f pg-upgrade.yaml

# 5. Update the PostgresCluster spec with the new version and image
# 6. Remove the shutdown annotation to start the upgraded clusterการรัน PGO ในการผลิตต้องให้ความสนใจกับพื้นที่ปฏิบัติงานหลายประการ นอกเหนือจากการใช้งานครั้งแรก
ประสิทธิภาพการจัดเก็บข้อมูล- แยกข้อมูลและวอลุ่ม WAL: ใช้
walVolumeClaimSpecเสมอเพื่อวาง WAL บน PVC เฉพาะ วิธีนี้จะป้องกันไม่ให้กิจกรรม WAL ที่มีการเขียนจำนวนมากแข่งขันกับข้อมูล I/O - ใช้พื้นที่จัดเก็บข้อมูล IOPS สูง: gp3 (AWS), Premium SSD v2 (Azure), pd-ssd (GCP) หรือ Longhorn ที่รองรับ NVMe บนโลหะเปลือย รูปแบบ I/O แบบสุ่มของ PostgreSQL ต้องการพื้นที่จัดเก็บข้อมูลที่มีความหน่วงต่ำ
- การขยายระดับเสียง: ตรวจสอบให้แน่ใจว่า StorageClass ของคุณมี
allowVolumeExpansion: truePGO สามารถขยาย PVC ได้โดยไม่รบกวนผู้ให้บริการพื้นที่จัดเก็บข้อมูลที่รองรับ
งบประมาณการหยุดชะงักของพ็อด
PGO จะสร้าง PDB สำหรับอินสแตนซ์ PostgreSQL ของคุณโดยอัตโนมัติ แต่ตรวจสอบว่าเหมาะสมกับข้อกำหนด HA ของคุณ
# Check PDBs
kubectl get pdb -n databases
NAME                    MIN AVAILABLE   MAX UNAVAILABLE   ALLOWED DISRUPTIONS   AGE
production-db-pgha1 1 N/A 2 7d- ตั้งค่าคำขอหน่วยความจำเท่ากับขีดจำกัดสำหรับพ็อดฐานข้อมูลเพื่อป้องกัน OOM kill และรับรองคลาส QoS ที่รับประกัน
- ตั้งค่าคำขอ CPU อย่างระมัดระวังและจำกัดให้สูงกว่าเพื่อให้สามารถระเบิดได้ระหว่างการดำเนินการสุญญากาศหรือการบำรุงรักษา
- ตรวจสอบการใช้งานจริงผ่านตัวชี้วัด pgMonitor และปรับรายไตรมาส
การจัดการการเชื่อมต่อ
- เชื่อมต่อผ่าน PgBouncer เสมอ ไม่ใช่เชื่อมต่อกับ PostgreSQL โดยตรง
- ตั้งค่า
max_connectionsใน PostgreSQL เป็นค่าที่คำนึงถึงขนาดพูลของ PgBouncer รวมถึงการเชื่อมต่อระบบ (การจำลองแบบ การตรวจสอบ superuser) - ใช้โหมดการรวมธุรกรรมสำหรับเว็บแอปพลิเคชัน สลับไปใช้การรวมเซสชันเฉพาะในกรณีที่แอปพลิเคชันของคุณใช้คำสั่งที่เตรียมไว้หรือสถานะระดับเซสชัน (เช่น คำสั่ง
SETตารางชั่วคราว)
- ทดสอบการกู้คืนเป็นประจำโดยการสร้างคลัสเตอร์โคลนจากการสำรองข้อมูลและเรียกใช้การทดสอบควันระดับแอปพลิเคชัน
- ตรวจสอบการแจ้งเตือน
PgBackRestStaleBackupเพื่อให้แน่ใจว่าการสำรองข้อมูลเสร็จสิ้นตามกำหนดเวลา - ตรวจสอบ PITR โดยการเรียกคืนการประทับเวลาที่เฉพาะเจาะจง และตรวจสอบความสอดคล้องของข้อมูล
# Clone cluster for backup validation
apiVersion: postgres-operator.crunchydata.com/v1beta1
kind: PostgresCluster
metadata:
  name: backup-validation
  namespace: databases
spec:
  postgresVersion: 16
  image: registry.crunchydata.com/crunchydata/crunchy-postgres:ubi8-16.6-1
  dataSource:
    postgresCluster:
      clusterName: production-db
      repoName: repo1
      options:
        - --type=time
        - --target="2026-04-12 06:00:00+00"
  instances:
    - name: pgha1
      replicas: 1
      dataVolumeClaimSpec:
        storageClassName: gp3-csi
        accessModes: ["ReadWriteOnce"]
        resources:
          requests:
            storage: 100Gi
  backups:
    pgbackrest:
      repos:
        - name: repo1
          volume:
            volumeClaimSpec:
              accessModes: ["ReadWriteOnce"]
              resources:
                requests:
storage: 50Gi# Restrict PostgreSQL traffic to known namespaces
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
name: postgres-network-policy
namespace: databases
spec:
podSelector:
matchLabels:
postgres-operator.crunchydata.com/cluster: production-db
policyTypes:
- Ingress
ingress:
- from:
- namespaceSelector:
matchLabels:
app-access: database
- podSelector:
matchLabels:
postgres-operator.crunchydata.com/cluster: production-db
ports:
- port: 5432
protocol: TCP
- port: 9187
protocol: TCP- Replication lag: แจ้งเตือนเมื่อเรพลิกาใด ๆ เกิน 100MB หรือ 60 วินาทีของความล่าช้า
- ความอิ่มตัวของการเชื่อมต่อ: แจ้งเตือนเมื่อมีการเชื่อมต่อที่ใช้งานเกิน 80% ของ
max_connections - อัตราการทำธุรกรรมผิดปกติ: กำหนดพื้นฐาน TPS ของคุณและแจ้งเตือนการเบี่ยงเบนที่สำคัญ
- การใช้ดิสก์: แจ้งเตือนที่เกณฑ์ 70% และ 85% ด้วย runbooks การขยายวอลุ่ม
- ความใหม่ของการสำรองข้อมูล: แจ้งเตือนเมื่อการสำรองข้อมูลเต็มรูปแบบครั้งล่าสุดเก่ากว่าหน้าต่าง RPO ของคุณ
- การช่วงชิงการล็อค: แจ้งเตือนการล็อคที่ถือไว้เป็นเวลานาน (> 30 วินาที) ที่อาจบ่งบอกถึงข้อบกพร่องของแอปพลิเคชัน
- สุขภาพเครื่องดูดฝุ่นอัตโนมัติ: แจ้งเตือนเมื่อโต๊ะไม่ได้รับการดูดฝุ่นเกิน 24 ชั่วโมง
คู่มือการกู้คืนความเสียหาย
แผนการกู้คืนระบบจะมีประโยชน์ก็ต่อเมื่อได้รับการทดสอบแล้วเท่านั้น Runbook ต่อไปนี้สรุปขั้นตอนสำคัญสำหรับการกู้คืนจากสถานการณ์ความล้มเหลวทั่วไป
พ็อดเดี่ยวล้มเหลว
Patroni และ Kubernetes จัดการสิ่งนี้โดยอัตโนมัติ หากพ็อดหลักขัดข้อง Patroni จะเลื่อนระดับแบบจำลองภายใน 10-30 วินาที Kubernetes รีสตาร์ทพ็อดที่ล้มเหลว ซึ่งจะเข้าร่วมอีกครั้งในรูปแบบเรพลิกา
โหนดเดี่ยวล้มเหลว
หากโหนดที่ใช้งานพ็อด PostgreSQL เสีย Kubernetes จะจัดกำหนดการพ็อดใหม่บนโหนดที่มีสุขภาพดี พ็อดเชื่อมต่อกับ PVC ที่มีอยู่ (หากพื้นที่จัดเก็บข้อมูลเชื่อมต่อกับเครือข่าย) หรือกู้คืนจากการสำรองข้อมูล (หากใช้พื้นที่จัดเก็บในตัวเครื่อง) กฎการต่อต้านความสัมพันธ์ของพ็อดช่วยให้แน่ใจว่าอินสแตนซ์ที่เหลือยังคงให้บริการการรับส่งข้อมูลต่อไป
สูญเสียคลัสเตอร์อย่างสมบูรณ์
หากคลัสเตอร์ Kubernetes ทั้งหมดสูญหาย ให้ปรับใช้คลัสเตอร์ใหม่ ติดตั้ง PGO และสร้างPostgresClusterใหม่โดยมีdataSourceชี้ไปที่ที่เก็บข้อมูลสำรอง PGO กู้คืนข้อมูลสำรองล่าสุดและเล่น WAL ซ้ำไปยังจุดที่มีอยู่ล่าสุด
ความล้มเหลวระดับภูมิภาค
หากภูมิภาคหลักหายไป ให้เลื่อนระดับคลัสเตอร์สแตนด์บายโดยตั้งค่าstandby.enabled: falseอัปเดต DNS หรือโหลดบาลานเซอร์ของคุณให้ชี้ไปยังภูมิภาคหลักใหม่ เมื่อพื้นที่เดิมฟื้นตัวแล้ว คุณสามารถสร้างความสัมพันธ์ในการสแตนด์บายขึ้นมาใหม่ในแบบย้อนกลับได้
# Promote standby cluster
kubectl patch postgrescluster production-db-standby -n databases --type merge \
  -p '{"spec":{"standby":{"enabled":false}}}'

# Verify the cluster is now an independent primary
kubectl exec -it production-db-standby-pgha1-0 -n databases -- patronictl list
คำสั่งปฏิบัติการ อ้างอิงด่วน
# Cluster status
kubectl get postgrescluster -n databases
kubectl describe postgrescluster production-db -n databases

# Patroni status
kubectl exec -it production-db-pgha1-0 -n databases -- patronictl list
kubectl exec -it production-db-pgha1-0 -n databases -- patronictl history

# Connect to PostgreSQL
kubectl exec -it production-db-pgha1-0 -n databases -- psql -U postgres

# Backup info
kubectl exec -it production-db-pgha1-0 -n databases -- pgbackrest info --stanza=db

# Manual backup
kubectl annotate postgrescluster production-db -n databases \
  postgres-operator.crunchydata.com/pgbackrest-backup="$(date +%s)" --overwrite

# Restart PostgreSQL (rolling)
kubectl annotate postgrescluster production-db -n databases \
  postgres-operator.crunchydata.com/restart="$(date +%s)" --overwrite

# Logs
kubectl logs production-db-pgha1-0 -n databases -c database
kubectl logs production-db-pgha1-0 -n databases -c pgbackrest
kubectl logs production-db-pgha1-0 -n databases -c exporter

# PgBouncer status
kubectl exec -it $(kubectl get pod -l postgres-operator.crunchydata.com/role=pgbouncer -n databases -o name | head -1) -n databases -- psql -U pgbouncer pgbouncer -c "SHOW POOLS;"

# Scale replicas
kubectl patch postgrescluster production-db -n databases --type merge \
  -p '{"spec":{"instances":[{"name":"pgha1","replicas":5}]}}'
สรุป
Crunchy Data PGO แปลง PostgreSQL บน Kubernetes จากภาระในการปฏิบัติงานไปเป็นระบบที่สามารถจัดการและประกาศได้PostgresClusterCRD รวบรวมการปรับใช้ทั้งหมด เช่น อินสแตนซ์ การจำลอง การสำรองข้อมูล การรวมกลุ่ม การตรวจสอบ TLS ในทรัพยากรที่ควบคุมเวอร์ชันเดียว Patroni มีระบบเฟลโอเวอร์อัตโนมัติที่ผ่านการทดสอบการต่อสู้แล้ว pgBackRest มอบการสำรองข้อมูลระดับองค์กรพร้อมการกู้คืน ณ เวลาใดเวลาหนึ่งไปยังที่จัดเก็บออบเจ็กต์บนคลาวด์ PgBouncer จัดการการรวมการเชื่อมต่อที่โมเดลกระบวนการต่อการเชื่อมต่อของ PostgreSQL ต้องการในวงกว้าง และ pgMonitor จะป้อนตัววัดที่คุณต้องการลงใน Prometheus และ Grafana เพื่อการมองเห็นการปฏิบัติงาน
รูปแบบการปรับใช้ทั่วทั้ง AWS EKS, Azure AKS, GCP GKE และ Bare Metal k3s มีข้อมูลจำเพาะหลักPostgresClusterเหมือนกัน — คลาสพื้นที่จัดเก็บข้อมูล การกำหนดค่าพื้นที่เก็บข้อมูลสำรอง และเลเยอร์เครือข่ายมีการเปลี่ยนแปลงอะไรบ้าง ความสม่ำเสมอนี้เป็นคุณค่าที่แท้จริงของแนวทางที่อิงจากผู้ปฏิบัติงาน: ทีมของคุณเรียนรู้เครื่องมือหนึ่งชิ้น โมเดลการปฏิบัติงานหนึ่งชุด และชุดการดำเนินการหนึ่งชุดที่ทำงานได้ทุกที่
เริ่มต้นด้วยคลัสเตอร์สามอินสแตนซ์, PgBouncer ในโหมดการรวมธุรกรรม, กำหนดการสำรองข้อมูลส่วนต่างรายสัปดาห์แบบเต็มบวกรายวัน และการแจ้งเตือน Prometheus หลัก ตรวจสอบขั้นตอนการกู้คืนข้อมูลสำรองของคุณในวันแรก ไม่ใช่เมื่อคุณต้องการมันครั้งแรก ขยายไปสู่คลัสเตอร์สแตนด์บายหลายภูมิภาค การจำลองแบบซิงโครนัส และการปรับแต่งขั้นสูงตามความต้องการด้านความพร้อมใช้งานและความพร้อมในการดำเนินงานของคุณที่เพิ่มขึ้น ผู้ปฏิบัติงานจะจัดการกับกลไก ความรับผิดชอบของคุณคือการทำความเข้าใจสถาปัตยกรรมให้ดีพอที่จะทำให้เกิดการแลกเปลี่ยนที่เหมาะสมสำหรับปริมาณงานของคุณ
เพิ่มเติมจากบล็อก

Observability Is Not Optional: Make It a Business Standard
Why fragmented monitoring creates blind spots, duplicate spend, and slow incidents — and how to make centralised observability a non-negotiable company standard.

WSL Vault for Compliance: One Tenant Never Opens Another’s Secrets
How WSL Vault keeps app, team, and environment tenants cryptographically isolated — so a stolen root-style token cannot empty the estate — and why dual-tenant control beats secrets sprawl.

Workstation AI Shop: Promoting the AI Sales Storefront Through int → test → acc → prod
Workstation AI Shop sells GPU machines with a fully autonomous AI Sales Agent that configures the basket. See how Ring Promoter moves each build through int → test → acc → prod — with Orbit screenshots release engineers and stakeholders share.