บล็อก
กลยุทธ์การสำรองข้อมูลฐานข้อมูลการผลิตที่ใช้งานได้จริง: MySQL และ PostgreSQL
กลยุทธ์การสำรองข้อมูลและการกู้คืนที่ได้รับการพิสูจน์แล้วสำหรับ MySQL และ PostgreSQL ในการผลิต
ในหน้านี้
การสูญเสียข้อมูลการผลิตเป็นเหตุการณ์ประเภทหนึ่งที่ทำให้อาชีพการงานหยุดชะงัก ปิดบริษัท และทำให้หน้าแรกของ Hacker News ด้วยเหตุผลที่ผิดทั้งหมด แต่ทีมส่วนใหญ่ถือว่าการสำรองข้อมูลฐานข้อมูลเป็นเพียงความคิดในภายหลัง ซึ่งเป็นงาน cron ที่ใครบางคนตั้งขึ้นเมื่อสองปีที่แล้วซึ่งไม่มีใครตรวจสอบได้ตั้งแต่นั้นมา บทความนี้จะกล่าวถึงกลยุทธ์การสำรองข้อมูลที่ผ่านการทดสอบแล้วสำหรับ MySQL และ PostgreSQL ที่ได้รับการพิสูจน์แล้วในสภาพแวดล้อมการใช้งานจริง ตั้งแต่คลัสเตอร์ k3s โหนดเดียว ไปจนถึงการปรับใช้งานบนคลาวด์หลายภูมิภาคที่ประมวลผลธุรกรรมหลายล้านรายการต่อวัน
เราจะครอบคลุมทุกด้าน: วิธีการสำรองข้อมูลแบบลอจิคัลและฟิสิคัล การกู้คืน ณ เวลานั้น การตั้งเวลาอัตโนมัติ เป้าหมายที่เก็บข้อมูลบนคลาวด์ การเข้ารหัส การตรวจสอบ วิธีการแบบเนทิฟ Kubernetes และการวางแผนการกู้คืนระบบที่เชื่อมโยงทุกอย่างไว้ด้วยกัน ทุกคำแนะนำมาพร้อมกับการกำหนดค่าที่เป็นรูปธรรมและโค้ดที่คุณสามารถปรับให้เข้ากับสภาพแวดล้อมของคุณได้
ทำความเข้าใจกับประเภทการสำรองข้อมูล
ก่อนที่จะเจาะลึกเข้าไปในเครื่องมือเฉพาะ คุณต้องมีโมเดลทางจิตที่ชัดเจนของกลยุทธ์การสำรองข้อมูลพื้นฐานทั้งสี่และวิธีที่กลยุทธ์เหล่านี้โต้ตอบกับวัตถุประสงค์ในการกู้คืน แต่ละกลยุทธ์จะมีข้อดีข้อเสียที่แตกต่างกันระหว่างความเร็วการสำรองข้อมูล การใช้พื้นที่จัดเก็บข้อมูล และเวลาในการกู้คืน
การสำรองข้อมูลเต็มรูปแบบจับฐานข้อมูลทั้งหมด ณ จุดเวลาเดียว เป็นวิธีที่ง่ายที่สุดในการให้เหตุผลและกู้คืนได้เร็วที่สุด แต่ยังเป็นพื้นที่จัดเก็บที่แพงที่สุดและสร้างช้าที่สุดอีกด้วย การสำรองข้อมูลส่วนเพิ่มจะจับเฉพาะข้อมูลที่มีการเปลี่ยนแปลงตั้งแต่การสำรองข้อมูลประเภทใดก็ตามครั้งล่าสุด การสร้างและกระชับพื้นที่จัดเก็บข้อมูลทำได้รวดเร็ว แต่การคืนค่าจำเป็นต้องเล่นซ้ำทั้งห่วงโซ่: การสำรองข้อมูลเต็มรูปแบบครั้งล่าสุดบวกกับส่วนเพิ่มที่ตามมาทุกๆ ครั้ง การสำรองข้อมูลส่วนต่างจะบันทึกทุกสิ่งที่เปลี่ยนแปลงตั้งแต่การสำรองข้อมูลเต็มรูปแบบครั้งล่าสุด มันใช้พื้นที่ตรงกลาง — ใหญ่กว่าส่วนเพิ่มแต่กู้คืนได้ง่ายกว่า เนื่องจากคุณต้องการเพียงค่าเต็มสุดท้ายบวกกับค่าดิฟเฟอเรนเชียลล่าสุดเท่านั้น สุดท้ายนี้การเก็บถาวรแบบต่อเนื่อง(การเก็บถาวร WAL ใน PostgreSQL การสตรีมบันทึกไบนารีใน MySQL) จะบันทึกทุกธุรกรรมที่เกิดขึ้น ช่วยให้สามารถกู้คืนข้อมูล ณ เวลาใดเวลาหนึ่งระหว่างการสำรองข้อมูลได้
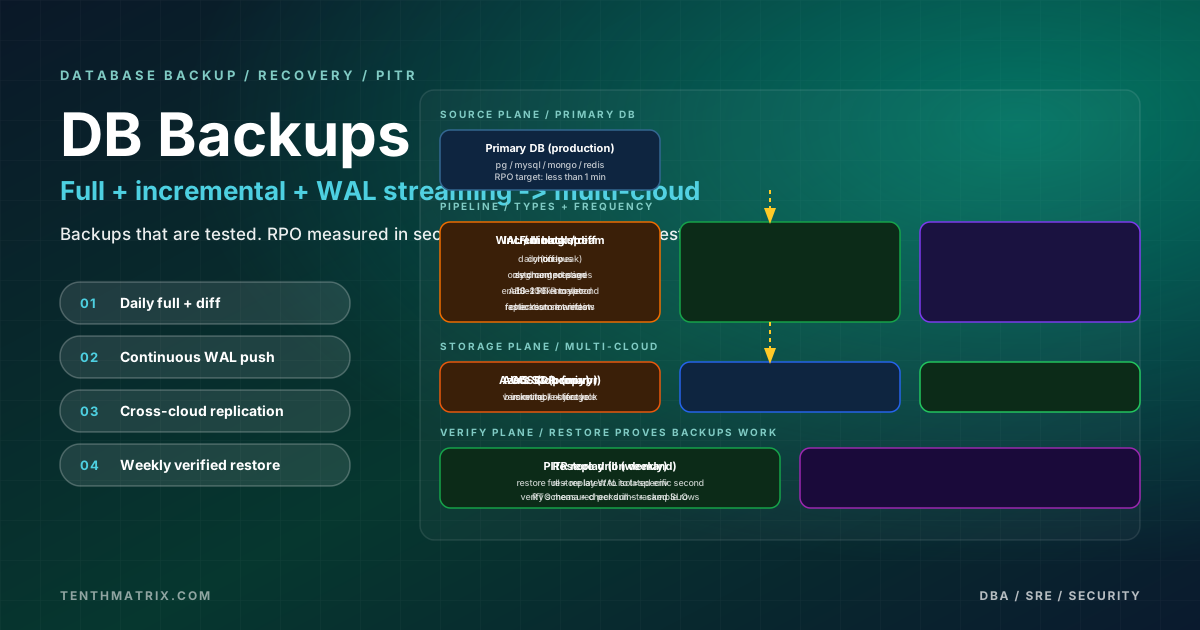
กลยุทธ์ที่เหมาะสมที่สุดสำหรับระบบการผลิตส่วนใหญ่คือการรวมกัน: การสำรองข้อมูลเต็มรูปแบบรายสัปดาห์ ส่วนเพิ่มหรือส่วนต่างรายวัน และการเก็บถาวร WAL/binlog อย่างต่อเนื่อง สิ่งนี้ช่วยให้คุณกู้คืนได้อย่างรวดเร็วจากการสำรองข้อมูลเต็มรูปแบบล่าสุด และสามารถกู้คืนได้ทุกเวลาเมื่อคุณต้องการ
วิธีการสำรองข้อมูล MySQL
MySQL มีเครื่องมือสำรองข้อมูลหลายตัว ซึ่งแต่ละเครื่องมือเหมาะกับขนาดฐานข้อมูลและข้อกำหนดการกู้คืนที่แตกต่างกัน ตัวเลือกที่เหมาะสมขึ้นอยู่กับปริมาณข้อมูล ระยะเวลาการสำรองข้อมูลที่ยอมรับได้ และเป้าหมาย RTO/RPO
mysqldump — การสำรองข้อมูล Universal Logical
mysqldumpสร้างคำสั่ง SQL ที่สร้างสคีมาและข้อมูลขึ้นมาใหม่ มันใช้งานได้กับ MySQL ทุกรุ่นและกลไกการจัดเก็บข้อมูล ทำให้เป็นทางเลือกสากล อย่างไรก็ตาม จะล็อกตารางระหว่างการถ่ายโอนข้อมูล (เว้นแต่จะใช้--single-transactionกับ InnoDB) และความเร็วในการกู้คืนจะลดลงอย่างมากสำหรับฐานข้อมูลที่เกิน 50–100 GB เนื่องจากจะเล่นซ้ำคำสั่ง INSERT แต่ละรายการ
# Full logical backup with consistent snapshot for InnoDB
mysqldump --single-transaction --routines --triggers --events \
  --set-gtid-purged=ON --all-databases \
  | gzip > /backups/mysql-full-$(date +%Y%m%d-%H%M%S).sql.gz

# Single database backup with compression
mysqldump --single-transaction --routines --triggers \
  --databases production_db \
  | pigz -p4 > /backups/production_db-$(date +%Y%m%d).sql.gz

# Schema-only backup for migration planning
mysqldump --no-data --routines --triggers --events \
  --all-databases > /backups/schema-only-$(date +%Y%m%d).sql
mysqlpump - การสำรองข้อมูลเชิงตรรกะแบบขนาน
mysqlpumpปรับปรุงบนmysqldumpด้วยการดัมพ์ตารางแบบขนานและการบีบอัดในตัว สามารถลดเวลาการสำรองข้อมูลสำหรับฐานข้อมูลที่มีตารางอิสระจำนวนมากได้อย่างมาก
# Parallel logical backup with 4 threads and zstd compression
mysqlpump --default-parallelism=4 --compress-output=ZSTD \
  --include-databases=production_db,analytics_db \
  --set-gtid-purged=ON \
  > /backups/mysql-pump-$(date +%Y%m%d).sql.zst
Percona XtraBackup — การสำรองข้อมูลทางกายภาพสำหรับ InnoDB
สำหรับฐานข้อมูลที่มีขนาดใหญ่กว่า 50 GB การสำรองข้อมูลแบบลอจิคัลจะใช้งานไม่ได้ — ทั้งหน้าต่างการสำรองข้อมูลและเวลาการคืนค่าจะขยายเป็นเส้นตรงตามขนาดข้อมูล Percona XtraBackup จะทำสำเนาไฟล์ข้อมูล InnoDB ในระดับกายภาพโดยไม่ต้องล็อกฐานข้อมูล ทำให้เหมาะสำหรับการปรับใช้แบบหลายเทราไบต์
# Full physical backup with streaming to compressed archive
xtrabackup --backup --target-dir=/backups/full-$(date +%Y%m%d) \
  --user=backup_user --password=secure_pass \
  --parallel=4 --compress --compress-threads=4

# Incremental backup based on last full
xtrabackup --backup --target-dir=/backups/incr-$(date +%Y%m%d) \
  --incremental-basedir=/backups/full-20260412 \
  --user=backup_user --password=secure_pass \
  --parallel=4

# Stream full backup directly to S3 via xbstream
xtrabackup --backup --stream=xbstream --compress \
  --user=backup_user --password=secure_pass | \
  aws s3 cp - s3://db-backups/mysql/full-$(date +%Y%m%d).xbstream

# Prepare for restore (apply redo log)
xtrabackup --prepare --target-dir=/backups/full-20260412

# Prepare incremental on top of full
xtrabackup --prepare --apply-log-only --target-dir=/backups/full-20260412
xtrabackup --prepare --target-dir=/backups/full-20260412 \
  --incremental-dir=/backups/incr-20260412

# Restore
systemctl stop mysqld
xtrabackup --copy-back --target-dir=/backups/full-20260412
chown -R mysql:mysql /var/lib/mysql
systemctl start mysqld
MySQL บันทึกไบนารี — การกู้คืนช่วงเวลา
บันทึกไบนารีMySQL บันทึกทุกคำสั่งแก้ไขข้อมูลหรือการเปลี่ยนแปลงแถว เมื่อรวมกับการสำรองข้อมูลแบบเต็มหรือทางกายภาพ จะช่วยให้สามารถกู้คืนข้อมูล ณ เวลาใดเวลาหนึ่งหลังจากการสำรองข้อมูลถูกดำเนินการ
# Enable binary logging in my.cnf
[mysqld]
server-id = 1
log-bin = /var/log/mysql/mysql-bin
binlog_format = ROW
binlog_expire_logs_seconds = 604800   # 7 days
sync_binlog = 1
gtid_mode = ON
enforce_gtid_consistency = ON

# Flush and archive binary logs
mysqladmin flush-logs
mysqlbinlog --read-from-remote-server --host=db-primary \
  --raw --stop-never --result-file=/backup/binlogs/ \
  mysql-bin.000042

# Point-in-time recovery: replay binlog up to specific timestamp
mysqlbinlog --stop-datetime="2026-04-12 14:30:00" \
  /backup/binlogs/mysql-bin.000042 \
  /backup/binlogs/mysql-bin.000043 | mysql -u root
PostgreSQL วิธีการสำรองข้อมูล
ระบบนิเวศการสำรองข้อมูลของPostgreSQL มีความสมบูรณ์มากกว่า MySQL อย่างแน่นอน โดยมีเครื่องมือจากบุคคลที่หนึ่งและชุดโซลูชันชุมชนที่สมบูรณ์ซึ่งสร้างขึ้นโดยเฉพาะสำหรับสภาพแวดล้อมการผลิตขนาดใหญ่
pg_dump และ pg_dumpall — การสำรองข้อมูลแบบลอจิคัล
เช่นเดียวกับmysqldumppg_dumpสร้างการสำรองข้อมูลแบบลอจิคัล รูปแบบที่กำหนดเอง (-Fc) เป็นค่าเริ่มต้นที่แนะนำ เนื่องจากรองรับการกู้คืนแบบขนาน การกู้คืนตารางแบบเลือก และการบีบอัดในตัว
# Custom format with parallel dump (4 worker jobs)
pg_dump -Fc -j4 -f /backups/production-$(date +%Y%m%d).dump production_db

# Directory format for maximum parallelism on large databases
pg_dump -Fd -j8 -f /backups/production-$(date +%Y%m%d)/ production_db

# All databases including globals (roles, tablespaces)
pg_dumpall > /backups/pg-all-$(date +%Y%m%d).sql

# Parallel restore from custom format
pg_restore -j4 -d production_db_restored /backups/production-20260412.dump

# Selective restore: single table
pg_restore -j4 -d production_db -t orders /backups/production-20260412.dump
pg_basebackup - มูลนิธิการสำรองข้อมูลทางกายภาพ
pg_basebackupรับสำเนาทางกายภาพของไดเร็กทอรีข้อมูล PostgreSQL ทั้งหมด เป็นรากฐานสำหรับการกู้คืนแบบสแตนด์อโลนและการตั้งค่าการจำลองแบบสตรีมมิ่ง เมื่อรวมกับการเก็บถาวร WAL จะช่วยให้สามารถกู้คืนข้อมูล ณ เวลาใดเวลาหนึ่งได้
# Physical backup with WAL files included
pg_basebackup -D /backups/base-$(date +%Y%m%d) \
  -Ft -z -Xs -P -c fast \
  -U replication_user -h db-primary

# Stream backup directly to a tar archive with checksums
pg_basebackup -D - -Ft -Xs -c fast \
  -U replication_user -h db-primary | \
  gzip > /backups/pg-base-$(date +%Y%m%d).tar.gz
pgBackRest — การจัดการการสำรองข้อมูลระดับองค์กร
pgBackRest เป็นมาตรฐานทองคำสำหรับการจัดการการสำรองข้อมูล PostgreSQL รองรับการสำรองข้อมูลแบบเต็ม ส่วนเพิ่ม และส่วนต่าง การสำรองและกู้คืนข้อมูลแบบขนาน การเข้ารหัส เป้าหมายที่เก็บข้อมูลหลายรายการ (ดิสก์ในเครื่อง, S3, GCS, Azure Blob) และการเก็บถาวร WAL อัตโนมัติ — ทั้งหมดนี้ผ่านการกำหนดค่าเดียวที่เชื่อมโยงกัน
# /etc/pgbackrest/pgbackrest.conf
[global]
repo1-type=s3
repo1-s3-bucket=pg-backups-production
repo1-s3-endpoint=s3.eu-west-1.amazonaws.com
repo1-s3-region=eu-west-1
repo1-s3-key=AKIAIOSFODNN7EXAMPLE
repo1-s3-key-secret=wJalrXUtnFEMI/K7MDENG/bPxRfiCYEXAMPLEKEY
repo1-path=/pgbackrest
repo1-retention-full=4
repo1-retention-diff=14
repo1-cipher-type=aes-256-cbc
repo1-cipher-pass=a_very_secure_encryption_passphrase

# Second repository for geographic redundancy
repo2-type=azure
repo2-azure-container=pg-backups-dr
repo2-azure-account=prodbackupstorage
repo2-azure-key=base64encodedkeyhere
repo2-path=/pgbackrest
repo2-retention-full=2

process-max=4
compress-type=zst
compress-level=6
log-level-console=info
log-level-file=detail
start-fast=y

[production]
pg1-path=/var/lib/postgresql/16/main
pg1-port=5432

# PostgreSQL WAL archive configuration (postgresql.conf)
# archive_mode = on
# archive_command = 'pgbackrest --stanza=production archive-push %p'

# Create the stanza
pgbackrest --stanza=production stanza-create

# Verify the stanza configuration
pgbackrest --stanza=production check

# Full backup
pgbackrest --stanza=production --type=full backup

# Differential backup
pgbackrest --stanza=production --type=diff backup

# Incremental backup
pgbackrest --stanza=production --type=incr backup

# List backups
pgbackrest --stanza=production info
WAL-G — การเก็บถาวร WAL น้ำหนักเบาไปยัง Cloud Storage
WAL-G เป็นทางเลือกที่ง่ายกว่าสำหรับ pgBackRest ซึ่งมุ่งเน้นไปที่การสตรีมส่วน WAL และการสำรองข้อมูลพื้นฐานไปยังพื้นที่จัดเก็บอ็อบเจ็กต์บนคลาวด์ เป็นที่นิยมในสภาพแวดล้อมแบบคอนเทนเนอร์ซึ่งคุณต้องการไบนารีเดี่ยวที่มีการกำหนดค่าน้อยที่สุด
# Environment variables for WAL-G with S3
export WALG_S3_PREFIX=s3://pg-wal-archive/production
export AWS_ACCESS_KEY_ID=AKIAIOSFODNN7EXAMPLE
export AWS_SECRET_ACCESS_KEY=wJalrXUtnFEMI/K7MDENG/bPxRfiCYEXAMPLEKEY
export AWS_REGION=eu-west-1
export WALG_COMPRESSION_METHOD=lz4
export PGHOST=/var/run/postgresql

# Configure WAL archiving in postgresql.conf
# archive_mode = on
# archive_command = 'wal-g wal-push %p'
# restore_command = 'wal-g wal-fetch %f %p'

# Take a base backup
wal-g backup-push /var/lib/postgresql/16/main

# List backups
wal-g backup-list

# Restore from latest backup
wal-g backup-fetch /var/lib/postgresql/16/main LATEST

# Delete old backups (retain last 4)
wal-g delete retain FULL 4 --confirm
Barman — เซิร์ฟเวอร์สำรองข้อมูลแบบรวมศูนย์
Barman (ตัวจัดการการสำรองข้อมูลและการกู้คืน) ได้รับการออกแบบมาสำหรับสภาพแวดล้อมที่เซิร์ฟเวอร์สำรองข้อมูลเฉพาะจัดการการสำรองข้อมูลสำหรับอินสแตนซ์ PostgreSQL หลายรายการ รองรับทั้งโปรโตคอล rsync/SSH และสตรีมมิ่งการจำลองแบบสำหรับการขนส่งสำรอง
# /etc/barman.d/production.conf
[production]
description = "Production PostgreSQL 16"
ssh_command = ssh postgres@db-primary
conninfo = host=db-primary user=barman dbname=postgres
streaming_conninfo = host=db-primary user=streaming_barman
backup_method = postgres
streaming_archiver = on
slot_name = barman
retention_policy = RECOVERY WINDOW OF 14 DAYS

# Create replication slot and start streaming
barman receive-wal --create-slot production
barman switch-wal --force --archive production

# Take a backup
barman backup production

# List backups
barman list-backup production

# Restore to point in time
barman recover --target-time "2026-04-12 14:30:00" \
  production 20260412T120000 /var/lib/postgresql/16/main
การกู้คืนช่วงเวลา (PITR)
การกู้คืนแบบช่วงเวลาเป็นความสามารถที่สำคัญที่สุดในชุดเครื่องมือสำรองข้อมูลของคุณ ช่วยให้คุณสามารถกู้คืนฐานข้อมูลไปยังสถานะที่แน่นอนในช่วงเวลาใดเวลาหนึ่งได้ ไม่ใช่แค่เมื่อทำการสำรองข้อมูลเท่านั้น แต่ยังรวมถึงวินาทีใด ๆ ระหว่างการสำรองข้อมูลอีกด้วย นี่เป็นสิ่งสำคัญสำหรับการกู้คืนจากการลบข้อมูลโดยไม่ตั้งใจ จุดบกพร่องของแอปพลิเคชันที่ทำให้ข้อมูลเสียหาย และเหตุการณ์ด้านความปลอดภัยที่คุณต้องระบุช่วงเวลาแห่งการประนีประนอมที่แน่นอน
PITR สำหรับ PostgreSQL
PostgreSQL PITR ทำงานโดยการกู้คืนข้อมูลสำรองพื้นฐานและเล่นซ้ำส่วน WAL จนถึงการประทับเวลาเป้าหมาย ด้วย pgBackRest กระบวนการทั้งหมดจะเป็นคำสั่งเดียว
# Restore to specific point in time with pgBackRest
pgbackrest --stanza=production \
  --type=time --target="2026-04-12 16:42:30" \
  --target-action=promote \
  restore

# Manual PITR using pg_basebackup + WAL archive
# 1. Stop PostgreSQL
systemctl stop postgresql

# 2. Clear the data directory and restore base backup
rm -rf /var/lib/postgresql/16/main/*
tar xzf /backups/pg-base-20260412.tar.gz -C /var/lib/postgresql/16/main/

# 3. Create recovery signal and configure restore
cat > /var/lib/postgresql/16/main/postgresql.auto.conf << 'CONF'
restore_command = 'cp /backup/wal_archive/%f %p'
recovery_target_time = '2026-04-12 16:42:30'
recovery_target_action = 'promote'
CONF
touch /var/lib/postgresql/16/main/recovery.signal

# 4. Start PostgreSQL — it will replay WAL and stop at target
systemctl start postgresql
PITR สำหรับ MySQL
MySQL PITR รวมการกู้คืนทางกายภาพ XtraBackup เข้ากับการเล่นซ้ำบันทึกไบนารี
# 1. Restore the XtraBackup
systemctl stop mysqld
rm -rf /var/lib/mysql/*
xtrabackup --prepare --target-dir=/backups/full-20260412
xtrabackup --copy-back --target-dir=/backups/full-20260412
chown -R mysql:mysql /var/lib/mysql
systemctl start mysqld

# 2. Identify the binlog position from XtraBackup metadata
cat /backups/full-20260412/xtrabackup_binlog_info
# Output: mysql-bin.000042  154  3E11FA47-1111-1111-1111-AAAAAAAAAAAA:1-1234

# 3. Replay binlogs up to target time
mysqlbinlog --start-position=154 \
  --stop-datetime="2026-04-12 16:42:30" \
  /backup/binlogs/mysql-bin.000042 \
  /backup/binlogs/mysql-bin.000043 | mysql -u root
สถาปัตยกรรมการสำรองข้อมูลหลายคลาวด์
กลยุทธ์การสำรองข้อมูลการผลิตต้องคำนึงถึงความล้มเหลวของผู้ให้บริการคลาวด์หรือภูมิภาครายเดียว การจัดเก็บข้อมูลสำรองเฉพาะในบัญชีคลาวด์และภูมิภาคเดียวกันกับฐานข้อมูลที่ใช้งานจริงของคุณ หมายถึงบัญชีเดียวที่ถูกบุกรุก ปัญหาการเรียกเก็บเงิน หรือการหยุดทำงานในภูมิภาคสามารถนำทั้งข้อมูลและการสำรองข้อมูลของคุณไปพร้อมๆ กัน สถาปัตยกรรมที่แข็งแกร่งจะส่งการสำรองข้อมูลไปยังเป้าหมายการจัดเก็บข้อมูลอิสระอย่างน้อยสองเป้าหมายพร้อมการจำลองแบบข้ามภูมิภาค
การกำหนดค่าพื้นที่เก็บข้อมูลบนคลาวด์พร้อมนโยบายวงจรการใช้งาน
# AWS S3 lifecycle policy (Terraform)
resource "aws_s3_bucket_lifecycle_configuration" "backup_lifecycle" {
  bucket = aws_s3_bucket.db_backups.id

  rule {
    id     = "backup-tiering"
    status = "Enabled"

    transition {
      days          = 30
      storage_class = "STANDARD_IA"
    }
    transition {
      days          = 90
      storage_class = "GLACIER"
    }
    transition {
      days          = 365
      storage_class = "DEEP_ARCHIVE"
    }
    expiration {
      days = 2555  # 7 years for compliance
    }
  }

  rule {
    id     = "wal-segments"
    status = "Enabled"
    filter {
      prefix = "wal-archive/"
    }
    expiration {
      days = 30
    }
  }
}

# Enable cross-region replication
resource "aws_s3_bucket_replication_configuration" "backup_replication" {
  bucket = aws_s3_bucket.db_backups.id
  role   = aws_iam_role.replication.arn

  rule {
    id     = "cross-region-dr"
    status = "Enabled"
    destination {
      bucket        = aws_s3_bucket.db_backups_dr.arn
      storage_class = "STANDARD_IA"
      encryption_configuration {
        replica_kms_key_id = aws_kms_key.dr_key.arn
      }
    }
    source_selection_criteria {
      sse_kms_encrypted_objects {
        status = "Enabled"
      }
    }
  }
}
# Azure Blob immutability policy (Azure CLI)
az storage container immutability-policy create \
--account-name prodbackupstorage \
--container-name pg-backups \
--period 365 \
--allow-protected-append-writes true
# GCS lifecycle with nearline transition
gsutil lifecycle set /dev/stdin gs://pg-backups-production << 'JSON'
{
"rule": [
{"action": {"type": "SetStorageClass", "storageClass": "NEARLINE"}, "condition": {"age": 30}},
{"action": {"type": "SetStorageClass", "storageClass": "COLDLINE"}, "condition": {"age": 90}},
{"action": {"type": "Delete"}, "condition": {"age": 2555}}
]
}
JSONการสำรองข้อมูลการเข้ารหัสและความปลอดภัย
การสำรองข้อมูลเป็นเป้าหมายที่มีมูลค่าสูงสำหรับผู้โจมตี การสำรองข้อมูลที่ไม่ได้เข้ารหัสที่ถูกขโมยจะทำให้ผู้โจมตีได้รับสำเนาข้อมูลการผลิตของคุณโดยไม่จำเป็นต้องละเมิดระบบที่ทำงานอยู่ของคุณ การสำรองข้อมูลทั้งหมดทั้งระหว่างการส่งและที่เหลือจะต้องได้รับการเข้ารหัส
การเข้ารหัสระหว่างทางหมายถึงการใช้ TLS สำหรับการเชื่อมต่อทั้งหมดระหว่างเซิร์ฟเวอร์ฐานข้อมูลและปลายทางการสำรองข้อมูล ทั้ง pgBackRest และ XtraBackup สตรีมผ่านช่องสัญญาณที่เข้ารหัสเมื่อกำหนดค่าด้วย TLS เมื่อจัดส่งไปยัง S3, Azure Blob หรือ GCS SDK ไคลเอ็นต์จะใช้ HTTPS ตามค่าเริ่มต้น
การเข้ารหัสที่เหลือมีสองชั้น การเข้ารหัสฝั่งเซิร์ฟเวอร์ (SSE) เข้ารหัสข้อมูลหลังจากที่มาถึงเป้าหมายพื้นที่จัดเก็บข้อมูล — S3 SSE-KMS, Azure Storage Service Encryption หรือการเข้ารหัสเริ่มต้น GCS การเข้ารหัสฝั่งไคลเอ็นต์จะเข้ารหัสข้อมูลก่อนที่จะออกจากเซิร์ฟเวอร์ฐานข้อมูล ทำให้มั่นใจได้ว่าผู้ให้บริการระบบคลาวด์จะไม่เห็นข้อมูลข้อความธรรมดา pgBackRest และ WAL-G รองรับการเข้ารหัสฝั่งไคลเอ็นต์โดยกำเนิด
# pgBackRest client-side encryption config
repo1-cipher-type=aes-256-cbc
repo1-cipher-pass=long_random_passphrase_stored_in_vault

# WAL-G client-side encryption
export WALG_LIBSODIUM_KEY=$(cat /etc/wal-g/encryption.key)
# Or GPG-based
export WALG_GPG_KEY_ID=backup@example.com

# MySQL XtraBackup with encryption
xtrabackup --backup --encrypt=AES256 \
  --encrypt-key-file=/etc/mysql/backup-encryption.key \
  --target-dir=/backups/full-encrypted-$(date +%Y%m%d)
จัดเก็บคีย์เข้ารหัสแยกจากข้อมูลสำรอง แนวทางที่แนะนำคือผู้จัดการข้อมูลลับ เช่น HashiCorp Vault, AWS Secrets Manager หรือ Azure Key Vault หากคุณเก็บคีย์ไว้ข้างๆ ข้อมูลสำรอง ผู้โจมตีที่เข้าถึงพื้นที่จัดเก็บข้อมูลสำรองของคุณได้จะมีทุกสิ่งที่ต้องการ
ตั้งเวลาการสำรองข้อมูลอัตโนมัติ
การสำรองข้อมูลด้วยตนเองของไม่ใช่การสำรองข้อมูล แต่เป็นแรงบันดาลใจ กำหนดการสำรองข้อมูลต้องเป็นอัตโนมัติ มีการตรวจสอบ และแจ้งเตือนเมื่อเกิดความล้มเหลว
System Cron สำหรับ Bare Metal และ VMs
# /etc/cron.d/database-backups

# PostgreSQL — pgBackRest
# Full backup every Sunday at 01:00
0 1 * * 0 postgres pgbackrest --stanza=production --type=full backup 2>&1 | logger -t pgbackrest-full

# Differential backup every day at 01:00 (except Sunday)
0 1 * * 1-6 postgres pgbackrest --stanza=production --type=diff backup 2>&1 | logger -t pgbackrest-diff

# MySQL — XtraBackup
# Full backup every Sunday at 02:00
0 2 * * 0 root /usr/local/bin/mysql-backup.sh full 2>&1 | logger -t xtrabackup-full

# Incremental backup every day at 02:00 (except Sunday)
0 2 * * 1-6 root /usr/local/bin/mysql-backup.sh incremental 2>&1 | logger -t xtrabackup-incr

# Backup verification — restore test every Wednesday at 04:00
0 4 * * 3 root /usr/local/bin/verify-backup.sh 2>&1 | logger -t backup-verify
Kubernetes CronJobs
ในสภาพแวดล้อม Kubernetes CronJobs จะแทนที่ cron ของระบบ มีลอจิกการลองใหม่ในตัว การควบคุมการทำงานพร้อมกัน และการผสานรวมกับ RBAC ของคลัสเตอร์และการจัดการความลับ
apiVersion: batch/v1
kind: CronJob
metadata:
  name: pg-backup-full
  namespace: database
spec:
  schedule: "0 1 * * 0"  # Sunday 01:00 UTC
  concurrencyPolicy: Forbid
  successfulJobsHistoryLimit: 4
  failedJobsHistoryLimit: 3
  jobTemplate:
    spec:
      backoffLimit: 2
      activeDeadlineSeconds: 7200  # 2 hour timeout
      template:
        spec:
          serviceAccountName: db-backup
          restartPolicy: OnFailure
          containers:
            - name: pgbackrest
              image: pgbackrest/pgbackrest:2.50
              command:
                - /bin/bash
                - -c
                - |
                  pgbackrest --stanza=production --type=full backup
                  RESULT=$?
                  if [ $RESULT -eq 0 ]; then
                    curl -s -X POST "$SLACK_WEBHOOK" \
                      -d '{"text":"PostgreSQL full backup completed successfully"}'
                  else
                    curl -s -X POST "$SLACK_WEBHOOK" \
                      -d '{"text":"ALERT: PostgreSQL full backup FAILED"}'
                  fi
                  exit $RESULT
              envFrom:
                - secretRef:
                    name: pgbackrest-credentials
                - secretRef:
                    name: slack-webhook
              resources:
                requests:
                  memory: 512Mi
                  cpu: 500m
                limits:
                  memory: 2Gi
                  cpu: "2"
              volumeMounts:
                - name: pgbackrest-config
                  mountPath: /etc/pgbackrest
          volumes:
            - name: pgbackrest-config
              configMap:
                name: pgbackrest-conf
---
apiVersion: batch/v1
kind: CronJob
metadata:
  name: pg-backup-diff
  namespace: database
spec:
  schedule: "0 1 * * 1-6"  # Mon-Sat 01:00 UTC
  concurrencyPolicy: Forbid
  successfulJobsHistoryLimit: 7
  failedJobsHistoryLimit: 3
  jobTemplate:
    spec:
      backoffLimit: 2
      activeDeadlineSeconds: 3600
      template:
        spec:
          serviceAccountName: db-backup
          restartPolicy: OnFailure
          containers:
            - name: pgbackrest
              image: pgbackrest/pgbackrest:2.50
              command:
                - /bin/bash
                - -c
                - |
                  pgbackrest --stanza=production --type=diff backup
              envFrom:
                - secretRef:
                    name: pgbackrest-credentials
              resources:
                requests:
                  memory: 256Mi
                  cpu: 250m
                limits:
                  memory: 1Gi
                  cpu: "1"
              volumeMounts:
                - name: pgbackrest-config
                  mountPath: /etc/pgbackrest
          volumes:
            - name: pgbackrest-config
              configMap:
                name: pgbackrest-conf
---
apiVersion: batch/v1
kind: CronJob
metadata:
  name: mysql-backup-full
  namespace: database
spec:
  schedule: "0 2 * * 0"
  concurrencyPolicy: Forbid
  jobTemplate:
    spec:
      backoffLimit: 2
      activeDeadlineSeconds: 7200
      template:
        spec:
          serviceAccountName: db-backup
          restartPolicy: OnFailure
          containers:
            - name: xtrabackup
              image: percona/percona-xtrabackup:8.0
              command:
                - /bin/bash
                - -c
                - |
                  xtrabackup --backup --stream=xbstream --compress \
                    --user=$MYSQL_BACKUP_USER \
                    --password=$MYSQL_BACKUP_PASS \
                    --host=mysql-primary.database.svc | \
                    aws s3 cp - s3://$S3_BUCKET/mysql/full-$(date +%Y%m%d).xbstream
              envFrom:
                - secretRef:
                    name: mysql-backup-credentials
                - secretRef:
                    name: aws-credentials
              resources:
                requests:
                  memory: 512Mi
                  cpu: 500m
                limits:
                  memory: 2Gi
                  cpu: "2"
Kubernetes-แนวทางการสำรองข้อมูลแบบเนทีฟ
การรันฐานข้อมูลใน Kubernetes นำเสนอมิติใหม่ให้กับกลยุทธ์การสำรองข้อมูล นอกเหนือจากการสำรองข้อมูลฐานข้อมูลระดับแอปพลิเคชันแล้ว คุณต้องพิจารณาการสำรองข้อมูลระดับคลัสเตอร์ (etcd) สแน็ปช็อตวอลุ่มถาวร และการสำรองข้อมูลที่จัดการโดยผู้ให้บริการ
Velero สำหรับการสำรองข้อมูลระดับคลัสเตอร์
Velero สำรองข้อมูลทรัพยากร Kubernetes (การใช้งาน บริการ configmap ข้อมูลลับ) และวอลุ่มถาวร ไม่ใช่การแทนที่การสำรองข้อมูลฐานข้อมูลระดับแอปพลิเคชัน แต่จะบันทึกสแนปช็อตที่สอดคล้องกับข้อขัดข้องของ PV ซึ่งอาจไม่สอดคล้องกันในการทำธุรกรรมสำหรับฐานข้อมูล ใช้ Velero สำหรับการกู้คืนคลัสเตอร์และเครื่องมือระดับแอปพลิเคชัน (pgBackRest, XtraBackup) สำหรับการกู้คืนฐานข้อมูล
# Install Velero with S3 backend
velero install \
  --provider aws \
  --bucket velero-backups \
  --secret-file ./credentials-velero \
  --backup-location-config region=eu-west-1 \
  --snapshot-location-config region=eu-west-1 \
  --use-volume-snapshots=true \
  --plugins velero/velero-plugin-for-aws:v1.9.0

# Create a scheduled backup of the database namespace
velero schedule create db-namespace-backup \
  --schedule="0 3 * * *" \
  --include-namespaces database \
  --ttl 720h \
  --storage-location default \
  --volume-snapshot-locations default

# On-demand backup before maintenance
velero backup create pre-maintenance-$(date +%Y%m%d) \
  --include-namespaces database,monitoring \
  --wait

# Restore a namespace from backup
velero restore create --from-backup pre-maintenance-20260412 \
--include-namespaces databaseLonghorn บน k3s
การใช้งานk3s โดยทั่วไปจะใช้ Longhorn เป็นผู้ให้บริการพื้นที่จัดเก็บข้อมูล CSI Longhorn มอบสแน็ปช็อตระดับเสียงและความสามารถในการจำลองสแน็ปช็อตไปยังพื้นที่จัดเก็บอ็อบเจ็กต์ที่เข้ากันได้กับ S3 สำหรับฐานข้อมูล ให้รวมสแน็ปช็อต Longhorn เข้ากับการสำรองข้อมูลระดับแอปพลิเคชันเพื่อการป้องกันเชิงลึก
# Longhorn recurring snapshot job via CRD
apiVersion: longhorn.io/v1beta2
kind: RecurringJob
metadata:
  name: pg-data-snapshot
  namespace: longhorn-system
spec:
  cron: "0 */4 * * *"  # every 4 hours
  task: snapshot
  retain: 6
  concurrency: 1
  groups:
    - pg-data
  labels:
    app: postgresql
---
# Longhorn recurring backup to S3
apiVersion: longhorn.io/v1beta2
kind: RecurringJob
metadata:
  name: pg-data-s3-backup
  namespace: longhorn-system
spec:
  cron: "0 2 * * *"  # daily at 02:00
  task: backup
  retain: 14
  concurrency: 1
  groups:
    - pg-data
  labels:
    app: postgresql
---
# VolumeSnapshot using Longhorn CSI
apiVersion: snapshot.storage.k8s.io/v1
kind: VolumeSnapshot
metadata:
  name: pg-data-snap-$(date +%Y%m%d)
  namespace: database
spec:
  volumeSnapshotClassName: longhorn-snapshot-vsc
  source:
    persistentVolumeClaimName: pg-data-postgresql-0
การสำรองข้อมูลที่จัดการโดยผู้ให้บริการ
ตัวดำเนินการฐานข้อมูลเช่น CloudNativePG (สำหรับ PostgreSQL) และตัวดำเนินการ Percona (สำหรับ MySQL) ผสานรวมการจัดการการสำรองข้อมูลเข้ากับวงจรการใช้งานฐานข้อมูลโดยตรง ผู้ปฏิบัติงานจัดการการกำหนดเวลา การเก็บถาวร WAL และการเก็บรักษาโดยอัตโนมัติผ่านทรัพยากรที่กำหนดเอง
# CloudNativePG cluster with integrated backup
apiVersion: postgresql.cnpg.io/v1
kind: Cluster
metadata:
  name: production-pg
  namespace: database
spec:
  instances: 3
  storage:
    size: 100Gi
    storageClass: longhorn
  backup:
    barmanObjectStore:
      destinationPath: s3://pg-backups/cnpg/
      endpointURL: https://s3.eu-west-1.amazonaws.com
      s3Credentials:
        accessKeyId:
          name: aws-creds
          key: ACCESS_KEY_ID
        secretAccessKey:
          name: aws-creds
          key: SECRET_ACCESS_KEY
      wal:
        compression: gzip
        maxParallel: 4
      data:
        compression: gzip
    retentionPolicy: "30d"
---
apiVersion: postgresql.cnpg.io/v1
kind: ScheduledBackup
metadata:
  name: production-pg-weekly
  namespace: database
spec:
  schedule: "0 1 * * 0"
  backupOwnerReference: self
  cluster:
    name: production-pg
กลยุทธ์เฉพาะของผู้ให้บริการคลาวด์
AWS — RDS และออโรร่า
AWS RDS ให้สแน็ปช็อตรายวันแบบอัตโนมัติพร้อมการเก็บรักษาที่กำหนดค่าได้ (สูงสุด 35 วัน) และการสำรองข้อมูลอย่างต่อเนื่องผ่านการเก็บถาวรบันทึกธุรกรรมเพื่อการกู้คืน ณ เวลาใดเวลาหนึ่ง Aurora เพิ่ม Backtrack ซึ่งสามารถย้อนกลับคลัสเตอร์ไปยังจุดใดก็ได้ภายในหน้าต่างย้อนกลับโดยไม่ต้องมีการกู้คืน เพียงแต่จะย้อนกลับสถานะภายในของฐานข้อมูล
# Enable automated backups with maximum retention (Terraform)
resource "aws_db_instance" "production" {
  identifier             = "production-pg"
  engine                 = "postgres"
  engine_version         = "16.2"
  instance_class         = "db.r6g.xlarge"
  allocated_storage      = 500
  backup_retention_period = 35  # maximum
  backup_window          = "03:00-04:00"
  copy_tags_to_snapshot  = true
  deletion_protection    = true
  storage_encrypted      = true
  kms_key_id             = aws_kms_key.rds.arn

  # Enable PITR
  enabled_cloudwatch_logs_exports = ["postgresql", "upgrade"]
}

# Cross-region automated backup replication
resource "aws_db_instance_automated_backups_replication" "dr" {
  source_db_instance_arn = aws_db_instance.production.arn
  kms_key_id             = aws_kms_key.dr_rds.arn
  retention_period       = 14
}

# Aurora Backtrack (MySQL-compatible Aurora only)
resource "aws_rds_cluster" "aurora_production" {
  cluster_identifier      = "aurora-production"
  engine                  = "aurora-mysql"
  engine_version          = "8.0.mysql_aurora.3.05.2"
  backtrack_window        = 86400  # 24 hours of backtrack
  backup_retention_period = 35
  preferred_backup_window = "03:00-04:00"
  storage_encrypted       = true
}

# Manual snapshot with cross-region copy
aws rds create-db-snapshot \
  --db-instance-identifier production-pg \
  --db-snapshot-identifier pre-migration-$(date +%Y%m%d)

aws rds copy-db-snapshot \
  --source-db-snapshot-identifier arn:aws:rds:eu-west-1:123456789:snapshot:pre-migration-20260412 \
  --target-db-snapshot-identifier pre-migration-20260412-dr \
  --source-region eu-west-1 \
  --region us-east-1 \
  --kms-key-id arn:aws:kms:us-east-1:123456789:key/dr-key-id
Azure — เซิร์ฟเวอร์ที่ยืดหยุ่น
ฐานข้อมูลAzure สำหรับเซิร์ฟเวอร์ยืดหยุ่น PostgreSQL และ MySQL มีการสำรองข้อมูลอัตโนมัติพร้อมพื้นที่จัดเก็บสำรองภายในเครื่องหรือสำรองทางภูมิศาสตร์ การสำรองข้อมูลแบบซ้ำซ้อนทางภูมิศาสตร์ช่วยให้สามารถกู้คืนข้ามภูมิภาคเพื่อการกู้คืนระบบได้
# Azure Flexible Server with geo-redundant backup (Terraform)
resource "azurerm_postgresql_flexible_server" "production" {
  name                = "production-pg"
  location            = "westeurope"
  resource_group_name = azurerm_resource_group.db.name
  sku_name            = "GP_Standard_D4s_v3"
  version             = "16"
  storage_mb          = 524288  # 512 GB

  backup_retention_days        = 35
  geo_redundant_backup_enabled = true

  authentication {
    active_directory_auth_enabled = true
    password_auth_enabled         = false
  }
}

# Azure Blob immutability for self-managed backups
resource "azurerm_storage_management_policy" "backup_lifecycle" {
  storage_account_id = azurerm_storage_account.backups.id

  rule {
    name    = "backup-tiering"
    enabled = true
    filters {
      blob_types   = ["blockBlob"]
      prefix_match = ["pg-backups/"]
    }
    actions {
      base_blob {
        tier_to_cool_after_days_since_modification_greater_than    = 30
        tier_to_archive_after_days_since_modification_greater_than = 90
        delete_after_days_since_modification_greater_than          = 2555
      }
    }
  }
}
GCP — คลาวด์ SQL
Cloud SQL ให้การสำรองข้อมูลอัตโนมัติและการกู้คืน ณ เวลานอกกรอบ สำหรับฐานข้อมูลแบบจัดการด้วยตนเองบน GCE หรือ GKE นั้น GCS ที่มีคลาสพื้นที่เก็บข้อมูล Nearline และ Coldline จะให้พื้นที่จัดเก็บข้อมูลสำรองระยะยาวที่คุ้มค่า
# Cloud SQL with automated backups and PITR (Terraform)
resource "google_sql_database_instance" "production" {
  name             = "production-pg"
  database_version = "POSTGRES_16"
  region           = "europe-west1"

  settings {
    tier = "db-custom-4-16384"

    backup_configuration {
      enabled                        = true
      start_time                     = "03:00"
      point_in_time_recovery_enabled = true
      transaction_log_retention_days = 7
      backup_retention_settings {
        retained_backups = 30
        retention_unit   = "COUNT"
      }
    }

    ip_configuration {
      ssl_mode = "ENCRYPTED_ONLY"
    }
  }
}

# Export to GCS for long-term retention
gcloud sql export sql production-pg \
  gs://pg-backups-longterm/export-$(date +%Y%m%d).sql.gz \
  --database=production_db \
  --offload
การตรวจสอบการสำรองข้อมูลและการทดสอบการคืนค่า
การสำรองข้อมูลที่ไม่เคยทดสอบไม่ใช่การสำรองข้อมูล แต่เป็นความหวัง การทดสอบการคืนค่าอัตโนมัติควรดำเนินการตามกำหนดเวลาปกติ ทุกสัปดาห์ ในสภาพแวดล้อมที่แยกจากกัน การทดสอบต้องตรวจสอบไม่เพียงแต่ว่าการคืนค่าเสร็จสมบูรณ์โดยไม่มีข้อผิดพลาด แต่ข้อมูลที่กู้คืนนั้นสอดคล้องกัน และแอปพลิเคชันสามารถเชื่อมต่อและสืบค้นได้
#!/bin/bash
# verify-backup.sh — Automated backup verification script
set -euo pipefail

RESTORE_DIR="/tmp/backup-verify-$(date +%Y%m%d-%H%M%S)"
LOG_FILE="/var/log/backup-verify.log"
SLACK_WEBHOOK="${SLACK_WEBHOOK_URL}"
DB_TYPE="${1:-postgresql}"  # postgresql or mysql

log() { echo "[$(date '+%Y-%m-%d %H:%M:%S')] $*" | tee -a "$LOG_FILE"; }
alert() {
  log "ALERT: $*"
  curl -s -X POST "$SLACK_WEBHOOK" \
    -H 'Content-Type: application/json' \
    -d "{\"text\":\"BACKUP VERIFY FAILED: $*\"}"
}

cleanup() {
  log "Cleaning up $RESTORE_DIR"
  rm -rf "$RESTORE_DIR"
  if [ "$DB_TYPE" = "postgresql" ]; then
    pg_ctlcluster 16 verify stop 2>/dev/null || true
  else
    mysqladmin -S /tmp/mysql-verify.sock shutdown 2>/dev/null || true
  fi
}
trap cleanup EXIT

mkdir -p "$RESTORE_DIR"

if [ "$DB_TYPE" = "postgresql" ]; then
  log "Starting PostgreSQL backup verification"

  # Restore latest pgBackRest backup to temporary directory
  pgbackrest --stanza=production \
    --pg1-path="$RESTORE_DIR/pgdata" \
    --type=immediate \
    --target-action=promote \
    restore 2>&1 | tee -a "$LOG_FILE"

  if [ ${PIPESTATUS[0]} -ne 0 ]; then
    alert "pgBackRest restore failed"
    exit 1
  fi

  # Start PostgreSQL on a different port
  pg_ctlcluster 16 verify start -- \
    -D "$RESTORE_DIR/pgdata" \
    -o "-p 5433" \
    -o "-c listen_addresses=127.0.0.1"

  sleep 5

  # Verify data integrity
  TABLES=$(psql -p 5433 -d production_db -t -c \
    "SELECT count(*) FROM information_schema.tables WHERE table_schema='public';")
  log "Verified $TABLES tables exist"

  ROW_CHECK=$(psql -p 5433 -d production_db -t -c \
    "SELECT count(*) FROM orders WHERE created_at > now() - interval '7 days';")
  log "Recent orders count: $ROW_CHECK"

  if [ "$ROW_CHECK" -lt 1 ]; then
    alert "PostgreSQL restore has no recent data — possible stale backup"
    exit 1
  fi

  # Run pg_amcheck for corruption detection (PostgreSQL 14+)
  pg_amcheck -p 5433 -d production_db --heapallindexed 2>&1 | tee -a "$LOG_FILE"

  log "PostgreSQL backup verification PASSED"

else
  log "Starting MySQL backup verification"

  # Prepare and restore latest XtraBackup
  LATEST_FULL=$(ls -td /backups/full-* | head -1)
  cp -r "$LATEST_FULL" "$RESTORE_DIR/mysql-data"
  xtrabackup --prepare --target-dir="$RESTORE_DIR/mysql-data"

  # Start MySQL on a different socket and port
  mysqld --datadir="$RESTORE_DIR/mysql-data" \
    --socket=/tmp/mysql-verify.sock \
    --port=3307 \
    --skip-networking=0 \
    --bind-address=127.0.0.1 &

  sleep 10

  # Verify data
  TABLES=$(mysql -S /tmp/mysql-verify.sock -e \
    "SELECT COUNT(*) FROM information_schema.tables WHERE table_schema='production_db';" -sN)
  log "Verified $TABLES tables exist"

  mysqlcheck -S /tmp/mysql-verify.sock --all-databases --check 2>&1 | tee -a "$LOG_FILE"

  log "MySQL backup verification PASSED"
fi

curl -s -X POST "$SLACK_WEBHOOK" \
  -H 'Content-Type: application/json' \
  -d "{\"text\":\"Backup verification PASSED for $DB_TYPE at $(date)\"}"

log "Verification complete": RTO และ RPO
ทุกกลยุทธ์การสำรองข้อมูลต้องได้รับการออกแบบโดยใช้สองเมตริก ได้แก่Recovery Time Objective (RTO)— ระยะเวลาที่คุณสามารถยอมให้ล่ม — และRecovery Point Objective (RPO)— ปริมาณข้อมูลที่คุณสามารถยอมให้สูญเสียได้ ตัวเลขเหล่านี้ขับเคลื่อนทุกการตัดสินใจเกี่ยวกับความถี่ วิธีการ และสถาปัตยกรรมในการสำรองข้อมูล
| สถานการณ์ | RTO | RPO | กลยุทธ์ |
|---|---|---|---|
| ชำระเงินอีคอมเมิร์ซ | < 5 นาที | 0 (การสูญเสียข้อมูลเป็นศูนย์) | การจำลองแบบซิงโครนัส + การเก็บถาวร WAL อย่างต่อเนื่อง + เฟลโอเวอร์ร้อนสแตนด์บาย |
| SaaS แอปพลิเคชัน | < 30 นาที | < 1 นาที | การจำลองแบบสตรีมมิ่ง + การเก็บถาวรแบบต่อเนื่อง WAL-G + เฟลโอเวอร์อัตโนมัติ |
| เครื่องมือภายใน | < 4 ชั่วโมง | < 1 ชั่วโมง | ส่วนต่างรายวัน + ส่วนเพิ่มรายชั่วโมง + การเก็บถาวร WAL |
| การวิเคราะห์ / คลังข้อมูล | < 24 ชั่วโมง | < 24 ชั่วโมง | การสำรองข้อมูลเต็มรูปแบบทุกวันไปยังที่เก็บข้อมูลบนคลาวด์ |
| การพัฒนา / การแสดงละคร | < 48 ชั่วโมง | < 1 สัปดาห์ | สำรองข้อมูลเต็มรายสัปดาห์ |
สำหรับ RPO เป็นศูนย์ คุณต้องมีการจำลองแบบซิงโครนัสไปยังสแตนด์บายอย่างน้อยหนึ่งรายการ สิ่งนี้จะเพิ่มเวลาแฝงให้กับทุกธุรกรรมการเขียน แต่รับประกันว่าธุรกรรมที่กระทำจะไม่สูญหาย ระบบการผลิตส่วนใหญ่ยอมรับ RPO ที่เกือบเป็นศูนย์ (วินาทีของการสูญเสียที่อาจเกิดขึ้น) โดยใช้การจำลองแบบสตรีมมิ่งแบบอะซิงโครนัสพร้อมการเก็บถาวร WAL/binlog อย่างต่อเนื่อง ซึ่งหลีกเลี่ยงการลงโทษเวลาแฝงในการเขียน
เทมเพลต Runbook การกู้คืนความเสียหายจากภัยพิบัติ# DR Runbook: Database Recovery
## Severity Levels
- P1: Complete data loss / corruption — all hands, CEO notified
- P2: Partial data loss / single region down — on-call team + escalation
- P3: Replica failure / backup failure — on-call investigation
## Recovery Procedures
### Scenario A: Primary DB failure, replicas healthy
1. Promote replica to primary (automated via Patroni / orchestrator)
2. Verify application connectivity
3. Re-establish replication from new primary
4. Investigate root cause
### Scenario B: Complete cluster failure, backups intact
1. Provision new database infrastructure
2. Restore latest full backup
3. Apply WAL/binlog to reach latest consistent point
4. Verify data integrity with checksums
5. Update DNS / connection strings
6. Resume application traffic
7. Re-establish backup schedule immediately
### Scenario C: Data corruption (bad migration / SQL injection)
1. Identify exact timestamp of corruption
2. Restore to point-in-time just before corruption
3. Export affected tables from restored copy
4. Merge clean data into production
5. OR: full PITR restore if corruption is widespread
## Contacts
- DBA on-call: [PagerDuty rotation]
- Infrastructure: [PagerDuty rotation]
- VP Engineering: [phone number]
## Validation Checklist
- [ ] Application health checks pass
- [ ] Row counts match expected ranges
- [ ] Recent transactions are present
- [ ] Replication re-established
- [ ] Backup schedule resumed
- [ ] Post-incident review scheduledการตรวจสอบการสำรองข้อมูลและการแจ้งเตือน
ระบบสำรองข้อมูลล้มเหลวโดยไม่มีการแจ้งเตือน ฐานข้อมูลยังคงทำงานต่อไป แอปพลิเคชันยังคงให้บริการการรับส่งข้อมูล และไม่มีใครสังเกตเห็นว่าการสำรองข้อมูลหยุดทำงานเมื่อสามสัปดาห์ก่อน — จนกว่าจะต้องการ การตรวจสอบเชิงรุกเป็นสิ่งจำเป็น
# Prometheus alerting rules for backup monitoring
apiVersion: monitoring.coreos.com/v1
kind: PrometheusRule
metadata:
  name: backup-alerts
  namespace: monitoring
spec:
  groups:
    - name: database-backups
      rules:
        - alert: BackupTooOld
          expr: |
            (time() - backup_last_successful_timestamp_seconds) > 90000
          for: 10m
          labels:
            severity: critical
          annotations:
            summary: "Database backup is older than 25 hours"
            description: "Last successful backup for {{ $labels.database }} was {{ $value | humanizeDuration }} ago"

        - alert: BackupJobFailed
          expr: |
            kube_job_status_failed{job_name=~".*backup.*"} > 0
          for: 5m
          labels:
            severity: critical
          annotations:
            summary: "Backup CronJob failed: {{ $labels.job_name }}"

        - alert: WALArchivingLagging
          expr: |
            pg_stat_archiver_failed_count > 0
          for: 5m
          labels:
            severity: warning
          annotations:
            summary: "PostgreSQL WAL archiving has failures"

        - alert: BackupStorageQuotaNearing
          expr: |
            (backup_storage_used_bytes / backup_storage_quota_bytes) > 0.85
          for: 30m
          labels:
            severity: warning
          annotations:
            summary: "Backup storage at {{ $value | humanizePercentage }} capacity"

        - alert: BinlogSpaceCritical
          expr: |
            mysql_binlog_size_bytes > 53687091200
          for: 10m
          labels:
            severity: warning
          annotations:
            summary: "MySQL binlog space exceeds 50GB — check archiving"
# Custom Prometheus exporter for pgBackRest metrics
#!/usr/bin/env python3
"""pgBackRest Prometheus exporter — exposes backup age and size metrics."""
import json
import subprocess
import time
from prometheus_client import start_http_server, Gauge
BACKUP_AGE = Gauge('pgbackrest_last_backup_age_seconds', 'Seconds since last backup', ['stanza', 'type'])
BACKUP_SIZE = Gauge('pgbackrest_last_backup_size_bytes', 'Size of last backup', ['stanza', 'type'])
BACKUP_REPO_SIZE = Gauge('pgbackrest_repo_size_bytes', 'Total repository size', ['stanza'])
def collect():
result = subprocess.run(
['pgbackrest', '--output=json', 'info'],
capture_output=True, text=True
)
info = json.loads(result.stdout)
for stanza_info in info:
stanza = stanza_info['name']
for backup in stanza_info.get('backup', []):
backup_type = backup['type']
stop_time = backup['timestamp']['stop']
age = time.time() - stop_time
BACKUP_AGE.labels(stanza=stanza, type=backup_type).set(age)
size = backup['info']['size']
BACKUP_SIZE.labels(stanza=stanza, type=backup_type).set(size)
if __name__ == '__main__':
start_http_server(9854)
while True:
collect()
time.sleep(300)ข้อผิดพลาดทั่วไปและการต่อต้านรูปแบบ
หลังจากจัดการการสำรองฐานข้อมูลในสภาพแวดล้อมการใช้งานจริงหลายสิบรายการ ข้อผิดพลาดเหล่านี้คือสิ่งที่สร้างความเสียหายมากที่สุด
1. การสำรองข้อมูลไปยังดิสก์เดียวกันกับฐานข้อมูลหากดิสก์ล้มเหลว คุณจะสูญเสียทั้งฐานข้อมูลและข้อมูลสำรอง เขียนข้อมูลสำรองไปยังเป้าหมายการจัดเก็บข้อมูลแยกต่างหากเสมอ — เหมาะอย่างยิ่งสำหรับนอกโฮสต์และนอกภูมิภาค
2. ไม่เคยทำการทดสอบการคืนค่าข้อมูลสำรองที่ไม่สามารถกู้คืนได้ไม่ใช่ข้อมูลสำรอง กำหนดเวลาการทดสอบการคืนค่าอัตโนมัติทุกสัปดาห์ และให้วิศวกรดำเนินการฝึกซ้อมการคืนค่าด้วยตนเองทุกไตรมาส
3. อาศัยการจำลองแบบเป็นการสำรองข้อมูลเพียงอย่างเดียว การจำลองแบบไม่ใช่การสำรองข้อมูลDROP TABLEบนเครื่องหลักจะถูกจำลองแบบทันทีไปยังแบบจำลองทั้งหมด การจำลองแบบป้องกันความล้มเหลวของฮาร์ดแวร์ ไม่ใช่ข้อผิดพลาดเชิงตรรกะ
4. ไม่ตรวจสอบงานสำรองข้อมูล งาน Cronล้มเหลวโดยไม่มีการแจ้งเตือน Kubernetes CronJobs ถูกระงับ ข้อมูลรับรอง S3 หมดอายุ งานสำรองข้อมูลทุกงานจะต้องรายงานความสำเร็จหรือความล้มเหลวไปยังระบบตรวจสอบ และแจ้งเตือนหากการสำรองข้อมูลที่สำเร็จครั้งล่าสุดเก่ากว่า RPO ของคุณ
5. การจัดเก็บคีย์เข้ารหัสควบคู่ไปกับการสำรองข้อมูลหากผู้โจมตีเข้าถึงพื้นที่จัดเก็บข้อมูลสำรองของคุณ พวกเขาไม่ควรมีคีย์ถอดรหัสด้วย จัดเก็บคีย์ไว้ในเครื่องมือจัดการข้อมูลลับเฉพาะ
6. ไม่มีนโยบายการเก็บรักษาหากไม่มีนโยบายวงจรการใช้งาน พื้นที่จัดเก็บข้อมูลสำรองก็จะเพิ่มขึ้นอย่างไม่มีขอบเขต กำหนดกรอบเวลาการเก็บรักษาที่ชัดเจน: 7 วันสำหรับเซ็กเมนต์ WAL, 30 วันสำหรับการสำรองข้อมูลรายวัน, 12 เดือนสำหรับการสำรองข้อมูลรายเดือน และดำเนินการลบโดยอัตโนมัติ
7. การละเว้นผลกระทบต่อประสิทธิภาพการสำรองข้อมูลการรันการสำรองข้อมูลเต็มรูปแบบบนฐานข้อมูลหลักในช่วงชั่วโมงเร่งด่วนจะทำให้ประสิทธิภาพของแอปพลิเคชันลดลง กำหนดเวลาการสำรองข้อมูลในช่วงหน้าต่างที่มีการรับส่งข้อมูลต่ำ หรือสำรองข้อมูลจากแบบจำลองเฉพาะ
8. การใช้mysqldumpสำหรับฐานข้อมูลขนาดใหญ่ที่ไม่มี--single-transactionหากไม่มีแฟล็กนี้mysqldumpจะล็อกตาราง โดยบล็อกการเขียนในช่วงเวลาของดัมพ์ สำหรับฐานข้อมูลขนาดใหญ่ อาจหมายถึงการหยุดทำงานเป็นนาทีหรือชั่วโมง
9. การลืมสำรองข้อมูลการกำหนดค่าฐานข้อมูลการกู้คืนข้อมูลมีชัยไปกว่าครึ่งเท่านั้น หากคุณสูญเสียpostgresql.conf,pg_hba.conf,my.cnfการตั้งค่าการจำลองแบบ และการอนุญาตผู้ใช้ คุณไม่สามารถทำให้ฐานข้อมูลกลับสู่สถานะใช้งานได้ รวมไฟล์การกำหนดค่าในกระบวนการสำรองข้อมูลของคุณ
10. ไม่บันทึกขั้นตอนการกู้คืนในระหว่างที่ไฟดับ ผู้ที่กู้คืนฐานข้อมูลอาจไม่ใช่ผู้ที่ตั้งค่าการสำรองข้อมูล Runbook ที่เป็นลายลักษณ์อักษรและผ่านการทดสอบแล้วเป็นสิ่งสำคัญ
การเพิ่มประสิทธิภาพต้นทุนสำหรับพื้นที่จัดเก็บข้อมูลสำรอง
ค่าใช้จ่ายในการจัดเก็บข้อมูลสำรองของสามารถเติบโตได้อย่างรวดเร็ว โดยเฉพาะอย่างยิ่งเมื่อมีการสำรองข้อมูลฐานข้อมูลขนาดใหญ่บ่อยครั้ง กลยุทธ์เหล่านี้ช่วยควบคุมต้นทุนโดยไม่กระทบต่อความสามารถในการกู้คืน
ใช้การสำรองข้อมูลส่วนเพิ่ม/ส่วนต่างส่วนต่างรายสัปดาห์เต็มบวกรายวันใช้พื้นที่จัดเก็บเพียงเล็กน้อย เมื่อเทียบกับการสำรองข้อมูลเต็มรูปแบบรายวัน ความสามารถในการกู้คืนแบบเดลต้าของ pgBackRest หมายถึงการสำรองข้อมูลส่วนเพิ่มจะกู้คืนได้เกือบเร็วเท่ากับการสำรองข้อมูลทั้งหมด
เปิดใช้งานการบีบอัดอัลกอริธึมการบีบอัดสมัยใหม่ เช่น zstd นำเสนออัตราส่วนการบีบอัดที่ยอดเยี่ยม (5:1 ถึง 10:1 สำหรับข้อมูลฐานข้อมูลทั่วไป) โดยมีค่าใช้จ่าย CPU น้อยที่สุด ทั้ง pgBackRest และ XtraBackup รองรับ zstd โดยกำเนิด
ใช้การจัดระดับพื้นที่จัดเก็บข้อมูลย้ายการสำรองข้อมูลไปยังระดับพื้นที่จัดเก็บข้อมูลที่ราคาถูกลงเรื่อยๆ เมื่ออายุมากขึ้น นโยบายวงจรการใช้งานที่แสดงไว้ก่อนหน้านี้ (S3 Standard → IA → Glacier, GCS Standard → Nearline → Coldline) สามารถลดต้นทุนพื้นที่จัดเก็บข้อมูลระยะยาวได้ 70–90%
ทำซ้ำหากเป็นไปได้pgBackRest ใช้การขจัดข้อมูลซ้ำซ้อนระดับบล็อกในพื้นที่เก็บข้อมูล โดยจัดเก็บเฉพาะบล็อกที่เปลี่ยนแปลงในการสำรองข้อมูล สิ่งนี้จะช่วยลดพื้นที่จัดเก็บสำหรับฐานข้อมูลซึ่งข้อมูลส่วนใหญ่เป็นแบบคงที่ได้อย่างมาก
หน้าต่างกักเก็บขนาดที่เหมาะสมหลายทีมตั้งค่าเริ่มต้นในการสำรองข้อมูลตลอดไปโดยใช้ความระมัดระวัง วิเคราะห์รูปแบบการกู้คืนที่แท้จริงและข้อกำหนดการปฏิบัติตามข้อกำหนด จากนั้นตั้งค่าการเก็บรักษาที่ตรงกัน ข้อกำหนดการเก็บรักษา 7 ปีสามารถใช้พื้นที่จัดเก็บข้อมูลแบบ Deep Archive ได้ในราคาต่ำกว่า 1 USD/TB/เดือนสำหรับผู้ให้บริการระบบคลาวด์ส่วนใหญ่
# Cost comparison: Full vs Incremental backup storage
# Assuming 500 GB database, 5% daily change rate, 30-day retention

# Strategy A: Daily full backups
# 500 GB × 30 days = 15,000 GB = 15 TB
# S3 Standard: 15 TB × $0.023/GB = $345/month

# Strategy B: Weekly full + daily incremental
# 4 full × 500 GB = 2,000 GB
# 26 incremental × 25 GB = 650 GB
# Total: 2,650 GB ≈ 2.6 TB
# S3 Standard: 2.6 TB × $0.023/GB = $59.80/month

# Strategy C: Strategy B + lifecycle tiering
# Current week: 525 GB Standard = $12.08
# Weeks 2-4: 2,125 GB Standard-IA = $26.56
# Total: $38.64/month

# Savings: Strategy C is 89% cheaper than Strategy A
รวบรวมทุกอย่างไว้ด้วยกัน: สถาปัตยกรรมการสำรองข้อมูลที่สมบูรณ์แบบ
นี่คือสถาปัตยกรรมการสำรองข้อมูลที่แนะนำสำหรับสภาพแวดล้อมการใช้งานจริงที่ทำงานทั้ง MySQL และ PostgreSQL ซึ่งใช้งานบน Kubernetes พร้อมการกู้คืนความเสียหายแบบมัลติคลาวด์
สำหรับ PostgreSQL:
- pgBackRest เป็นเครื่องมือสำรองข้อมูลหลักที่มีที่เก็บสองแห่ง (S3 + Azure Blob)
- การเก็บถาวร WAL อย่างต่อเนื่องไปยังที่เก็บทั้งสอง
- สำรองข้อมูลเต็มรายสัปดาห์ + ส่วนต่างรายวัน (ผ่าน K8s CronJob)
- Longhorn สแนปช็อตปริมาณทุกๆ 4 ชั่วโมงเพื่อการย้อนกลับอย่างรวดเร็ว
- การตรวจสอบการคืนค่าอัตโนมัติทุกวันพุธ การตรวจสอบ
- Prometheus พร้อมการแจ้งเตือนเกี่ยวกับอายุการสำรองข้อมูล ความล้มเหลว และพื้นที่เก็บข้อมูล
สำหรับ MySQL:
- Percona XtraBackup สำหรับการสำรองข้อมูลทางกายภาพที่สตรีมไปยัง S3
- จัดส่งบันทึกไบนารีอย่างต่อเนื่องเพื่อแยกพื้นที่เก็บข้อมูล
- เต็มรายสัปดาห์ + เพิ่มขึ้นรายวัน (ผ่าน K8s CronJob)
mysqldumpรายวันของสคีมาที่สำคัญสำหรับการสำรองข้อมูลโลจิคัลแบบพกพา- สแนปช็อตปริมาณ Longhorn ทุก 4 ชั่วโมง
- การตรวจสอบการคืนค่าอัตโนมัติทุกวันพฤหัสบดี
สำหรับคลัสเตอร์ Kubernetes:
- Velero สำรองข้อมูลเนมสเปซฐานข้อมูลทุกวันด้วย PV Snapshots
- RKE2/k3s ฯลฯ สแนปช็อตทุกๆ 6 ชั่วโมงไปยังที่เก็บข้อมูลนอกคลัสเตอร์ พื้นที่เก็บข้อมูล
- GitOps เป็นแหล่งที่มาของความจริงสำหรับรายการทั้งหมด
สำหรับการกู้คืนระบบ:
- การจำลองแบบข้ามภูมิภาค
- S3 ไปยังภูมิภาค DR
- Azure GRS สำหรับสำเนาสำรองข้อมูลทางภูมิศาสตร์ซ้ำซ้อน การเจาะลึก DR รายเดือนของ
- : สร้างคลัสเตอร์ใหม่ทั้งหมดจากการสำรองข้อมูลในภูมิภาค DR
- Runbook ที่จัดทำเป็นเอกสารพร้อมแผนผังการตัดสินใจสำหรับสถานการณ์ความล้มเหลวแต่ละสถานการณ์
สรุป
การสำรองข้อมูลฐานข้อมูลเป็นปราการสุดท้ายในการป้องกันระหว่างธุรกิจของคุณกับการสูญเสียข้อมูลที่เป็นหายนะ กลยุทธ์ที่สรุปไว้ในบทความนี้ — การสำรองข้อมูลทางกายภาพและเชิงตรรกะ, การเก็บถาวร WAL และ binlog แบบต่อเนื่อง, พื้นที่จัดเก็บข้อมูลแบบมัลติคลาวด์พร้อมนโยบายวงจรการใช้งาน, การเข้ารหัสทุกเลเยอร์, การตั้งเวลาอัตโนมัติผ่าน Kubernetes CronJobs และการตรวจสอบการคืนค่าอย่างเป็นระบบ — แสดงถึงความทันสมัยในปัจจุบันสำหรับสภาพแวดล้อม MySQL และ PostgreSQL ที่ใช้งานจริง
สิ่งที่สำคัญที่สุดคือ:กลยุทธ์การสำรองข้อมูลนั้นดีพอ ๆ กับการทดสอบการคืนค่าที่ประสบความสำเร็จครั้งล่าสุดเครื่องมือ สคริปต์ และรูปแบบสถาปัตยกรรมทุกรูปแบบในบทความนี้มีไว้เพื่อจุดประสงค์เดียว นั่นคือทำให้แน่ใจว่าเมื่อเกิดเหตุการณ์เลวร้ายที่สุด คุณสามารถกู้คืนข้อมูลของคุณ ปฏิบัติตามข้อผูกพัน RTO และ RPO ของคุณ และช่วยให้ธุรกิจของคุณดำเนินต่อไปได้ สร้างระบบสำรองข้อมูลของคุณ ทำให้เป็นอัตโนมัติ ตรวจสอบ ทดสอบ และทดสอบอีกครั้ง ตัวตนในอนาคตของคุณจะขอบคุณ
เพิ่มเติมจากบล็อก

Observability Is Not Optional: Make It a Business Standard
Why fragmented monitoring creates blind spots, duplicate spend, and slow incidents — and how to make centralised observability a non-negotiable company standard.

WSL Vault for Compliance: One Tenant Never Opens Another’s Secrets
How WSL Vault keeps app, team, and environment tenants cryptographically isolated — so a stolen root-style token cannot empty the estate — and why dual-tenant control beats secrets sprawl.

Workstation AI Shop: Promoting the AI Sales Storefront Through int → test → acc → prod
Workstation AI Shop sells GPU machines with a fully autonomous AI Sales Agent that configures the basket. See how Ring Promoter moves each build through int → test → acc → prod — with Orbit screenshots release engineers and stakeholders share.