TenthMatrix Техническое описание: как повысить эффективность обслуживания и агентов LLM с помощью PagedAttention, vLLM, Self-Debugging, PowerInfer, и EG-MLA. Компаньон: блог · грунтовка: Статья LLMs о Kubernetes · лаборатория: Корпоративная лаборатория искусственного интеллекта.
- Узкое место: Рост и фрагментация кэша KV, а не «модель медленная» в абстрактном смысле.
- PagedAttention: Пейджинг блоков КВ в стиле ОС; настройте размер блока и иерархию кэша.
- vLLM: обслуживание двигателя с практически нулевыми отходами КВ + непрерывное дозирование; посмотрите TTFT против токенов/ов.
- Self-Debugging: ремонт программ с небольшим количеством попыток превосходит огромные наборы кандидатов; крышка патронов в изд.
- PowerInfer: горячий/холодный сплит; Среднее значение 13,20 ток/с / пиковое значение 29,08 на RTX 4090 (цифры на бумаге/репо).
- EG-MLA: KV-сжатие на уровне архитектуры (~91,6% по сравнению с MHA); повторная оценка перед заменой.
1. Почему кризис – это служение, а не обучение
Большие языковые модели изменили НЛП: чат, генерация, инструменты. Обучение стоит дорого один раз; обслуживание дорогое каждую секунду. Декодирование является авторегрессионным. Каждому новому токену нужны предыдущие ключи и значения. Память для этого KV-кеша пропорциональна слоям × головкам × скрытым × последовательности × пакета. Предварительное заполнение требует больших вычислительных ресурсов; декодирование требует большой пропускной способности памяти. Если вы выделяете непрерывный тензор KV максимальной длины для каждого запроса, большая его часть будет пуста до тех пор, пока последовательность фактически не вырастет — классическая внутренняя фрагментация. Параллельные запросы не могут украсть эти дыры. Размер партии уменьшается. Токены в секунду выпадают. GPU выглядят занятыми и все еще простаивают.
Это проблема, на которую PagedAttention и vLLM атаковали в 2023 году, а проблема PowerInfer и более поздних вариантов по-прежнему атакуется с разных сторон.
Смотреть: ментальная модель LLM
Контекстное видео: Введение в большие языковые модели. Объяснение TenthMatrix: как работают LLM и как их запускать в Kubernetes.
2. PagedAttention: подкачка кэша KV
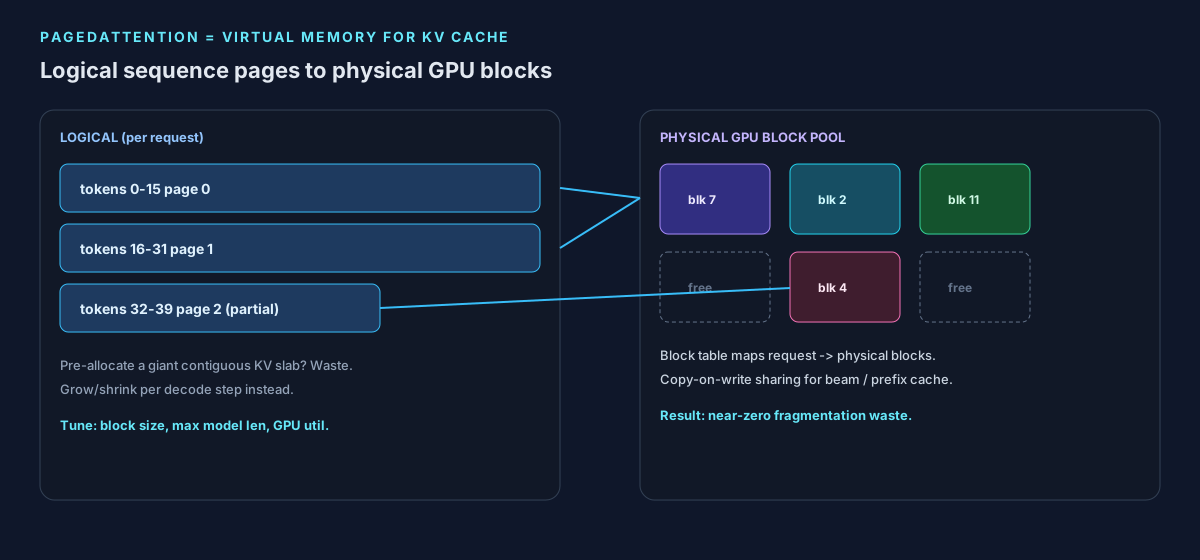
Квон, Ли, Чжуан, Шэн, Чжэн, Ю, Гонсалес, Чжан и Стойка представили PagedAttention как алгоритм внимания, основанный на виртуальной памяти и подкачке ОС, и построили на его основе vLLM. [arXiv:2309.06180]. Идея:
- Разделить КВ на блоки фиксированного размера (небольшое количество токенов на блок).
- Держите таблица блоков от логических позиций токенов к физическим блокам GPU (возможно, несмежным).
- Выделяйте/освобождайте блоки по мере роста или завершения последовательности — как выделение страниц, а не как malloc одного гигантского массива.
- Совместное использование блоков (копирование при записи) для повторного использования префиксов, поиска лучей и параллельной выборки, чтобы не дублировать идентичные префиксы.
Реализация не означает «установку флага на BERT». Ядро внимания должно собирать разбросанные блоки. Планировщик должен знать, какие блоки свободны. Иерархия кэша имеет значение: резидентные блоки HBM, разгрузка CPU и одноранговые узлы NVLink. Размер буфера (блока) — это настоящий регулятор. Слишком маленький: больше поисков по таблицам и накладные расходы ядра. Слишком большой: потрачены впустую слоты внутри последнего частичного блока. Размер блока пары с max_model_len и фактическое соотношение запросов/завершений вашего трафика.
Упражняться: фрагментация профиля (неиспользуемые байты KV/зарезервированные байты KV) и токены/ы вместе. Графики памяти без пропускной способности — суета.
3. vLLM: обслуживающая система на базе пейджера
vLLM утверждает, что потери кэш-памяти KV практически нулевые, а также гибкое совместное использование внутри и между запросами. Оценки в статье показали примерно 2–4× пропускная способность по сравнению с тогдашними системами SOTA (FasterTransformer, Orca) с одинаковой задержкой, с большим выигрышем в длинных последовательностях и более сложным декодированием. Сегодня этот механизм также обеспечивает непрерывную пакетную обработку, предварительное заполнение по частям, кэширование префиксов и тензорное/конвейерное параллельное выполнение для multi-GPU.
Оперативный контрольный список:
- Набор
gpu_memory_utilizationдостаточно высокий, чтобы удерживать веса + KV, и достаточно низкий, чтобы покинуть рабочее пространство CUDA. - Включайте кэширование префиксов только после подтверждения оценок Eval и включения p95 TTFT. твой подсказывает.
- Разделите пулы с интенсивным предзаполнением и интенсивным декодированием, если смешанный трафик нарушает SLO (дезагрегированное обслуживание).
- Размещайте конечные точки, совместимые с OpenAI, за вашим шлюзом (сообщества TenthMatrix часто размещают это позади Шлюз WSL Proxy/API узоры).
from vllm import LLM, SamplingParams

llm = LLM(
    model="meta-llama/Llama-3.1-8B-Instruct",
    gpu_memory_utilization=0.90,
    max_model_len=8192,
    enable_prefix_caching=True,
)
params = SamplingParams(temperature=0.2, max_tokens=256)
outs = llm.generate(["Summarise PagedAttention for a platform engineer."], params)
print(outs[0].outputs[0].text)
Антипаттерн (это нет PagedAttention):
# Classifier forward pass — logits, not paged KV serving
import torch
from transformers import AutoModelForSequenceClassification
model = AutoModelForSequenceClassification.from_pretrained("bert-base-uncased")
out = model(torch.tensor([[1, 2, 3]]), attention_mask=torch.tensor([[1, 1, 1]]))
print(out.logits)
Смотреть: системы обслуживания в дикой природе
Контекстуальный разговор о служении. Каноническая запись: Блог vLLM (PagedAttention) · двигатель: vllm-проект/vllm.
4. Self-Debugging: больше качества на одного кандидата, а не больше кандидатов
Чен, Лин, Кляйн и др. показали, что обучение LLM отладке прогнозируемой программы с помощью демонстраций из нескольких кадров может соответствовать или превосходить базовые показатели, которые генерируют более чем в 10 раз больше кандидатов [arXiv:2304.05128]. Цикл таков: сгенерировать → выполнить или выполнить модульное тестирование → вернуть трассировки обратно → восстановить.
Производственный компромисс: каждое сообщение обратной связи представляет собой еще одно предварительное заполнение + декодирование (или длинное добавление контекста). Точность часто повышается с увеличением количества раундов; так же как и задержка и стоимость. Руководство TenthMatrix для агентов (см. также Muse Glimmer / местные агенты):
- Жесткое ограничение количества раундов отладки (например, 2–4) на каждый вызов инструмента.
- Бюджетируйте токены отдельно от видимого пользователю чата.
- Эскалация до модели человека или специалиста вместо бесконечных повторов.
- Журнал трассировки для оценки. Self-Debugging без телеметрии — это фольклор.
5. PowerInfer: генерация токенов с учетом местоположения
PowerInfer (SJTU IPADS/родственные репозитории) — это система генерации токенов, которая использует локальность активации: небольшой «горячий» нейрон, установленный на GPU, более холодные веса передаются или выполняются на CPU. Опубликованные рабочие точки включают 13,20 токенов/с в среднем и Пиковая скорость 29,08 токенов/с на одном NVIDIA RTX 4090 и до 11,69× по сравнению с llama.cpp с сохранением точности [PowerInfer на GitHub]. (Вилки, ориентированные на пользователя, такие как Tiiny-AI/PowerInfer, выполняют ту же работу.)
Масштабирование — это самая сложная часть. Один профиль местоположения 4090 не становится автоматически работоспособным развертыванием Kubernetes. Вам нужно:
- Честные запросы/ограничения GPU и закрепление CPU с поддержкой NUMA, если работают эксперты по CPU.
- Распределенный план, если модель больше не подходит: тензорная параллель, конвейерная параллель и экспертная параллель.
- Разделение SLO: интерактивный чат, пакетное завершение и циклы инструментов агента.
Используйте PowerInfer (или llama.cpp, или MLX) на рабочих станциях и периферийных устройствах; используйте vLLM (или TensorRT-LLM или SGLang), когда вы заполняете GPU центра обработки данных одновременным трафиком в стиле OpenAI. Измерьте оба. Наш Корпоративная лаборатория искусственного интеллекта Позиция такая же, как и у Polyglot Benchmarks: доказательства, затем ADR.
6. EG-MLA: сосредоточьте внимание на архитектуре
Трюки с подачей не смогут исправить модель, чье KV по своей сути огромно. Отчеты EG-MLA (встраивание скрытого внимания с несколькими головками) уменьшение размера кэша KV более чем на 91,6% по сравнению с многоголовым вниманием (MHA) с незначительным ухудшением, дополнительной экономией по сравнению с MLA (до 59,9%) и улучшенной точностью рассуждения. Авторы утверждают, что внедрение стробирования вызывает неявные взаимодействия высокого порядка и демонстрирует масштабирование за пределами параметров 1B. [EG-MLA, arXiv].
Инженерное значение: это обучение / архитектура решение. Вы не можете переключить EG-MLA на случайный vLLM каждую ночь на Llama-3 и ожидать процентных ставок по бумаге. Если вы управляете предварительной тренировкой или продолжаете предварительную тренировку, EG-MLA является кандидатом на сокращение HBM, прежде чем покупать еще один GPU. Если вы обслуживаете только общедоступные веса, оставайтесь на вариантах PagedAttention + квантование + MLA, которые уже поддерживает механизм, и отслеживайте контрольные точки EG-MLA по мере их появления.
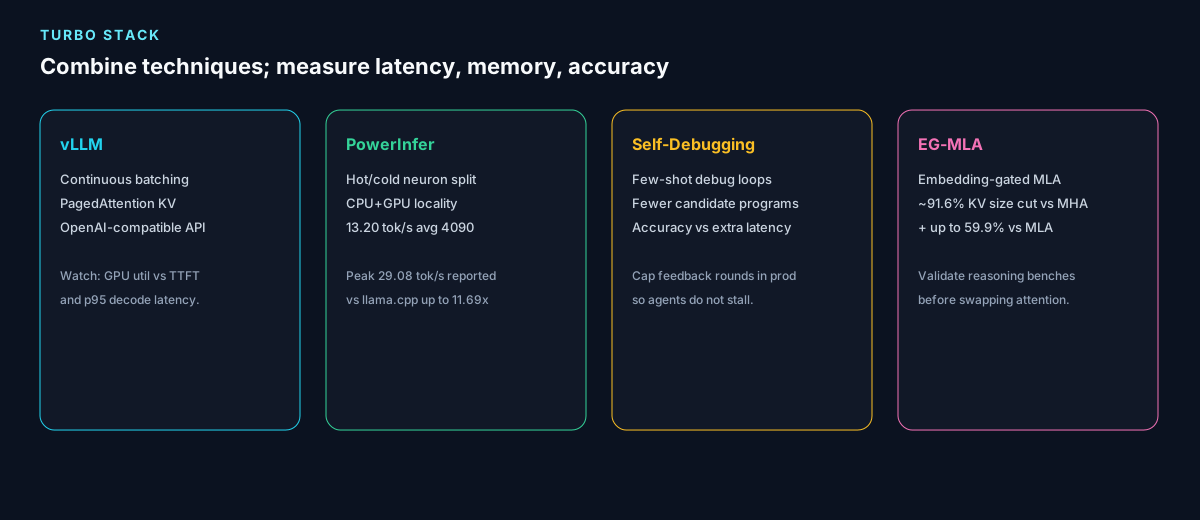
7. Объединение штабеля без карго-культивирования
| Слой | Используйте, когда | Осторожно |
|---|---|---|
| PagedAttention/vLLM | Параллельная обработка API, длинный контекст, общие префиксы | Кэш префиксов vs корректность; OOM при высокой загрузке |
| PowerInfer | Единая ставка GPU/токена рабочей станции | Несоответствие местности; беспорядочное масштабирование |
| Self-Debugging | Циклы кода/агента, которые могут выполнять тесты | Неограниченные раунды; дополнительная стоимость предварительного заполнения |
| EG-MLA | Вы тренируете или настраиваете позвоночник | Не служебный флаг; повторно запустить полную оценку |
8. Масштабируемость в Kubernetes
Хорошо спроектированная распределенная архитектура повышает пропускную способность, а также увеличивает количество режимов сбоя: отстающие, передача кэша KV, перекос токенизатора и автомасштабирование, которые уничтожают «теплые» префиксы. Практический образец (в соответствии с нашим Ollama/vLLM в Kubernetes запись):
- Выделенные пулы узлов GPU; никогда не комплектуйте модули декодирования случайными заданиями CPU.
- Разделите предварительное заполнение и декодирование, если SLO TTFT и SLO токена/ов конфликтуют.
- HPA по глубине очереди или занятости KV GPU, а не только CPU.
- Продвигайте стопки порций через кольца (Ring Promoter), поэтому плохая сборка движка не может пропустить тест.
9. Заключение
Турбонаддув LLM — это не один алгоритм. Это подкачка KV-кэша (PagedAttention), обслуживающий механизм, который не тратит эти страницы впустую (vLLM), генерация с учетом локальности, когда аппаратным обеспечением является рабочая станция GPU (PowerInfer), циклы агентов, которые отлаживают, а не распыляют кандидатов (Self-Debugging), и — когда вы владеете весами — внимание, которое просто сохраняет меньше (EG-MLA). Каждый уровень меняет память, задержку и точность. Измерьте свой трафик. Опубликуйте ДОПОГ. Корабль.
Ссылки
- Квон и др. — Эффективное управление памятью для обслуживания больших языковых моделей с помощью PagedAttention (arXiv:2309.06180, 14 сентября 2023 г.).
- Чен и др. — Обучение самоотладке больших языковых моделей (arXiv:2304.05128, 12 апреля 2023 г.).
- PowerInfer — SJTU-IPADS/PowerInfer (и связанные с ним форки Tiiny-AI).
- EG-MLA — Встраивание скрытого внимания с несколькими головками (arXiv, 20 сентября 2025 г.).
- Блог vLLM — Простое, быстрое и дешевое обслуживание LLM с помощью PagedAttention.
Опубликовано TenthMatrix. Бумажные рисунки указаны как опубликованные первоначальными авторами; производственные показатели в вашем кластере будут отличаться.


