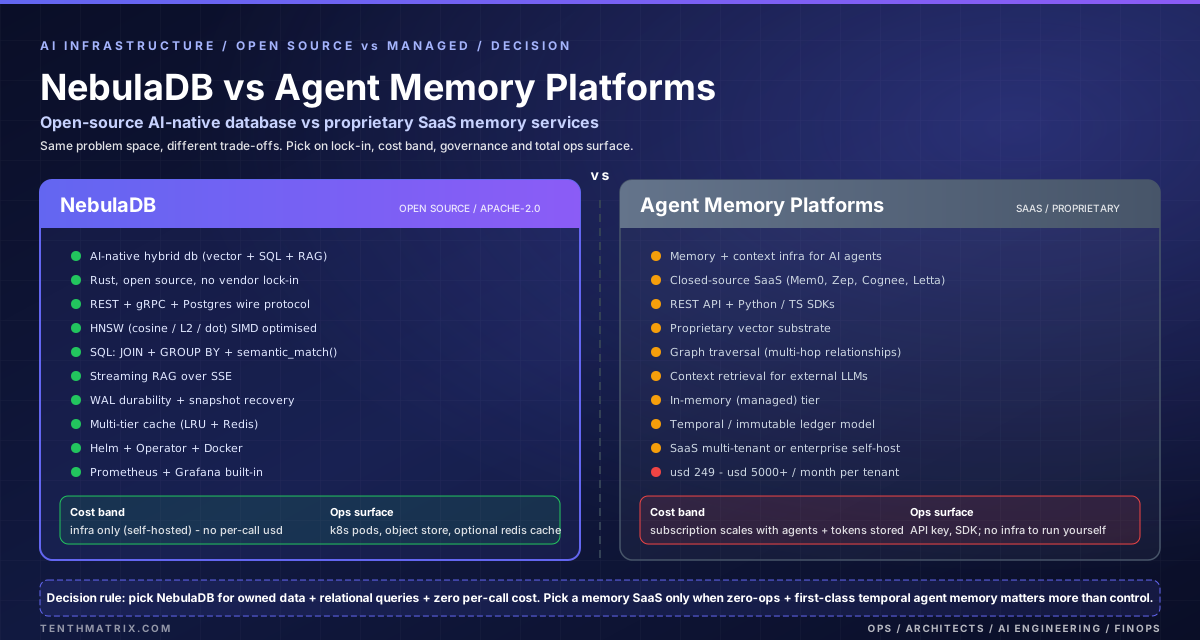
Инфраструктура искусственного интеллекта развивается с головокружительной скоростью. Каждая команда, создающая интеллектуальные приложения, сталкивается с фундаментальным вопросом: какая база данных лежит в основе вашего стека ИИ? Ответ определяет ваши возможности запросов, гибкость развертывания, структуру затрат и, в конечном итоге, вашу способность повторять функции ИИ.
В этой статье представлено всестороннее сравнение между NebulaDB — гибридная база данных с открытым исходным кодом, основанная на искусственном интеллекте, написанная на Rust — и новая категория платформы памяти агентов (собственные SaaS-сервисы, обеспечивающие постоянную память, получение контекста и временное состояние для агентов ИИ). Мы изучаем архитектуру, функции, API, развертывание, стоимость и варианты использования, чтобы помочь вам принять обоснованное решение.
Что такое NebulaDB?
NebulaDB — это гибридная база данных на основе искусственного интеллекта, которая сочетает в себе хранилище документов, векторный поиск, SQL-запросы с расширениями искусственного интеллекта и потоковую генерацию с расширенным поиском (RAG) — и все это в одном двоичном файле Rust. Лицензия: Апач-2.0, он поставляется как автономное решение с образами Docker, диаграммами Helm и полноценным оператором Kubernetes с настраиваемыми определениями ресурсов.
Основные моменты архитектуры
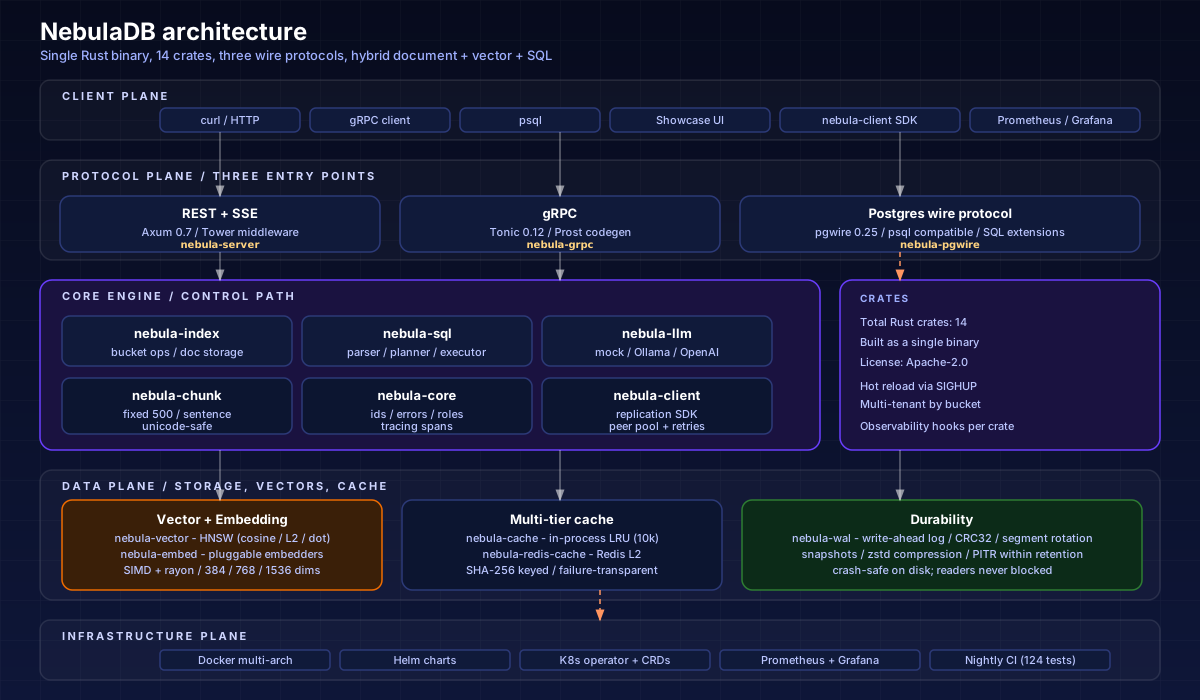
NebulaDB построена как рабочая область 14 ящиков с ржавчиной, каждый из которых отвечает за определенную возможность:
- туманность-сервер — Основной двоичный файл, маршрутизатор Axum, промежуточное программное обеспечение Tower (аутентификация, ограничение скорости, CORS, сжатие)
- туманность-индекс — Базовый TextIndex с документами в сегменте и хранилищем фрагментов
- туманность-вектор — Реализация графика HNSW с косинусом, квадратом L2 и отрицательным скалярным произведением расстояний; SIMD-оптимизирован для x86-64 (AVX2) и aarch64 (NEON)
- туманность-sql — SQL-парсер (sqlparser-rs), планировщик и исполнитель с
semantic_match()иvector_distance()функции - туманность-grpc — Сервисы gRPC на основе тоники: документ, поиск и искусственный интеллект.
- туманность-pgwire — Обработчик проводного протокола Postgres (простой протокол запросов, совместимый с psql)
- туманность-вал — Журнал с упреждающей записью с проверкой целостности CRC32, ротацией сегментов, поддержкой снимков и сжатием zstd.
- туманность-встроить — Подключаемая функция внедрения с реализациями, совместимыми с Mock и OpenAI.
- туманность-LLM — Особенность клиента LLM с бэкэндами Mock, Ollama и OpenAI.
- кусок туманности — Стратегии разбиения документа на части: фиксированного размера (500 символов, перекрытие 50 символов) и на основе предложений.
- туманность-тайник — Внутрипроцессный встроенный кэш LRU (по умолчанию 10 000 записей)
- туманность-redis-кэш — Встраиваемый кэш L2 с поддержкой Redis (с ключом SHA-256, отказоустойчивый)
- ядро туманности — Общие типы: ID, NebulaError, перечисление NodeRole.
- туманность-клиент — SDK для межрегиональной репликации
Три сетевых протокола
NebulaDB одновременно обслуживает три протокола в одном процессе:
- ОТДЫХ + ССЕ (Axum 0.7) — Полный CRUD, семантический поиск, SQL-запросы, потоковая передача RAG с событиями, отправленными сервером, метрики Prometheus, операции администратора.
- gRPC (Tonic 0.12) — Сервисы документов, поиска и искусственного интеллекта с потоковой передачей RAG.
- Проводной протокол Postgres (pgwire 0.25) — Простой протокол запросов, поддерживающий полный диалект SQL, включая расширения AI; связаться с
psql
Что такое платформы памяти агентов?
Платформы памяти агентов — это новая категория собственные SaaS-услуги предназначен для обеспечения постоянной памяти и контекстной инфраструктуры для агентов ИИ. Обычно они имеют:
- Временные графы знаний — Неизменяемое состояние на основе реестра с версионной историей.
- Обход графа — Многошаговые запросы на взаимосвязь, а не поиск только по сходству.
- Слои общего контекста — Примитивы координации для мультиагентных парков
- Управляемая инфраструктура — Мультитенантное SaaS с возможностью корпоративного самостоятельного хостинга
- REST API и языковые SDK — Первичный доступ через HTTP и клиенты Python/JS.
Доступ обычно осуществляется по приглашению или закрытый, а цены варьируются от 249 долларов США в месяц чтобы $5,000+/месяц для корпоративных уровней. Базовые реализации имеют закрытый исходный код.
Прямое сравнение
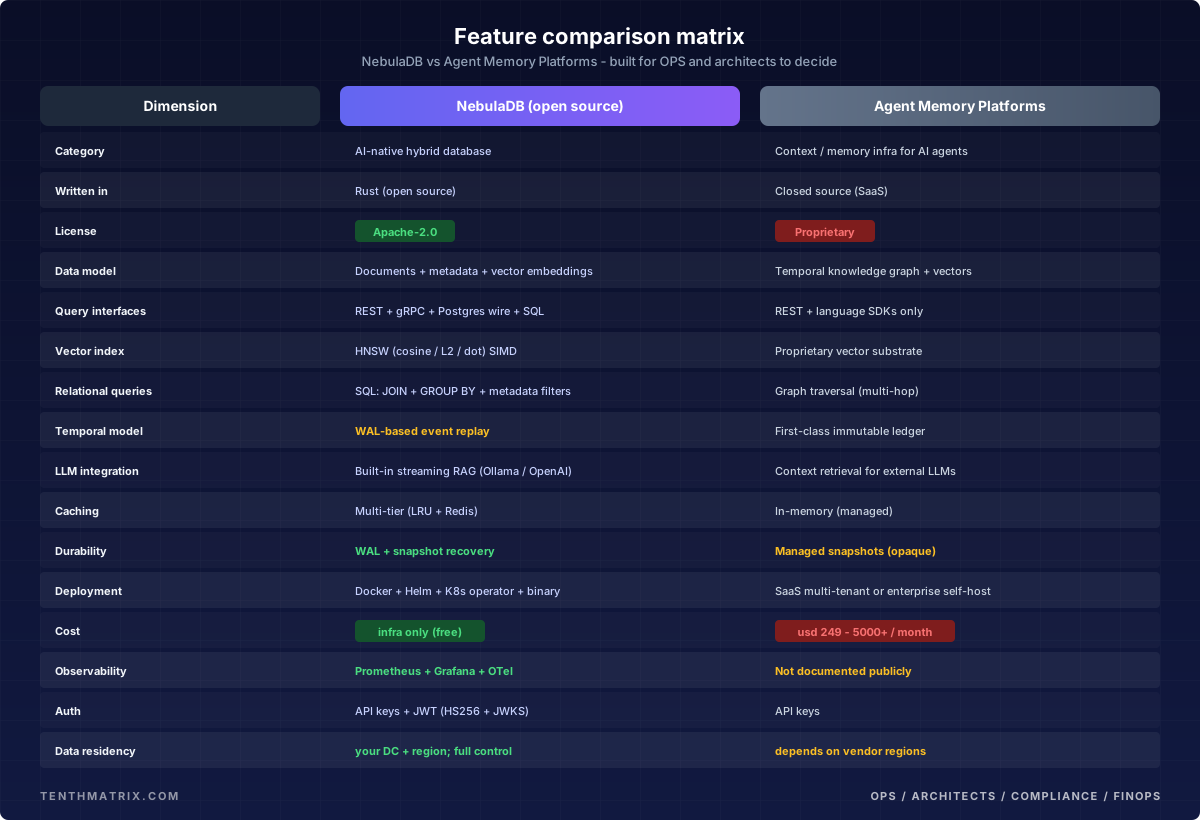
Подробный анализ размеров
Модель данных
NebulaDB хранит документы в сегментах с обширными метаданными (произвольный JSON) и векторными вложениями. Документы могут быть разбиты на части на стороне сервера с сохранением порядка. Эта модель естественным образом сопоставляется с базами знаний, корпусами документов и конвейерами RAG, где вам необходимо принимать, искать и генерировать данные в одной системе.
Управляемые платформы обычно используют временной граф знаний с векторной подложкой, оптимизированной для отслеживания изменения состояния агента с течением времени. Эта модель превосходна для диалоговых агентов, которым необходимо запомнить, что пользователь предпочитал в прошлом месяце, а не сейчас.
Интерфейсы запросов
NebulaDB's четыре интерфейса запросов (REST, gRPC, Postgres Wire, собственный SQL) дают командам гибкость и отсутствие совпадений управляемых платформ. Ваши дата-инженеры используют psql для специальной аналитики. Ваши микросервисы вызывают gRPC для поиска с малой задержкой. Ваш интерфейс использует REST для потоковой передачи RAG. Все они имеют один и тот же индекс — одно исправление ошибки, одно добавление функции появляется повсюду.
Управляемые платформы предлагают REST API и языковые SDK — достаточные для простого поиска, но без SQL-аналитики, совместимости с Postgres и gRPC.
Векторный индекс
NebulaDB реализует HNSW (Иерархические навигационные малые миры) с нуля в Rust с тремя метриками расстояний (косинус, квадрат L2, отрицательное скалярное произведение), SIMD-дружественной автоматической векторизацией, параллелизмом на основе районов и мягкими удалениями, сохраняющими связность графа. Вы можете проверить и настроить индекс, поскольку он имеет открытый исходный код.
Управляемые платформы используют собственные векторные подложки — вы не можете проверять, настраивать или понимать алгоритм поиска, лежащий в основе вашей производственной системы.
SQL с расширениями AI
Это отличительная черта NebulaDB, не имеющая аналогов на управляемых платформах. Механизм SQL поддерживает:
-- Semantic search with metadata filtering
SELECT * FROM knowledge_base
WHERE semantic_match(content, 'Kubernetes deployment patterns')
  AND region = 'eu-west-1'
ORDER BY score DESC
LIMIT 10;

-- Analytics over vector corpus
SELECT department, COUNT(*), AVG(score)
FROM documents
WHERE semantic_match(content, 'quarterly revenue')
GROUP BY department;

-- Cross-bucket JOIN with semantic retrieval
SELECT a.title, b.summary
FROM articles a
INNER JOIN summaries b ON a.doc_id = b.ref_id
WHERE semantic_match(a.content, 'machine learning ops');
Управляемые платформы предлагают запросы обхода графа — мощные возможности для поиска с учетом взаимосвязей, но вы не можете запускать агрегаты GROUP BY, JOIN или комбинировать семантический поиск со структурированной аналитикой SQL.
Интеграция LLM и RAG
NebulaDB имеет встроенный потоковый RAG через /api/v1/ai/rag конечная точка. Когда stream=true, он возвращает события, отправленные сервером:
contextсобытия — полученные фрагменты с оценками, доставленные до того, как LLM начнет генерироватьanswer_deltaсобытия — потоковая передача токенов из LLM (Ollama или OpenAI-совместимая)doneсобытие — маркер завершения с количеством кусков и информацией о модели
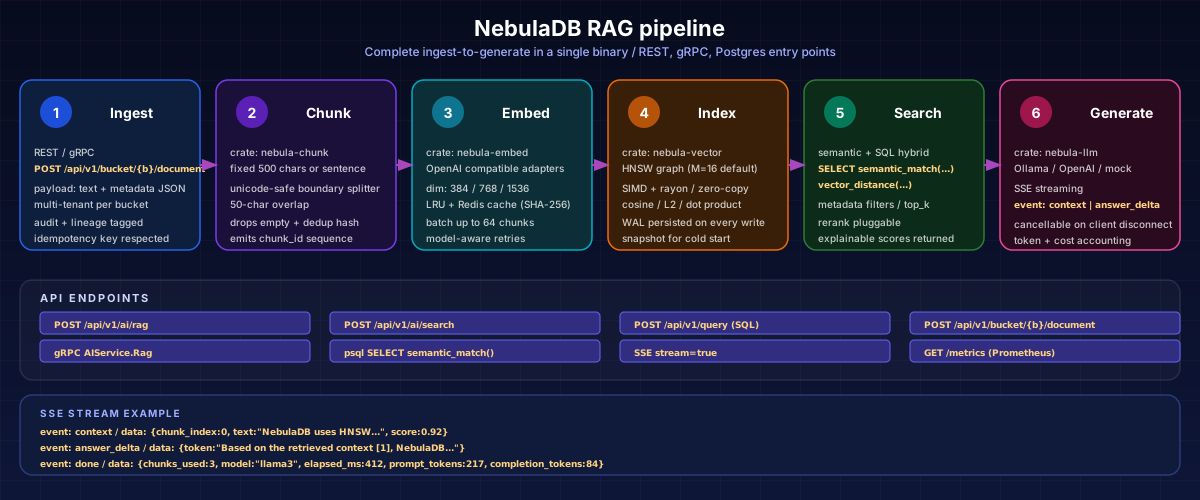
Управляемые платформы предоставляют получение контекста — они возвращают соответствующие фрагменты, но вы должны сами вызвать внешний LLM. Конвейер разделен на два сервиса, что увеличивает задержку и усложняет эксплуатацию.
Кэширование
NebulaDB's многоуровневый встроенный кэш является существенным преимуществом в производительности:
- L1: В процессе LRU — 10 000 записей по умолчанию, получение без копирования.
- L2: Редис — Дополнительный распределенный кэш с записями с ключом SHA-256; отказоустойчивый (постепенное ухудшение, если Redis не работает)
- Кэш результатов SQL — 512 записей с 30-секундным TTL, исключающим повторный семантический поиск
Использование ключей кэша SHA-256(model || 0x00 || text) для предотвращения коллизий между моделями. Уровень пакетной обработки кэширует попадания и промахи за один проход, сводя к минимуму вызовы API для внедрения восходящего потока.
Управляемые платформы управляют кэшированием внутри себя — у вас нет возможности отслеживать частоту попаданий в кэш, нет возможности настраивать размеры кэша и нет контроля над политиками вытеснения.
Долговечность
NebulaDB's Журнал упреждающей записи (WAL) обеспечивает стойкость к ударам:
- 8-байтовый заголовок на запись (длина + CRC32) с кодировкой bincode
- Ротация сегментов, когда файлы превышают настроенный размер
- Векторы сохранены разрешенными — для восстановления не требуется подключение устройства для внедрения к сети.
- Поддержка моментальных снимков для восстановления на определенный момент времени с помощью сжатия zstd.
- Сжатие WAL освобождает диск путем восстановления из снимков.
Топология репликации «лидер/ведомый» использует подписку gRPC WAL для межузловой синхронизации, при этом защита от записи подчиненных применяется на всех трех уровнях протокола (REST: 409, gRPC: FAILED_PRECONDITION, pgwire: SQLSTATE 25006).
Развертывание и эксплуатация
NebulaDB предлагает максимальную гибкость развертывания:
- Одиночный двоичный файл — Загрузите и запустите
- Докер — Многоархивные образы (linux/amd64 + linux/arm64) в Docker Hub, пользователь без полномочий root (UID 10001)
- Докер Составление — Полный стек с Ollama, Redis, Prometheus, Grafana
- Графики Хелма — Сервер, демонстрационный пользовательский интерфейс, дополнительная поддиаграмма Redis, ServiceMonitor для оператора Prometheus.
- Оператор Кубернетеса — CRD:
NebulaCluster,NebulaBucket,NebulaRebalance; входные вебхуки; автоматическое сжатие снимков и WAL перед обновлениями
Управляемые платформы — это SaaS (многоклиентские) с корпоративным самостоятельным хостингом в качестве уровня дополнительных продаж. Вы жертвуете гибкостью развертывания ради удобства эксплуатации.
Наблюдаемость
NebulaDB включает в себя наблюдаемость производственного уровня из коробки:
- Совместимость с Прометеем
/metricsконечная точка - Готовые информационные панели Grafana в стеке Docker Compose.
- Интеграция трассировки (на основе диапазона через контейнер трассировки)
- Поток журнала SSE на
/admin/logs/streamс настраиваемым уровнем - Проверка здоровья в
/healthzс индексной статистикой
Управляемые платформы публично не документируют свои функции наблюдения. Вы не ориентируетесь на производительность кэша, распределение задержек запросов и работоспособность индексов.
Стоимость
NebulaDB — это бесплатно. Лицензия Apache-2.0, самостоятельное размещение, без цен на основе использования, без ограничений по количеству мест и ограничений по функциям. Ваша единственная цена — это инфраструктура, в которой вы ее запускаете.
Управляемые платформы начинаются с 249 долларов США в месяц и масштабировать до $5,000+/месяц. Для стартапа, реализующего продукт искусственного интеллекта, это стоит 3000–60 000 долларов в год, прежде чем вы напишете строку кода приложения.
API и опыт разработчиков
Прием документов (с автоматическим разделением на части)
curl -X POST http://localhost:8080/api/v1/bucket/knowledge/document \
  -H "Authorization: Bearer $NEBULA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "doc_id": "arch-guide-001",
    "text": "NebulaDB uses HNSW for approximate nearest neighbor search...",
    "metadata": {"department": "engineering", "region": "eu-west-1"}
  }'
Семантический поиск
curl -X POST http://localhost:8080/api/v1/ai/search \
  -H "Authorization: Bearer $NEBULA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "query": "How does NebulaDB handle vector indexing?",
    "bucket": "knowledge",
    "top_k": 5
  }'
Стриминг РАГ
curl -N http://localhost:8080/api/v1/ai/rag \
  -H "Authorization: Bearer $NEBULA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "query": "Explain the NebulaDB caching architecture",
    "bucket": "knowledge",
    "top_k": 3,
    "stream": true
  }'
SQL с расширениями AI (через psql)
psql -h localhost -p 5433

SELECT title, score FROM articles
WHERE semantic_match(content, 'Kubernetes deployment patterns')
  AND region = 'eu-west-1'
ORDER BY score DESC
LIMIT 10;
Сопоставление вариантов использования
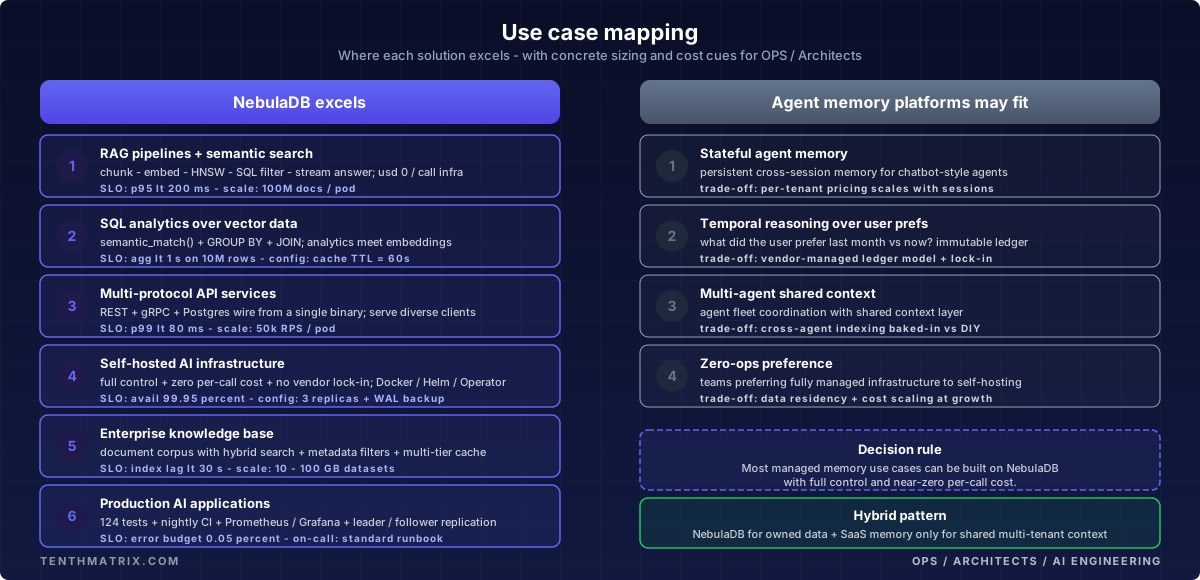
NebulaDB превосходен для
- Конвейеры RAG и семантический поиск — Полный конвейер приема-генерации в одном двоичном файле устраняет необходимость объединять отдельные службы внедрения, индексации и генерации.
- SQL-аналитика по векторным данным — Никакое другое решение не позволит вам запустить
GROUP BY departmentна семантически извлеченных документах. Это открывает возможности для использования аналитики, которые невозможны на платформах, предназначенных только для поиска. - Многопротокольные API-сервисы — Команды с различными требованиями клиентов (веб-интерфейс, микросервисы, инженеры по обработке данных) могут использовать REST, gRPC и проводной протокол Postgres для одного и того же индекса.
- Самостоятельная инфраструктура искусственного интеллекта — Полный контроль над размещением данных, политиками безопасности и масштабированием. Отсутствие привязки к поставщику благодаря лицензированию Apache-2.0.
- База знаний и поиск документов — Корпоративные корпуса документов с гибридным поиском, сочетающим семантическое сходство и фильтры метаданных.
- Производственные приложения искусственного интеллекта — Благодаря 124 тестам, ночной CI, многоархивным образам Docker, диаграммам Helm, оператору Kubernetes и наблюдаемости Prometheus/Grafana, NebulaDB готова к работе.
Управляемые платформы могут подойти для
- Память агента с сохранением состояния — Постоянная межсессионная память для ИИ-агентов типа чат-ботов, где временное состояние является основным требованием.
- Временное рассуждение — Когда «что пользователь предпочел в прошлом месяце?» — это основной шаблон запроса, а неизменяемый реестр не подлежит обсуждению.
- Общий многоагентный контекст — Координация парка агентов с помощью встроенных слоев общего контекста.
- Команды нулевого оперативного вмешательства — Команды, которые предпочитают полностью управляемую инфраструктуру и готовы пойти на компромисс в отношении стоимости и привязки к поставщику.
Стоит отметить, что многие варианты использования управляемой платформы также могут быть построены на NebulaDB — воспроизведение событий на основе WAL обеспечивает временные возможности, а расширяемая архитектура поддерживает настраиваемые уровни памяти агента.
Структура принятия решений
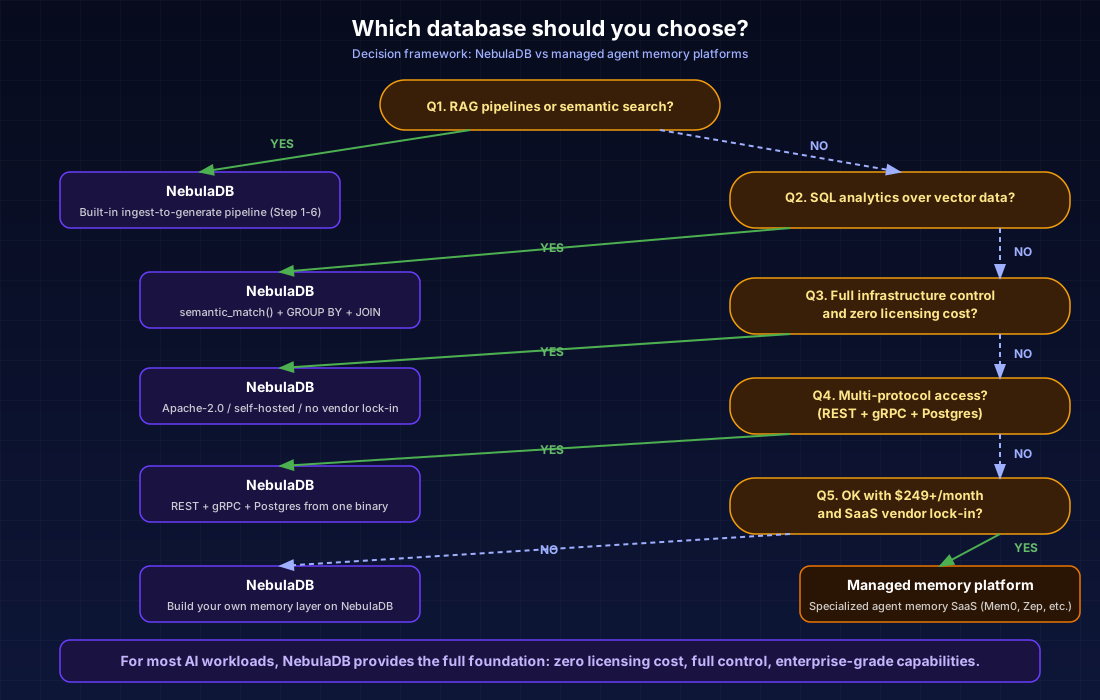
Зрелость и производственная готовность
NebulaDB демонстрирует сильные инженерные практики:
- 124 модульных теста по всему рабочему пространству с стабильной версией Clippy-clean Rust
- Наборы интеграционных тестов включая REST CRUD, потоковую передачу RAG, pgwire SQL, метрики Prometheus и нагрузочное тестирование (60 одновременных запросов, p95 <750 мс)
- Ночной CI в 02:00 UTC с настраиваемыми моделями Олламы
- Многоархивные сборки Docker в основных тегах push и semver
- Тестирование на основе свойств через proptest и тесты через Criterion
Управляемые платформы, как правило, представляют собой SaaS ранней стадии с доступом по приглашению, ограниченной общедоступной документацией и отсутствием наблюдаемых CI или методов тестирования.
Заключение
Для подавляющего большинства рабочих нагрузок ИИ — конвейеров RAG, семантического поиска, поиска документов, SQL-аналитики по внедрению, баз знаний — NebulaDB предоставляет возможности корпоративного уровня при нулевых затратах и полном контроле над инфраструктурой.. Его основа Rust обеспечивает безопасность и производительность памяти. Трехпротокольная архитектура означает, что вся ваша организация может получить доступ к одним и тем же данным через предпочтительный интерфейс. А оператор Kubernetes, надежность WAL и наблюдаемость Prometheus делают его готовым к производству.
Платформы памяти агентов служат более узкой нише: команды создают диалоговые агенты с сохранением состояния, которым необходимы нестандартные временные рассуждения и которые предпочитают платить за управляемую инфраструктуру, а не использовать собственную. Для этих команд затраты в размере 249–5000 долларов США в месяц обеспечивают удобство эксплуатации за счет привязки к поставщику, ограниченных возможностей запросов и непрозрачной инфраструктуры.
Для большинства команд, создающих приложения ИИ, NebulaDB — очевидный выбор. Это полноценная основа для инфраструктуры данных на основе искусственного интеллекта — с открытым исходным кодом, готовая к использованию и бесплатная.


