Blog
NebulaDB vs plataformas de memória de agentes: por que o open source ganha
Por que uma base AI-native open source supera serviços SaaS proprietários de memória para RAG, pesquisa semântica e infraestrutura de IA
Nesta página
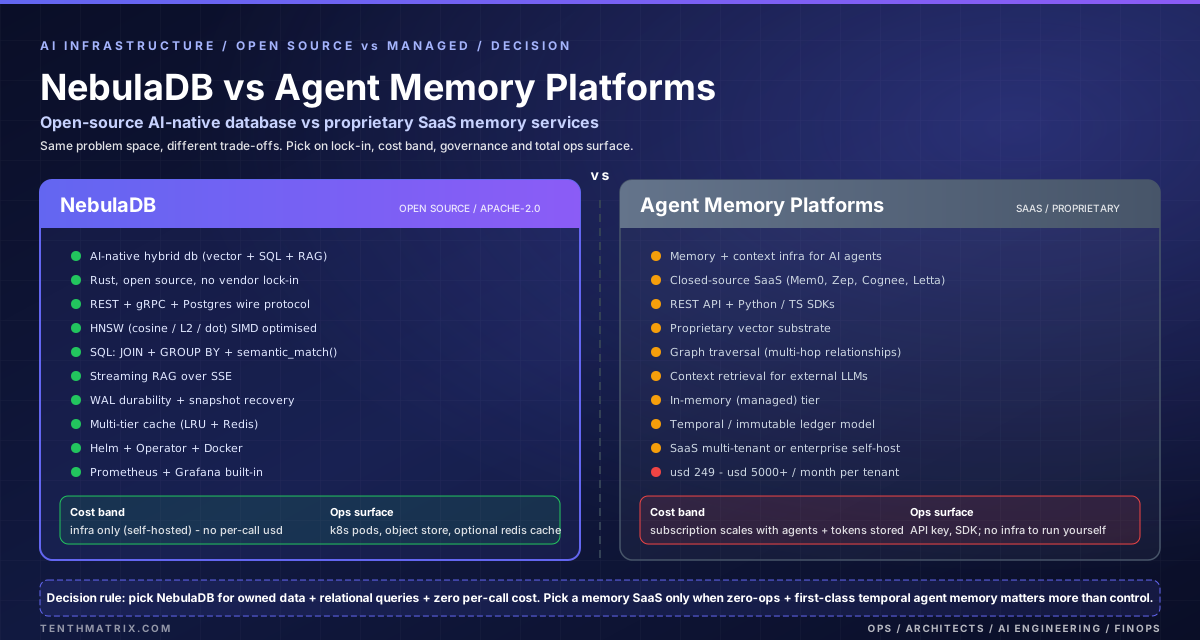
O panorama da infraestrutura de IA evolui rapidamente. Equipas que constroem pipelines RAG, pesquisa semântica e aplicações inteligentes enfrentam uma escolha fundamental: adota uma base de dados AI-native de propósito geral que controla, ou paga por uma plataforma de memória de agentes que trata da infraestrutura por si?
Este post compara NebulaDB — a nossa base híbrida AI-native open source impulsionada por Rust — face à categoria emergente de plataformas de memória de agentes (serviços SaaS que fornecem memória persistente, recuperação de contexto e estado temporal para agentes de IA). O deep-dive completo está disponível como artigo completo; aqui cobrimos os destaques.
O que é NebulaDB?
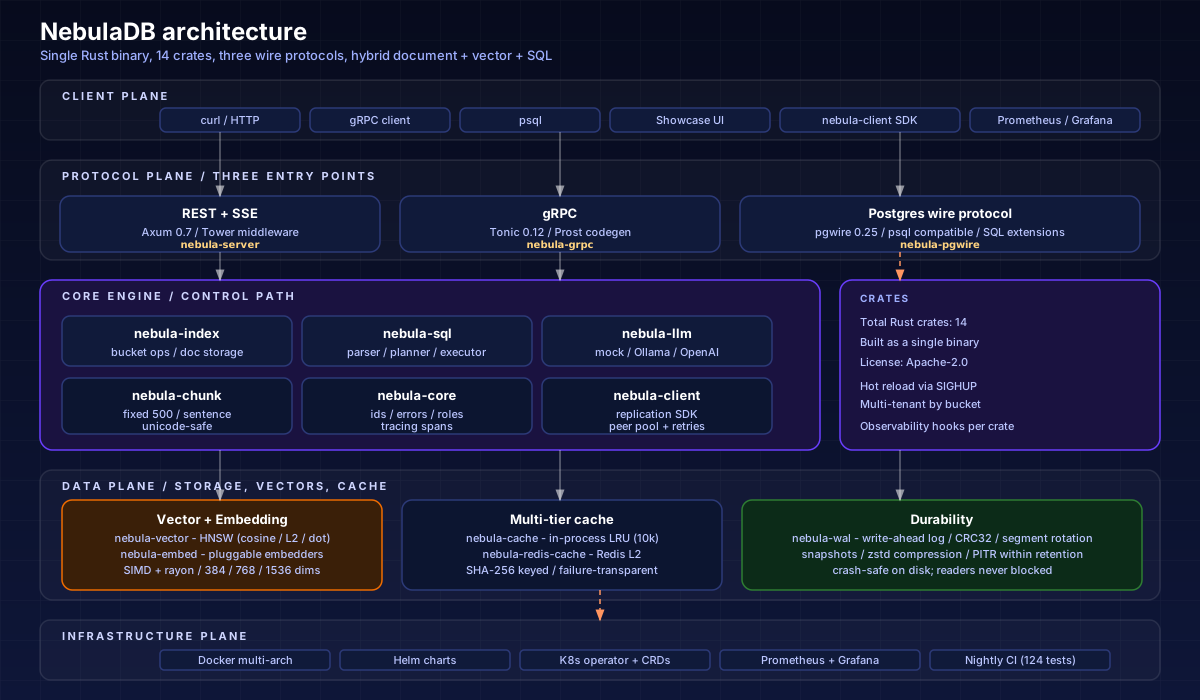
NebulaDB é uma base de dados híbrida AI-native que combina armazenamento documental, pesquisa vetorial (HNSW), consultas SQL com extensões de IA e RAG em streaming — tudo num único binário Rust. Com licença Apache-2.0, é entregue como solução self-hosted com Docker, charts Helm e um Operator Kubernetes completo.
Capacidades-chave de relance
- Três protocolos a partir de um único binário: REST+SSE (Axum), gRPC (Tonic), protocolo wire Postgres
- Índice vetorial HNSW: Distâncias cosseno, L2 e produto interno com otimização SIMD
- SQL com extensões de IA:
semantic_match()evector_distance()como funções SQL de primeira classe, mais GROUP BY, JOIN e agregados - RAG em streaming: Server-Sent Events com chunks de contexto antes dos tokens de resposta — geração em tempo real
- Pipeline completo: Ingest → Chunk → Embed → Index → Search → Generate num só sistema
- Cache multi-nível: LRU in-process (10.000 entradas) + Redis opcional com fallback transparente a falhas
- Durabilidade WAL: write-ahead log verificado com CRC32 com recovery por snapshot e compressão zstd
- Nativo de Kubernetes: CRDs para NebulaCluster, NebulaBucket e NebulaRebalance via um operator dedicado
- Pronto para produção: 124 testes, CI nightly, imagens Docker multi-arch, observabilidade Prometheus + Grafana
O que são plataformas de memória de agentes?
As plataformas de memória de agentes são uma categoria mais recente de serviços SaaS proprietários concebidos para fornecer infraestrutura de memória persistente e contexto para agentes de IA. Tipicamente oferecem grafos de conhecimento temporais, ledgers de estado imutáveis e camadas de contexto partilhado para sistemas multi-agente. O acesso costuma ser via APIs REST e SDKs de linguagem, com preços a partir de $249/mês até $5,000+ para tiers enterprise.
A comparação: por que o NebulaDB ganha
Eis como o NebulaDB se compara às plataformas de memória de agentes nas dimensões que mais importam:
| Dimensão | NebulaDB | Plataformas geridas |
|---|---|---|
| Licença | Apache-2.0 (free) | Proprietário ($249-$5k+/mês) |
| Escrito em | Rust (open-source) | Desconhecido (closed-source) |
| Interfaces de consulta | REST, gRPC, Postgres, SQL | API REST, SDKs |
| Índice vetorial | HNSW (SIMD-optimized) | Proprietário |
| Integração LLM | RAG em streaming integrado | Apenas recuperação de contexto |
| Observabilidade | Prometheus + Grafana | Não documentado |
| Implementação | Docker, Helm, Operator K8s | SaaS ou self-host enterprise |
Framework de decisão
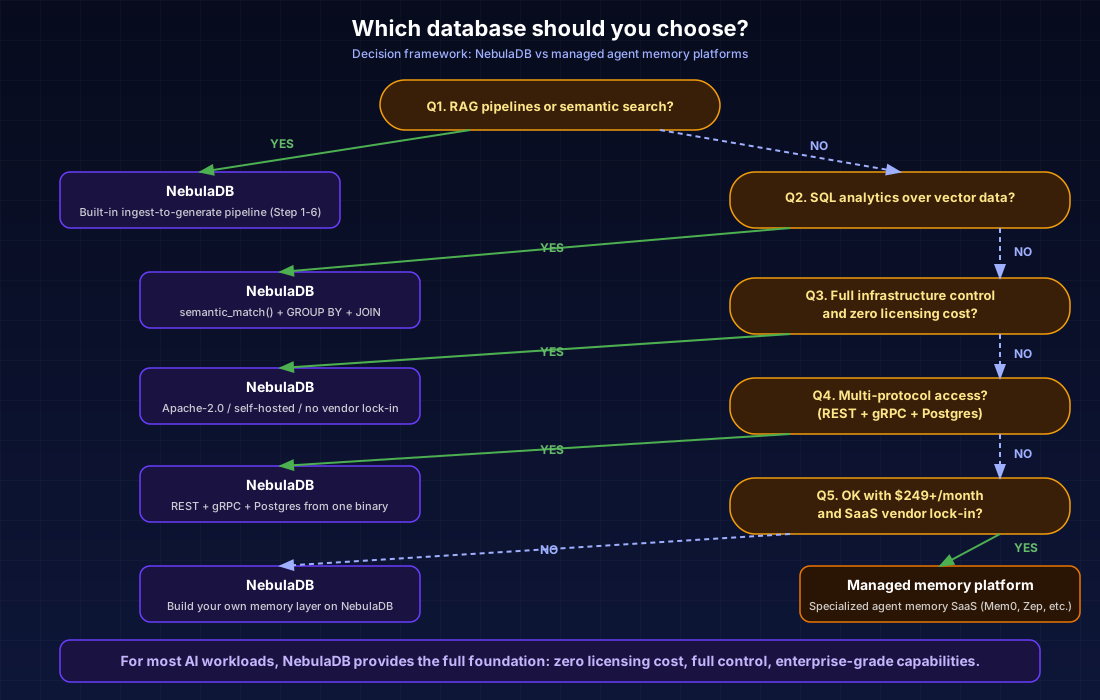
Escolha NebulaDB se:
- Quer controlo total da sua infraestrutura sem vendor lock-in
- Está a construir pipelines RAG com respostas LLM em streaming
- Precisa de acesso multi-protocolo (REST + gRPC + Postgres a partir de um único binário)
- Quer analítica SQL sobre o seu corpus vetorial (GROUP BY, JOIN com filtros semânticos)
- Importa-lhe o custo — o NebulaDB é gratuito e open source
- Precisa de observabilidade de grau produção (Prometheus, Grafana, tracing)
- Quer um pipeline completo: ingest → chunk → embed → index → search → generate
Plataformas geridas podem encaixar se:
- Está a construir agentes de IA stateful que precisam de memória persistente entre sessões
- Precisa de raciocínio temporal ("o que o utilizador preferia no mês passado vs agora?")
- Tem sistemas multi-agente que exigem camadas de contexto partilhado
- Prefere zero carga de ops e está disposto a pagar $249+/mês
Conclusão
Para a maioria das cargas de IA — pipelines RAG, pesquisa semântica, recuperação de documentos, analítica SQL sobre embeddings — O NebulaDB entrega capacidades de nível enterprise a custo zero com controlo total da infraestrutura. A base em Rust garante performance e segurança, enquanto a arquitetura de três protocolos (REST, gRPC, Postgres wire) permite integrar as suas ferramentas e workflows existentes sem fricção.
As plataformas de memória de agentes servem um nicho mais estreito: equipas que constroem agentes conversacionais stateful que precisam de raciocínio temporal e aceitam vendor lock-in e custos recorrentes. Mesmo nesses casos, o replay de eventos baseado em WAL e a arquitetura extensível do NebulaDB oferecem uma alternativa self-hosted viável.
Leia o artigo de comparação completo para deep-dives de arquitetura, exemplos de API e análise detalhada em 15+ dimensões.
Mais do blog

Observability Is Not Optional: Make It a Business Standard
Why fragmented monitoring creates blind spots, duplicate spend, and slow incidents — and how to make centralised observability a non-negotiable company standard.

WSL Vault for Compliance: One Tenant Never Opens Another’s Secrets
How WSL Vault keeps app, team, and environment tenants cryptographically isolated — so a stolen root-style token cannot empty the estate — and why dual-tenant control beats secrets sprawl.

Workstation AI Shop: Promoting the AI Sales Storefront Through int → test → acc → prod
Workstation AI Shop sells GPU machines with a fully autonomous AI Sales Agent that configures the basket. See how Ring Promoter moves each build through int → test → acc → prod — with Orbit screenshots release engineers and stakeholders share.