Blog
Muse Glimmer no Ollama: agentes locais sempre ativos em um GPU
Modelo de agente 30B Apache 2.0 da Meta – uso de ferramentas, visão, recuperação de falhas – e o que isso significa para IA privada em estações de trabalho
Nesta página
MetaMuse Glimmeré um modelo aberto 30B ajustado para agentes locais sempre ativos - uso de ferramentas, tarefas longas, recuperação de falhas, visão - e é fornecido noOllamasob Apache 2.0 para um único GPU ou Apple Silicon. Aqui está a visão comercial do TenthMatrix. Especificações, bancadas, metodologia e uma lista de verificação de produção no longo artigo.
ollama launch. Privacidade, espaço aéreo e custo unitário previsível tornam-se características do produto – e não projetos de pesquisa.O que foi enviado (em termos comerciais)
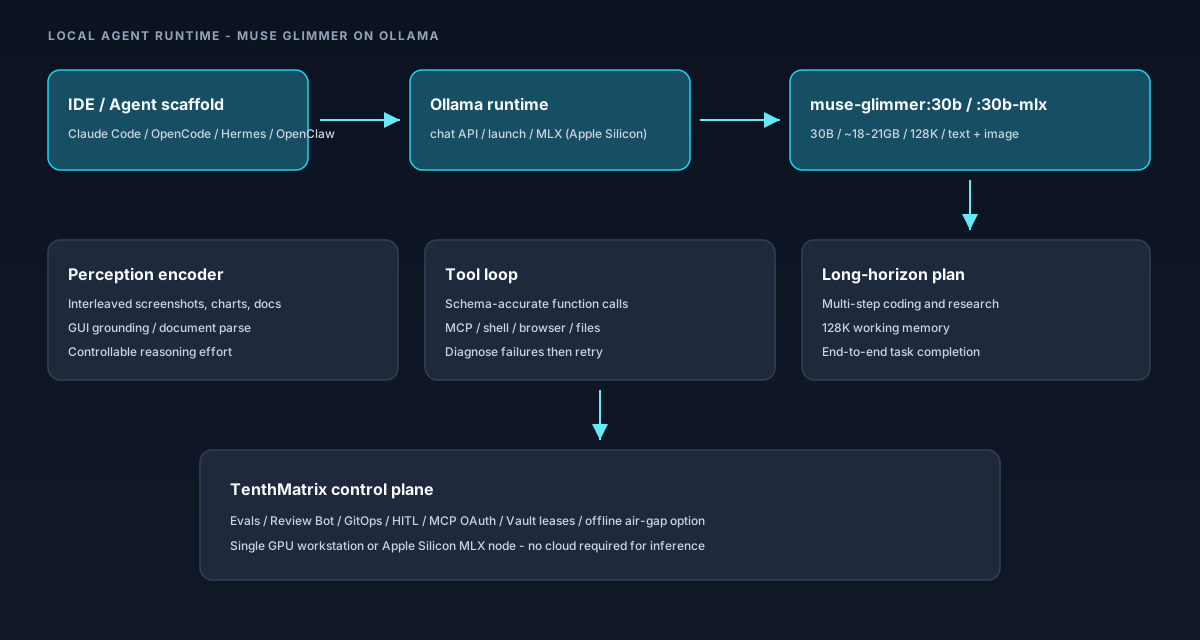
- Agentes locais sempre ativos:projetado para continuar trabalhando em trabalhos de várias etapas sem precisar enviar cada token para um hiperescalador.
- Disciplina da ferramenta: chamada de função com esquema precisoem fluxos de trabalho longos — a diferença entre um chatbot de demonstração e um agente que arquiva tickets, edita código ou consulta ferramentas MCP.
- Recuperação de falha:quando uma ferramenta falha ou retorna absurdo, o modelo diagnostica e tenta novamente em vez de congelar a execução.
- Multimodal: capturas de tela, gráficos e documentos doacompanham o texto – útil para consoles de operações, faturas e automação de UI.
- Esforço controlável: o raciocínio de discagemaumenta a força para tickets difíceis e diminui para caminhos sensíveis à latência.
- Licença:Apache 2.0 — uma história comercial mais limpa do que muitos cartões de “peso aberto” com recortes SaaS.
Por que placas e PMEs deveriam se preocupar com
- Residência de dados: PII do cliente, código-fonte e documentos financeiros podem permanecer na estação de trabalho ou VPC privado.
- Economia da unidade: o custo de inferência dotorna-se amortização de hardware + eletricidade, e não faturas por token que aumentam com loops de agente.
- Continuidade: locais de redeoff-line ou degradados (fábricas, clínicas, equipes de campo) mantêm os agentes em funcionamento.
- Clareza de aquisição: a distribuiçãoApache 2.0 + Ollama reduz o atrito legal e operacional em comparação com despejos de peso opacos.
Ondenãosubstitui a nuvem
Mantenha APIs fechados (ou MoEs abertos maiores em um cluster) para caminhos de pico crítico, geração sensível à marca e cargas de trabalho que precisam de SLAs de suporte do fornecedor. Muse Glimmer é o fortelocal / pista privadaem um roteador híbrido – não é uma obrigação para eliminar Bedrock ou Anthropic durante a noite. Combine-o com avaliações, HITL e os controles em nosso resumo de segurança do agente.
ConselhoTenthMatrix
- Lojas PME/Mac:começa com
ollama run muse-glimmer:30b-mlxem Apple Silicon (ou a etiqueta padrão de 18 GB em uma única estação de trabalho GPU média/alta). Equipes de desenvolvimento - : andaimes de fiocom
ollama launch claude --model muse-glimmer(ou OpenCode / Hermes / OpenClaw) e meça suas tarefas de ouro - não apenas a tabela de classificação do Meta. - Enterprises: Pods de agente piloto air-gappedcom Review Bot + GitOps; mantenha um failover na nuvem para estouro.
Reescrita técnica completa - arquitetura, tags Ollama, matriz de benchmark vs Gemma4-31B / Qwen3.6-27B, metodologia de avaliação Meta e uma lista de verificação de produção: artigo longo. Publicado porTenthMatrix.
Mais do blog

Observability Is Not Optional: Make It a Business Standard
Why fragmented monitoring creates blind spots, duplicate spend, and slow incidents — and how to make centralised observability a non-negotiable company standard.

WSL Vault for Compliance: One Tenant Never Opens Another’s Secrets
How WSL Vault keeps app, team, and environment tenants cryptographically isolated — so a stolen root-style token cannot empty the estate — and why dual-tenant control beats secrets sprawl.

Workstation AI Shop: Promoting the AI Sales Storefront Through int → test → acc → prod
Workstation AI Shop sells GPU machines with a fully autonomous AI Sales Agent that configures the basket. See how Ring Promoter moves each build through int → test → acc → prod — with Orbit screenshots release engineers and stakeholders share.