Blog
Atualizações Couchbase com portas de pausa CAO: uma visão geral de fácil suporte
Atualização contínua controlada usando portas de pausa nativas CAO, verificações de integridade e monitoramento com reconhecimento de XDCR
Nesta página
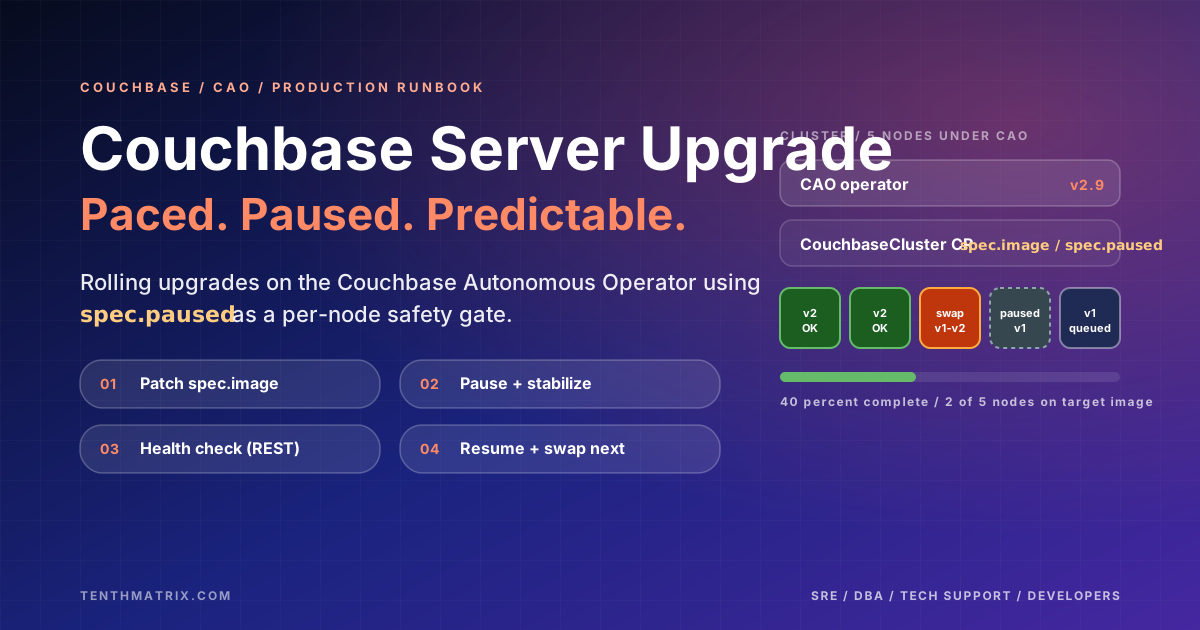
Se você suporta uma plataforma Couchbase (ou se você é a pessoa que recebe uma mensagem quando onão se comporta como o), as atualizações podem parecer uma escolha entre “sem intervenção e esperança” e “manual e arriscado”. Esta postagem captura um meio-termo pragmático: uma atualização contínua controlada porpara servidor Couchbase rodando sob o operador autônomoCouchbase (CAO), acompanhado pelo campospec.pausednativo do CAO.
Quem é este
- Suporte técnico/respondentes a incidentes:o que é “normal” durante o reequilíbrio de swap e o que tratar como uma bandeira vermelha.
- SRE / engenheiros de plataforma: procedimento repetívelcom verificações de pré-voo, portas de absorção e gatilhos de reversão.
- Engenheiros de banco de dados:reequilibra expectativas, comportamento XDCR e validação pós-atualização.
- Desenvolvedores:o que sua plataforma está fazendo durante a janela de manutenção (e sobre o que você deve alertar).
Topologia típica gerenciada por CAO (conceitual)
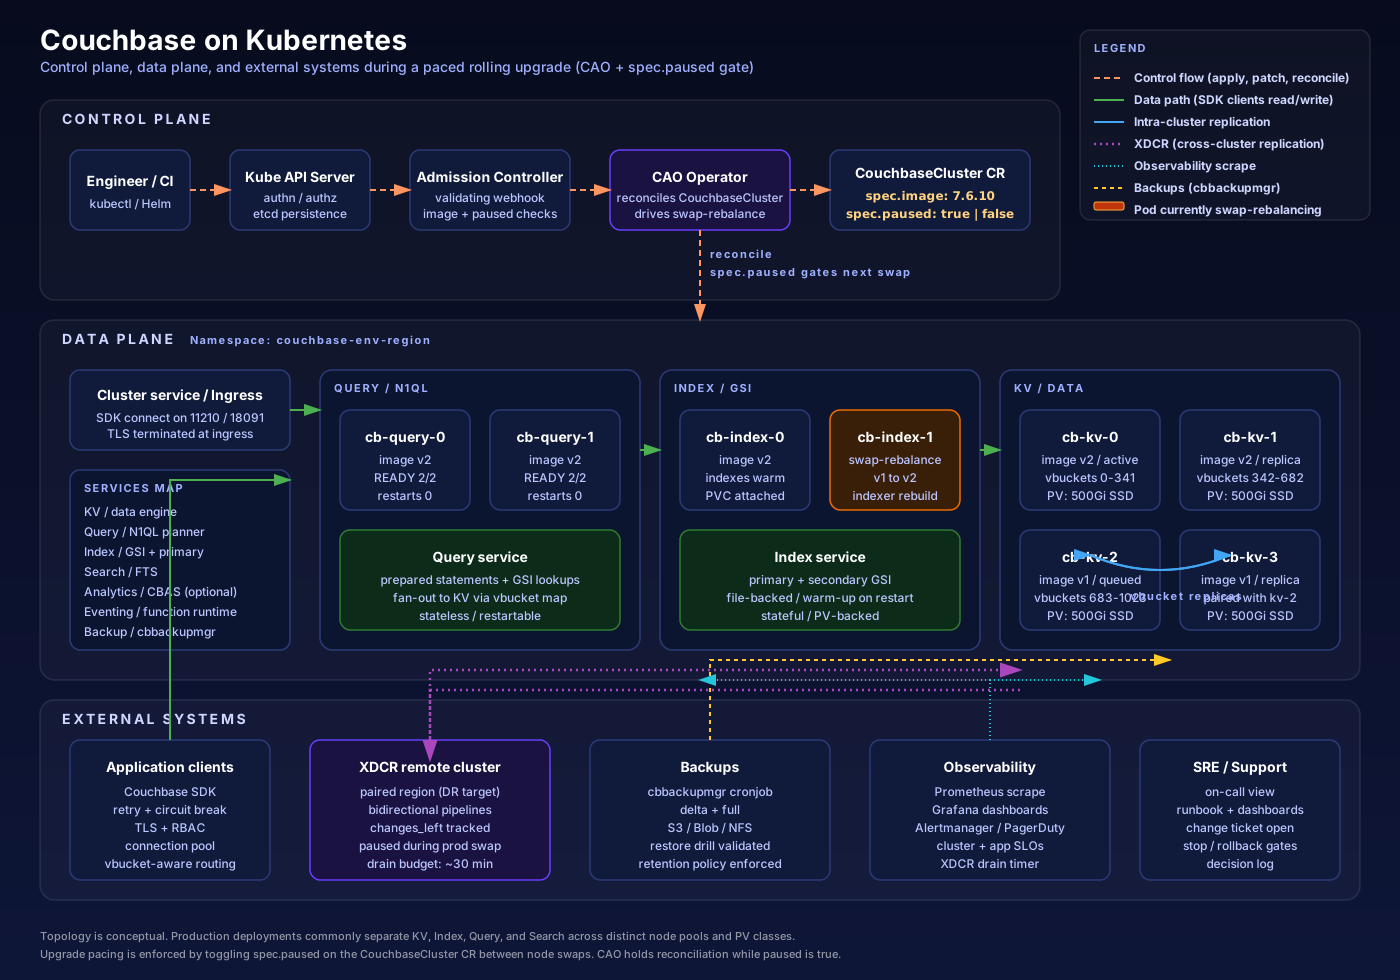
O diagrama abaixo é um mapa mental para o runbook: onde o operador está, o que o CRCouchbaseClustercontrola e quais sinais você deve correlacionar durante a atualização.
A grande ideia: acelerar o CAO com um portão de pausa
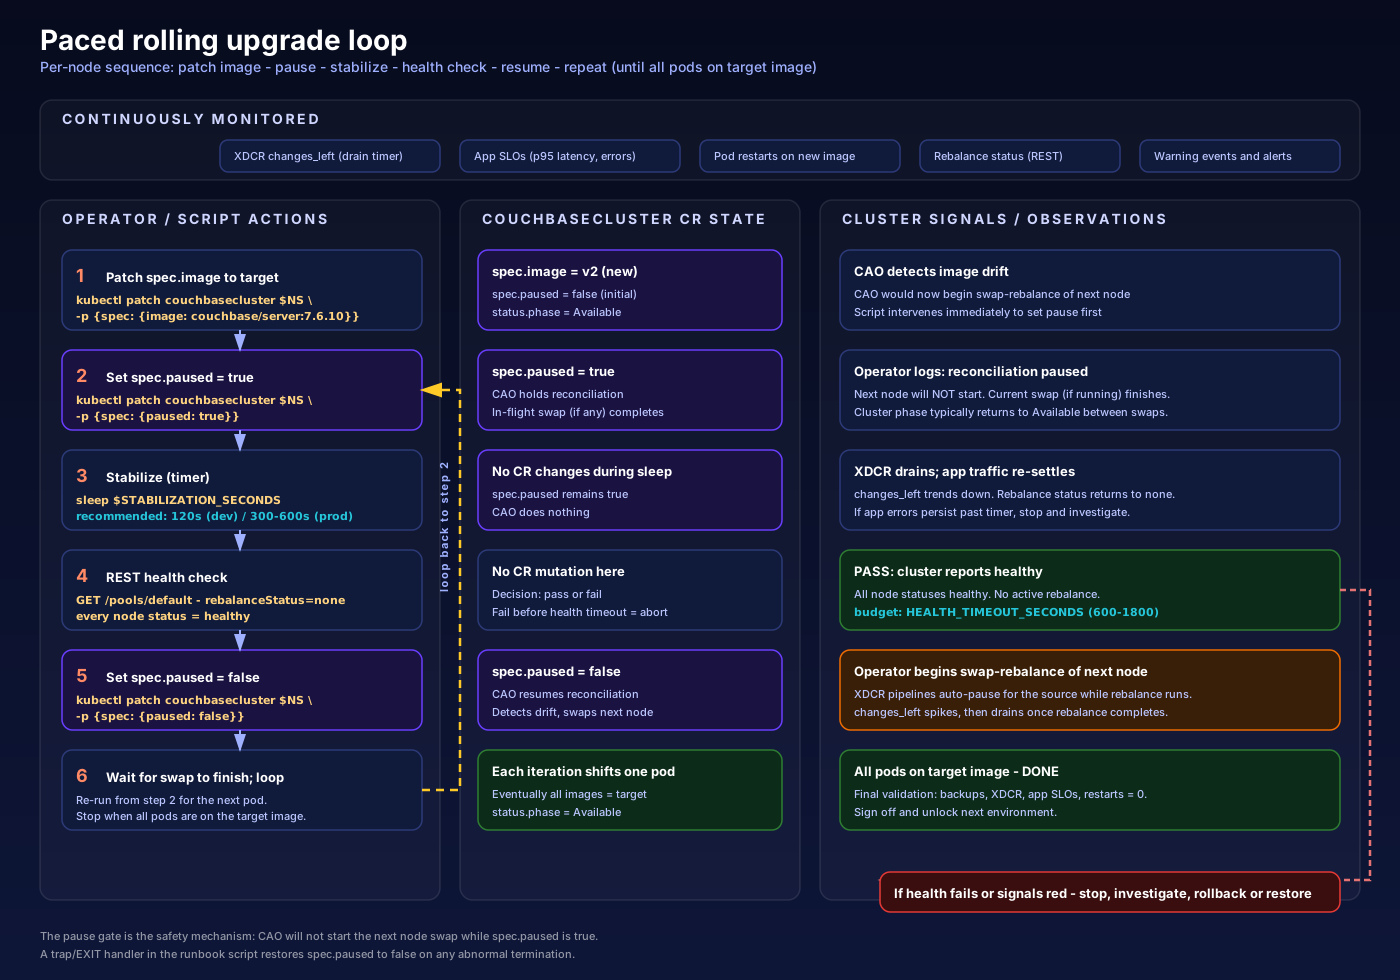
O CAO realiza uma atualização contínua via swap-rebalance. O runbook adiciona uma porta de segurança deliberada: pausar a reconciliação entre nós, estabilizar, verificar a integridade e depois retomar. Dessa forma, se o nó N se comportar mal após sua troca, você o capturaráantes que o nóN+1 seja iniciado.
Por que o portão de pausa vale a pena
- Menos surpresas:isola os sintomas em uma única alteração de nó.
- Sinais de limpeza:correlaciona latência, taxa de erro, estado de reequilíbrio e atraso XDCR para uma troca.
- Implementações mais seguras:interrompe a “correia transportadora” rapidamente segurando
spec.paused=trueenquanto você investiga.
Qual é a aparência “boa” durante a atualização
- Imagens do pod:antigo → novo progressivamente; idealmente, uma troca de cada vez.
- Fase de cluster:geralmente retorna para
Availableentre trocas; são esperadas breves transições durante o reequilíbrio. - XDCR (se habilitado):
changes_leftaumenta durante o rebalanceamento e depois drena durante a estabilização. - reinicia: novos podscomeçam em
RESTARTS=0. Qualquer aumento é um sinal para fazer uma pausa e investigar.
Verificações prévias que salvam você mais tarde
Antes de tocar em qualquer coisa, certifique-se de que o cluster esteja verde (sem rebalanceamento ativo, sem eventos de aviso), os backups sejamatuais erestauráveis e você tenha gravado a tag de imagem de reversão. Decida antecipadamente sua estratégia de XDCR: desative durante a atualização para obter um sinal mais silencioso na produção, continue executando em pré-produção para exercer um comportamento real ou use um terceiro cluster de espera para transições estratégicas.
Verificação da realidade da reversão
A verdade incômoda que os runbooks maduros dizem em voz alta: A reversão dosó é possível de forma limpa enquanto pelo menos um nó permanece na versão antiga. Depois que cada pod tiver sido trocado e o cluster totalmente rebalanceado, o “downgrade” pode se tornar “restauração do backup”. É por isso que o ritmo é importante: ele mantém a janela de reversão aberta por mais tempo.
Próximas etapas
- Leia o guia operacional completo:Couchbase Atualização contínua do servidor em CAO (ritmo + pausa)
- Informações relacionadas:Couchbase alta disponibilidade em produção (operador XDCR + Kubernetes)
Mais do blog

Observability Is Not Optional: Make It a Business Standard
Why fragmented monitoring creates blind spots, duplicate spend, and slow incidents — and how to make centralised observability a non-negotiable company standard.

WSL Vault for Compliance: One Tenant Never Opens Another’s Secrets
How WSL Vault keeps app, team, and environment tenants cryptographically isolated — so a stolen root-style token cannot empty the estate — and why dual-tenant control beats secrets sprawl.

Workstation AI Shop: Promoting the AI Sales Storefront Through int → test → acc → prod
Workstation AI Shop sells GPU machines with a fully autonomous AI Sales Agent that configures the basket. See how Ring Promoter moves each build through int → test → acc → prod — with Orbit screenshots release engineers and stakeholders share.