Blog
Deep learning-systemen: technisch brief voor engineers & agents
Representatieleren, discriminatieve vs generatieve paden, metrics en buy/build-routing — AWS-concepten herschreven voor productieteams
Op deze pagina
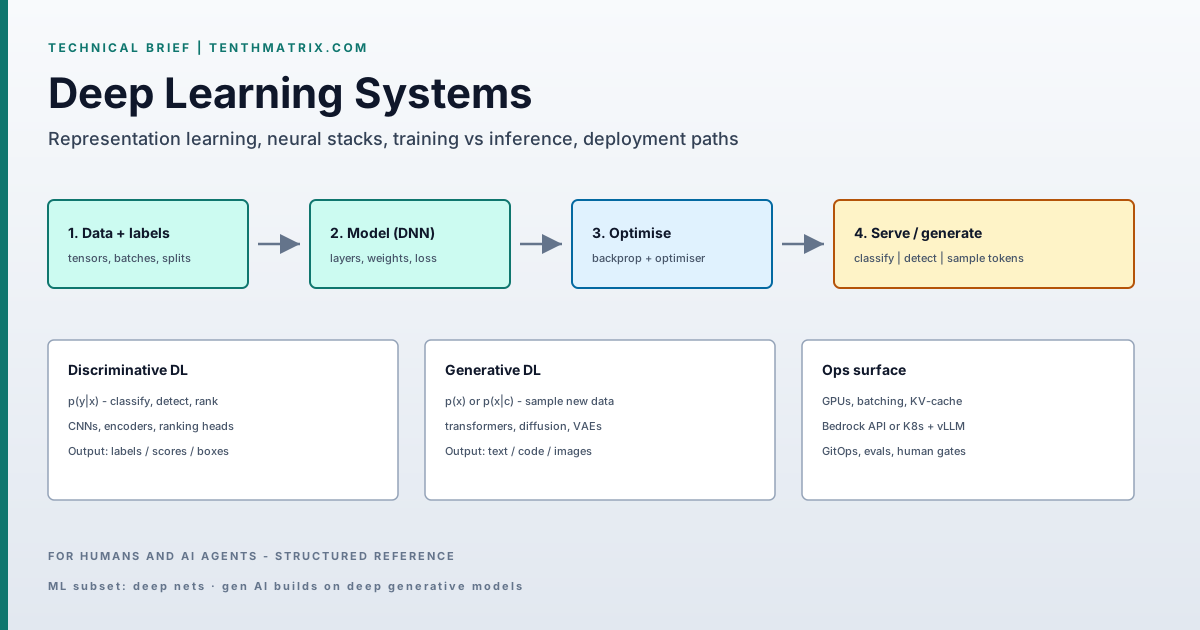
Technische digest: deep learning als meerlaagse neurale optimalisatie, discriminatieve vs generatieve paden, en hoe werk te routeren naar classic ML, getrainde DL of foundation-model-API’s. Volledige vergelijkingen, figuren en agent-checklist in het lange artikel.
Aangepast van AWS — What is Deep Learning? — voor TenthMatrix-engineeringteams.
Capability-splitsing
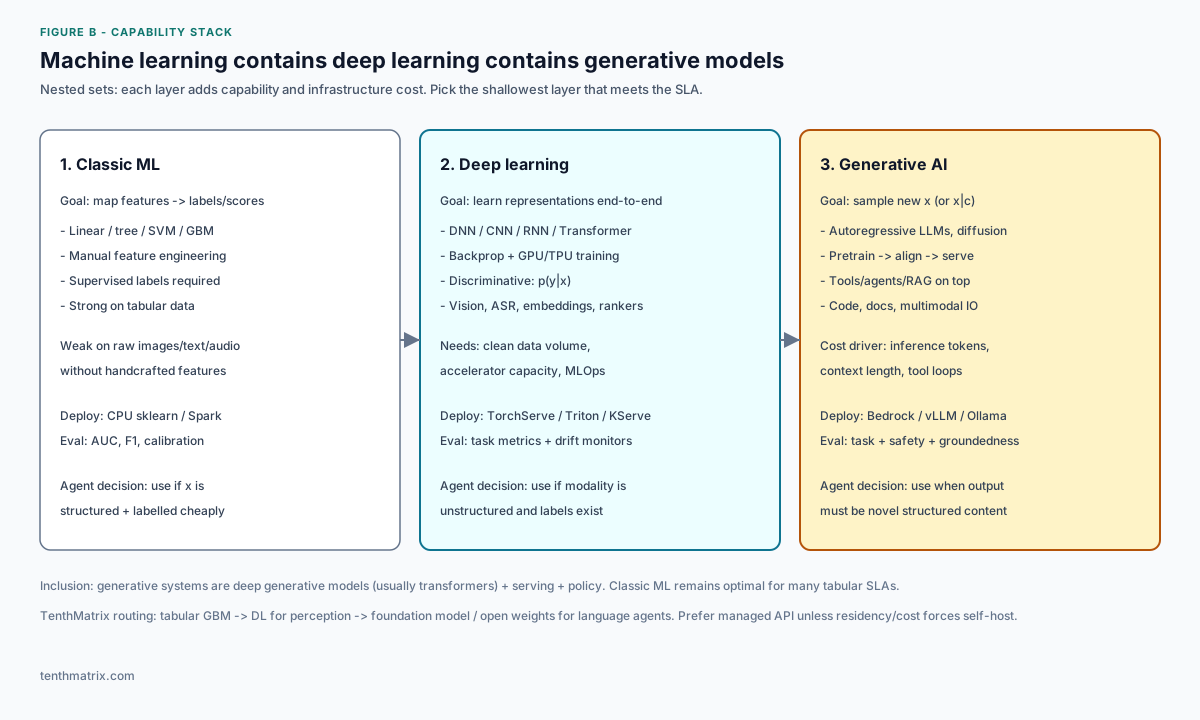
- Classic ML — engineered features; trees/lineaire modellen; beste default voor dichte tabulaire SLA’s.
- Deep learning — end-to-end nets op images/text/audio; backprop + GPU’s; serve via Triton/KServe/SageMaker.
- Generative AI — sample nieuwe content; LLM’s/diffusion + RAG/tools; Bedrock API of open-weight inference.
Taakfamilies (metrics doen ertoe)
| Familie | Typisch doel / metric |
|---|---|
| Vision | detecteren/classificeren — mAP, IoU, p99 latency |
| Speech | ASR/TTS — WER, real-time factor |
| NLP | classificeren / genereren — F1, exact-match, groundedness |
| Recommend | ranken — NDCG, CTR/CVR |
| Gen AI agents | taaksucces + safety + $/request |
Beperkingen
- Data — labelruis en shift domineren; version datasets.
- Compute — training en LLM-decode zijn accelerator-gebonden.
- Ops — eval harness, drift, cost, GitOps-rollback vóór brede promote.
Workstation-aanbeveling
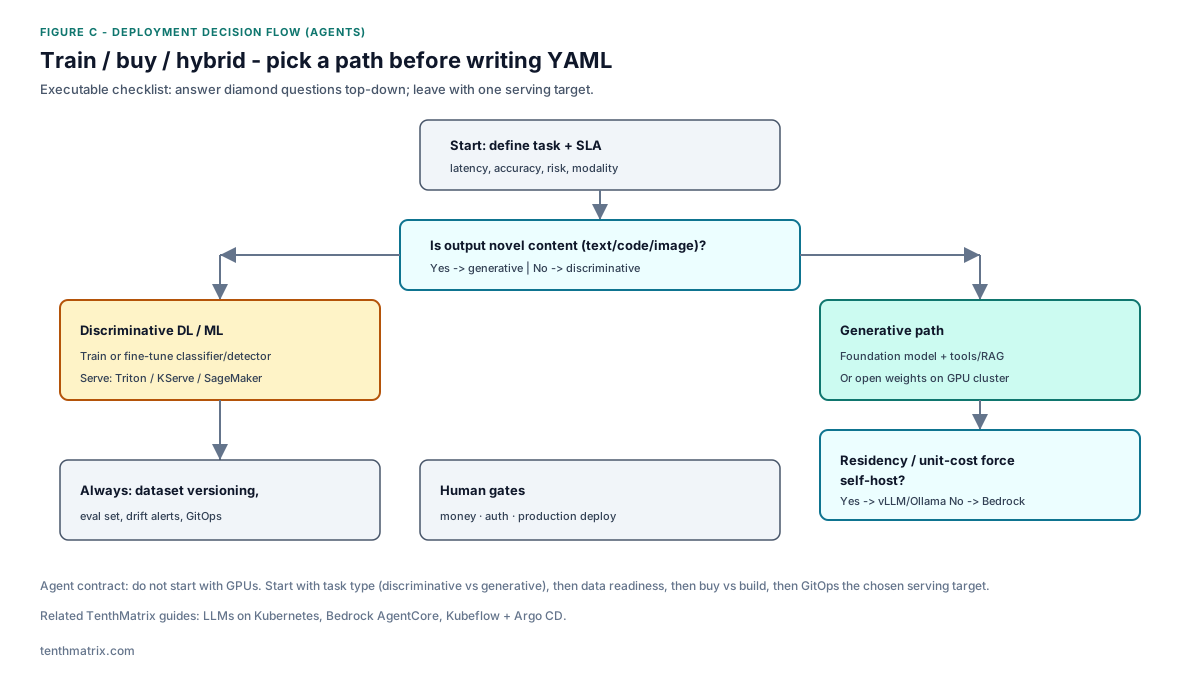
Classificeer eerst discriminatief vs generatief. Prefer managed foundation models voor taalagents tenzij residency/cost open weights afdwingt. Houd classic ML voor tabulaire data. Details, layer diagram en checklist: lange artikel. Gepubliceerd door TenthMatrix.
Meer van de blog

Observability Is Not Optional: Make It a Business Standard
Why fragmented monitoring creates blind spots, duplicate spend, and slow incidents — and how to make centralised observability a non-negotiable company standard.

WSL Vault for Compliance: One Tenant Never Opens Another’s Secrets
How WSL Vault keeps app, team, and environment tenants cryptographically isolated — so a stolen root-style token cannot empty the estate — and why dual-tenant control beats secrets sprawl.

Workstation AI Shop: Promoting the AI Sales Storefront Through int → test → acc → prod
Workstation AI Shop sells GPU machines with a fully autonomous AI Sales Agent that configures the basket. See how Ring Promoter moves each build through int → test → acc → prod — with Orbit screenshots release engineers and stakeholders share.