ब्लॉग
टर्बोचार्जिंग LLMs
PagedAttention, vLLM, Self-Debugging, PowerInfer, और EG-MLA - GPU KV कैश को बर्बाद किए बिना LLM एजेंटों को कैसे स्केल करें
इस पृष्ठ पर
TenthMatrix: PagedAttention, vLLM, Self-Debugging, PowerInfer, और EG-MLA - उन ट्रेड-ऑफ के साथ जो वास्तव में GPUs पर दिखाई देते हैं। गहरा गोता:लंबा लेख। प्राइमर:LLMs समझाया + Kubernetes।
घड़ी: LLM वास्तव में
क्या हैसंदर्भ, उत्पाद डेमो नहीं:बड़े भाषा मॉडलका परिचय (आंद्रेज कारपैथी)। हमारेसादे-अंग्रेज़ी LLM + Kubernetes गाइडके साथ युग्मित करें।
स्केलिंग समस्या
LLMs ने संवादात्मक AI और पीढ़ी को अनलॉक किया, फिर तुरंत एक सेवा समस्या बन गई। प्रत्येक डिकोड चरण केवी कैश में कुंजी और मान जोड़ता है जो अनुक्रम लंबाई और बैच आकार के साथ बढ़ता है। अनुभवहीन इंजन विशाल सन्निहित स्लैब को पूर्व-आरक्षित करते हैं। उस मेमोरी का अधिकांश भाग निष्क्रिय रहता है जबकि अन्य अनुरोध प्रतीक्षा करते हैं। भले ही GPU "पूर्ण" दिखता हो, थ्रूपुट ढह जाता है।
PagedAttention: ध्यान के लिए वर्चुअल मेमोरी
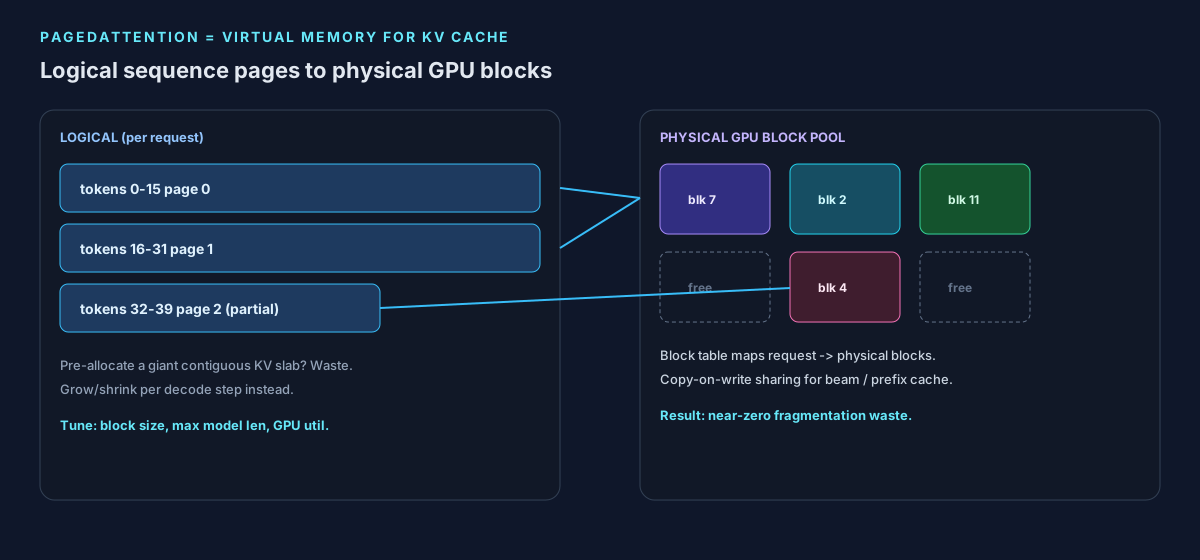
PagedAttention (क्वोन एट अल., SOSP 2023) KV कैश को OS पेजिंग की तरह मानता है: निश्चित आकार के ब्लॉक, प्रति अनुरोध एक ब्लॉक तालिका, गैर-सन्निहित भौतिक पेज[arXiv:2309.06180]। कर्नेल ध्यान के समय ब्लॉक इकट्ठा करता है। आपको अभी भीब्लॉक आकार,अधिकतम मॉडल लंबाई, औरकैश पदानुक्रम(GPU HBM बनाम CPU ऑफलोड बनाम प्रीफ़िक्स कैश) को ट्यून करना होगा। बहुत छोटे ब्लॉक मैपिंग ओवरहेड जोड़ते हैं; बहुत बड़े ब्लॉक अपशिष्ट को पुनः प्रस्तुत करते हैं।
vLLM:
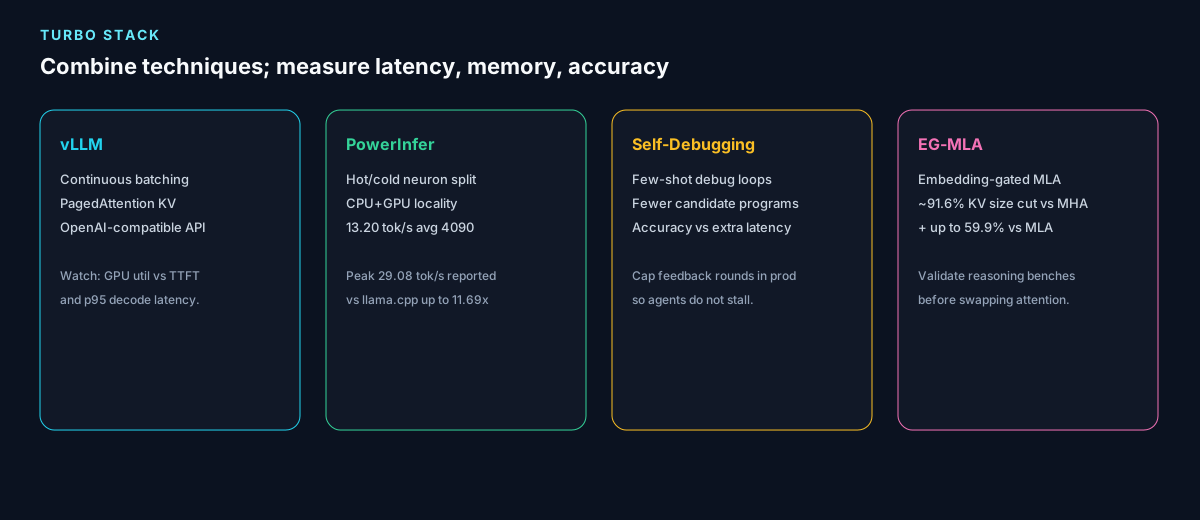
परोसने वाला लगभग शून्य अपशिष्टvLLM PagedAttention के आसपास निर्मित सेवा प्रणाली है। यह लगभग शून्य केवी अपशिष्ट, निरंतर बैचिंग और एक OpenAI-संगत HTTP सतह को लक्षित करता है। उत्पादन में, तीन चीज़ें देखें: (1)gpu_memory_utilizationबनाम OOM, (2) टाइम-टू-फर्स्ट-टोकन बनाम डिकोड टोकन/एस, (3) क्या प्रीफ़िक्स/प्रॉम्प्ट कैशिंग आपके eval सेट के लिए उत्तर बदलता है। कैशिंग एक थ्रूपुट जीत है; यह शुद्धता और टेल-विलंबता प्रभाव से मुक्त नहीं है।
from vllm import LLM, SamplingParams

llm = LLM(model="meta-llama/Llama-3.1-8B-Instruct", gpu_memory_utilization=0.90)
params = SamplingParams(temperature=0.2, max_tokens=256)
outs = llm.generate(["Explain PagedAttention in one paragraph."], params)
print(outs[0].outputs[0].text)
यह वास्तविक vLLM उपयोग है। हगिंग फेस BERTforward()कॉलहै न किPagedAttention - पेजेड केवी सर्विंग के साथ क्लासिफायर लॉगिट्स को भ्रमित न करें।
Self-Debugging: विलंबता बजट
के साथ गुणवत्ता लूपएजेंटों के लिए, वह सोना है - जब तक फीडबैक राउंड ढेर न हो जाए। डिबग संदेशों की संख्या कैप करें, प्रत्येक राउंड लॉग करें, और बजट समाप्त होने पर मानव या छोटे विशेषज्ञ मॉडल को बंद कर दें।
घड़ी: प्रस्तुतिकरण और अनुमान संदर्भ
तेज LLM सेवा पर प्रासंगिक बातचीत - आधिकारिक TenthMatrix डेमो नहीं। vLLM पेपर औरdocs.vllm.aiके साथ युग्मित करें।
PowerInfer: एकल वसा GPU
पर टोकनPowerInfer गर्म/ठंडे न्यूरॉन्स को विभाजित करता है ताकि उपभोक्ता GPU प्लस CPU जल्दी से टोकन उत्पन्न कर सके। रिपोर्ट किए गए आंकड़े:13.20 टोकन/सेकेंड औसत, एक NVIDIA RTX 4090 पर अधिकतम29.08 टोकन/सेकेंड, सटीकता बनाए रखते हुए11.69xबनाम llama.cpp तक,[PowerInfer]। बेड़े के पैमाने पर आपको अभी भी प्लेसमेंट की आवश्यकता है: कौन सी परतें GPU पर रहती हैं, आप नोड्स में कैसे शार्प करते हैं, और क्याका स्थानीय प्रोफ़ाइल आपकेप्रॉम्प्ट पेपर के मॉडल से मेल खाता है।
EG-MLA: बेंच को नुकसान पहुंचाए बिना KV को सिकोड़ें
EG-MLA (एम्बेडिंग-गेटेड मल्टी-हेड लेटेंट अटेंशन) रिपोर्ट91.6% से अधिक केवी कैश कटौतीबनाम मल्टी-हेड अटेंशन के साथ नगण्य गिरावट, अतिरिक्त बचत बनाम एमएलए (59.9% तक), और रीजनिंग सुइट्स पर बेहतर स्कोर, 1B पैरामीटर[EG-MLA पेपर]से आगे। इसे एक आर्किटेक्चर विकल्प के रूप में मानें, जमे हुए vLLM चेकपॉइंट पर ड्रॉप-इन फ़्लैग के रूप में नहीं - मेमोरी ग्राफ़ का जश्न मनाने से पहले अपने इवल हार्नेस को मान्य करें।
इसे
एक साथ रखनाक्लस्टर सर्विंग के लिए PagedAttention + vLLM को संयोजित करें, जब बॉक्स वर्कस्टेशन GPU हो तो PowerInfer, हार्ड राउंड लिमिट के साथ कोडिंग एजेंटों के अंदर Self-Debugging और जब आप मॉडल परिवार को नियंत्रित करते हैं तो EG-MLA को संयोजित करें। वितरित सेवा जटिलता जोड़ती है: केवी समानता, प्रीफ़िल/डीकोड विभाजन, और ऑटोस्केलिंग जो पृष्ठ तालिकाओं को ख़राब नहीं करती है। उपाय। फिर एडीआर लिखें.
अगला पढ़ें
- लंबा लेख- नॉब्स, विफलता मोड, Kubernetes नोट्स।
- LLMs समझाया गया + Kubernetes पर अपना खुद का चलाएं
- Muse Glimmer / स्थानीय एजेंट·एंटरप्राइज AI लैब
TenthMatrixद्वारा प्रकाशित।
ब्लॉग से और

Observability Is Not Optional: Make It a Business Standard
Why fragmented monitoring creates blind spots, duplicate spend, and slow incidents — and how to make centralised observability a non-negotiable company standard.

WSL Vault for Compliance: One Tenant Never Opens Another’s Secrets
How WSL Vault keeps app, team, and environment tenants cryptographically isolated — so a stolen root-style token cannot empty the estate — and why dual-tenant control beats secrets sprawl.

Workstation AI Shop: Promoting the AI Sales Storefront Through int → test → acc → prod
Workstation AI Shop sells GPU machines with a fully autonomous AI Sales Agent that configures the basket. See how Ring Promoter moves each build through int → test → acc → prod — with Orbit screenshots release engineers and stakeholders share.