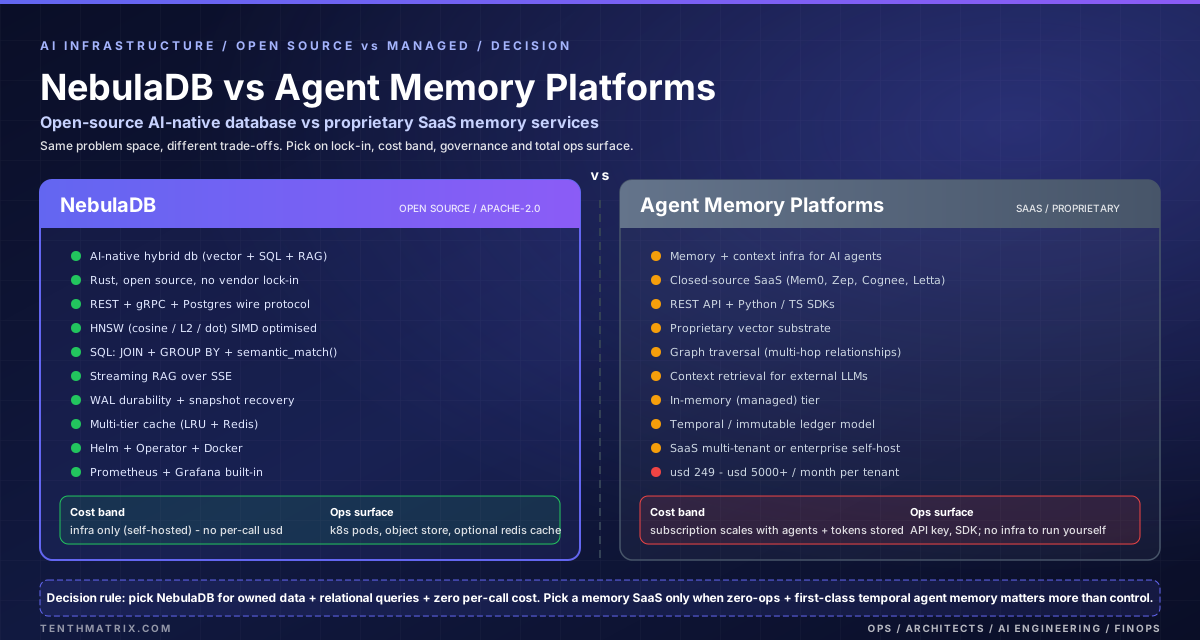
এআই অবকাঠামোর ল্যান্ডস্কেপ বিপজ্জনক গতিতে বিকশিত হচ্ছে। বুদ্ধিমান অ্যাপ্লিকেশন তৈরির প্রতিটি দল একটি মৌলিক প্রশ্নের সম্মুখীন হয়: কি ডাটাবেস আপনার AI স্ট্যাক underpins? উত্তরটি আপনার ক্যোয়ারী ক্ষমতা, আপনার স্থাপনার নমনীয়তা, আপনার খরচের কাঠামো এবং শেষ পর্যন্ত AI বৈশিষ্ট্যগুলিতে পুনরাবৃত্তি করার ক্ষমতা নির্ধারণ করে।
এই নিবন্ধটি মধ্যে একটি ব্যাপক তুলনা প্রদান করে নেবুলাডিবি — একটি ওপেন-সোর্স এআই-নেটিভ হাইব্রিড ডাটাবেস যা মরিচায় লেখা — এবং এর উদীয়মান বিভাগ এজেন্ট মেমরি প্ল্যাটফর্ম (মালিকানা SaaS পরিষেবাগুলি অবিরাম মেমরি, প্রসঙ্গ পুনরুদ্ধার এবং এআই এজেন্টদের জন্য অস্থায়ী অবস্থা প্রদান করে)। আমরা স্থাপত্য, বৈশিষ্ট্য, APIs, স্থাপনা, খরচ, এবং ব্যবহারের ক্ষেত্রে আপনাকে একটি জ্ঞাত সিদ্ধান্ত নিতে সাহায্য করার জন্য পরীক্ষা করি।
NebulaDB কি?
নেবুলাডিবি এটি একটি এআই-নেটিভ হাইব্রিড ডাটাবেস যা ডকুমেন্ট স্টোরেজ, ভেক্টর অনুসন্ধান, এআই এক্সটেনশনের সাথে এসকিউএল কোয়েরি এবং স্ট্রিমিং রিট্রিভাল-অগমেন্টেড জেনারেশন (RAG) - সবই একটি একক রাস্ট বাইনারিতে। অধীনে লাইসেন্স করা হয়েছে অ্যাপাচি-2.0, এটি ডকার ইমেজ, হেলম চার্ট এবং কাস্টম রিসোর্স সংজ্ঞা সহ একটি সম্পূর্ণ কুবারনেটস অপারেটর সহ একটি স্ব-হোস্টেড সমাধান হিসাবে প্রেরণ করে।
আর্কিটেকচার হাইলাইটস
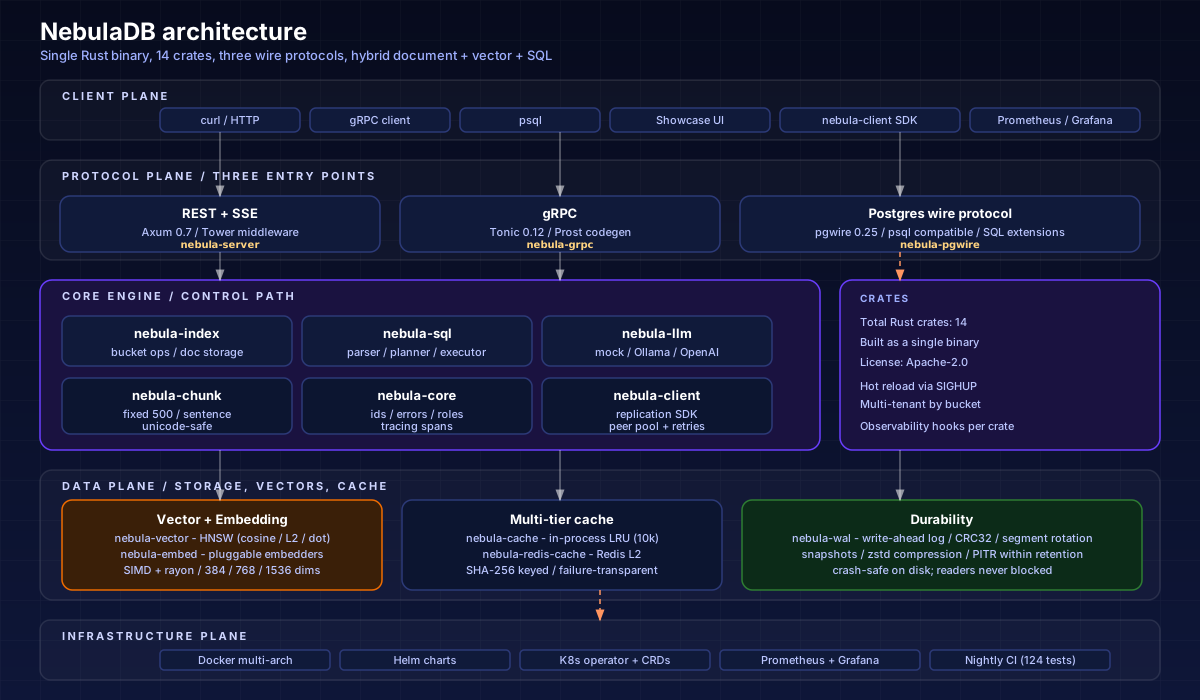
NebulaDB এর একটি ওয়ার্কস্পেস হিসাবে তৈরি করা হয়েছে 14 মরিচা ক্রেট, প্রতিটি একটি স্বতন্ত্র ক্ষমতার জন্য দায়ী:
- নীহারিকা-সার্ভার — প্রধান বাইনারি, অ্যাক্সাম রাউটার, টাওয়ার মিডলওয়্যার (প্রমাণ, রেট লিমিটিং, CORS, কম্প্রেশন)
- নীহারিকা-সূচক — বালতি-স্কোপড নথি এবং খণ্ড সঞ্চয়স্থান সহ কোর টেক্সটইন্ডেক্স
- নীহারিকা-ভেক্টর — কোসাইন, L2 বর্গক্ষেত্র, এবং ঋণাত্মক ডট-পণ্য দূরত্ব সহ HNSW গ্রাফ বাস্তবায়ন; x86-64 (AVX2) এবং aarch64 (NEON) এর জন্য SIMD-অপ্টিমাইজ করা হয়েছে
- nebula-sql — SQL পার্সার (sqlparser-rs), প্ল্যানার, এবং এক্সিকিউটর সহ
semantic_match()এবংvector_distance()ফাংশন - নেবুলা-জিআরপিসি — টনিক-ভিত্তিক জিআরপিসি পরিষেবা: নথি, অনুসন্ধান এবং এআই
- nebula-pgwire — পোস্টগ্রেস ওয়্যার প্রোটোকল হ্যান্ডলার (সহজ কোয়েরি প্রোটোকল, psql-সামঞ্জস্যপূর্ণ)
- নেবুলা-ওয়াল — CRC32 ইন্টিগ্রিটি চেক, সেগমেন্ট রোটেশন, স্ন্যাপশট সমর্থন, এবং zstd কম্প্রেশন সহ লিখুন-আগে লগ
- নেবুলা-এম্বেড — মক এবং OpenAI- সামঞ্জস্যপূর্ণ বাস্তবায়নের সাথে প্লাগযোগ্য এমবেডার বৈশিষ্ট্য
- নেবুলা-এলএলএম — মক, ওল্লামা এবং ওপেনএআই ব্যাকএন্ড সহ এলএলএম ক্লায়েন্টের বৈশিষ্ট্য
- নীহারিকা-খণ্ড — নথি খণ্ড করার কৌশল: নির্দিষ্ট আকার (500 অক্ষর, 50-অক্ষর ওভারল্যাপ) এবং বাক্য-ভিত্তিক
- নেবুলা-ক্যাশে — ইন-প্রসেস এলআরইউ এম্বেডিং ক্যাশে (10,000 এন্ট্রি ডিফল্ট)
- nebula-redis-cache — রেডিস-ব্যাকড L2 এম্বেডিং ক্যাশে (SHA-256 কীড, ব্যর্থতা-স্বচ্ছ)
- নেবুলা-কোর — ভাগ করা প্রকার: IDs, NebulaError, NodeRole enum
- নীহারিকা-ক্লায়েন্ট — ক্রস-অঞ্চল প্রতিলিপির জন্য SDK
তিনটি নেটওয়ার্ক প্রোটোকল
NebulaDB একটি একক প্রক্রিয়া থেকে একই সাথে তিনটি প্রোটোকল পরিবেশন করে:
- REST + SSE (Axum 0.7) — সম্পূর্ণ CRUD, শব্দার্থিক অনুসন্ধান, SQL কোয়েরি, সার্ভার-প্রেরিত ইভেন্টগুলির সাথে স্ট্রিমিং RAG, প্রমিথিউস মেট্রিক্স, অ্যাডমিন অপারেশন
- gRPC (টনিক 0.12) — স্ট্রিমিং RAG সহ নথি, অনুসন্ধান এবং এআই পরিষেবা
- পোস্টগ্রেস ওয়্যার প্রোটোকল (pgwire 0.25) — এআই এক্সটেনশন সহ সম্পূর্ণ এসকিউএল উপভাষা সমর্থনকারী সাধারণ ক্যোয়ারী প্রোটোকল; সাথে সংযোগ করুন
psql
এজেন্ট মেমরি প্ল্যাটফর্ম কি?
এজেন্ট মেমরি প্ল্যাটফর্ম একটি নতুন বিভাগ মালিকানাধীন SaaS পরিষেবা AI এজেন্টদের জন্য অবিরাম মেমরি এবং প্রসঙ্গ পরিকাঠামো প্রদানের জন্য ডিজাইন করা হয়েছে। তারা সাধারণত বৈশিষ্ট্য:
- অস্থায়ী জ্ঞান গ্রাফ — সংস্করণের ইতিহাস সহ অপরিবর্তনীয় লেজার-ভিত্তিক অবস্থা
- গ্রাফ ট্রাভার্সাল — মাল্টি-হপ রিলেশনশিপ কোয়েরি, সাদৃশ্য-শুধুমাত্র অনুসন্ধানের চেয়ে
- ভাগ করা প্রসঙ্গ স্তর — মাল্টি-এজেন্ট ফ্লিটগুলির জন্য সমন্বয় আদিম
- পরিকাঠামো পরিচালিত — এন্টারপ্রাইজ স্ব-হোস্ট বিকল্প সহ মাল্টি-টেন্যান্ট SaaS
- REST API এবং ভাষা SDKs — HTTP এবং Python/JS ক্লায়েন্টের মাধ্যমে প্রাথমিক অ্যাক্সেস
অ্যাক্সেস সাধারণত আমন্ত্রণ-ভিত্তিক বা গেটেড হয়, যার মূল্য থেকে শুরু করে $249/মাস থেকে $5,000+/মাস এন্টারপ্রাইজ স্তরের জন্য। অন্তর্নিহিত বাস্তবায়ন বন্ধ উৎস.
হেড টু হেড তুলনা
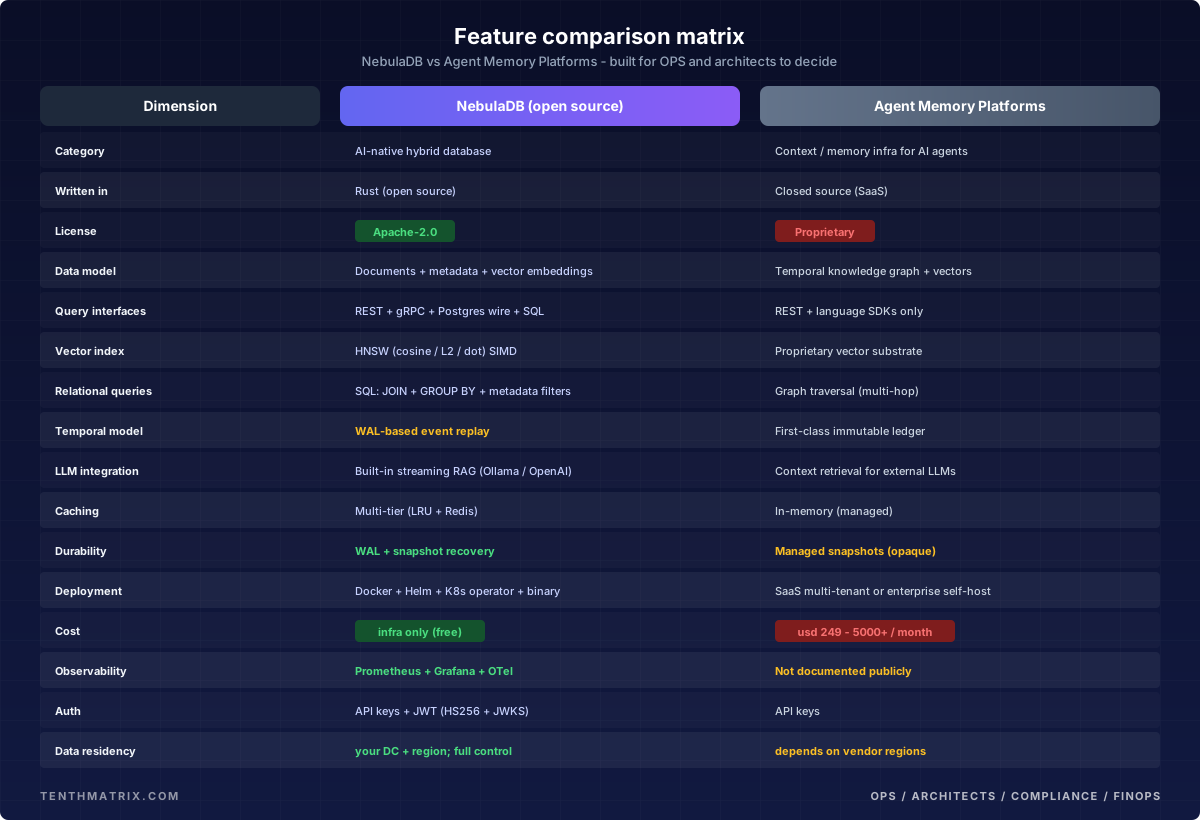
বিস্তারিত মাত্রা বিশ্লেষণ
ডেটা মডেল
নেবুলাডিবি সমৃদ্ধ মেটাডেটা (যথেচ্ছ JSON) প্লাস ভেক্টর এমবেডিং সহ বালতিতে নথি সংরক্ষণ করে। নথিগুলিকে সংরক্ষিত অর্ডার দিয়ে সার্ভার-সাইডে টুকরো টুকরো করা যেতে পারে। এই মডেলটি নলেজ বেস, ডকুমেন্ট কর্পোরা এবং আরএজি পাইপলাইনগুলিতে স্বাভাবিকভাবে ম্যাপ করে যেখানে আপনাকে একটি সিস্টেমে ইনজেস্ট, অনুসন্ধান এবং জেনারেট করতে হবে।
পরিচালিত প্ল্যাটফর্মগুলি সাধারণত একটি ব্যবহার করে অস্থায়ী জ্ঞান গ্রাফ একটি ভেক্টর সাবস্ট্রেট সহ — সময়ের সাথে এজেন্ট রাষ্ট্র কীভাবে বিবর্তিত হয় তা ট্র্যাক করার জন্য অপ্টিমাইজ করা হয়েছে। এই মডেলটি কথোপকথনকারী এজেন্টদের মধ্যে উৎকর্ষ সাধন করে যেগুলিকে মনে রাখতে হবে যে একজন ব্যবহারকারী গত মাসে কি পছন্দ করেছেন এখন আর।
ক্যোয়ারী ইন্টারফেস
NebulaDB এর চারটি ক্যোয়ারী ইন্টারফেস (REST, gRPC, Postgres wire, কাস্টম SQL) দলগুলিকে নমনীয়তা দেয় কোন পরিচালিত প্ল্যাটফর্মের মিল নেই। আপনার ডেটা ইঞ্জিনিয়াররা ব্যবহার করে psql অ্যাড-হক বিশ্লেষণের জন্য। কম লেটেন্সি অনুসন্ধানের জন্য আপনার মাইক্রোসার্ভিসগুলি জিআরপিসিকে কল করে৷ RAG স্ট্রিমিংয়ের জন্য আপনার ফ্রন্টএন্ড REST হিট করে। সব একই সূচকে আঘাত করেছে — একটি বাগ ফিক্স, একটি বৈশিষ্ট্য যোগ সর্বত্র পৃষ্ঠ।
পরিচালিত প্ল্যাটফর্মগুলি REST API এবং ভাষা SDK অফার করে — সাধারণ পুনরুদ্ধারের জন্য পর্যাপ্ত, কিন্তু কোনও SQL বিশ্লেষণ নেই, পোস্টগ্রেস সামঞ্জস্য নেই, এবং কোনও জিআরপিসি নেই৷
ভেক্টর সূচক
NebulaDB প্রয়োগ করে HNSW (হায়ারার্কিক্যাল নেভিগেবল স্মল ওয়ার্ল্ডস) তিনটি দূরত্বের মেট্রিক্স (কোসাইন, L2 স্কয়ার, নেগেটিভ ডট-প্রোডাক্ট), SIMD-বন্ধুত্বপূর্ণ অটো-ভেক্টরাইজেশন, রেয়ন-ভিত্তিক সমান্তরালতা, এবং গ্রাফ সংযোগ রক্ষা করে এমন নরম মুছে ফেলার সাথে স্ক্র্যাচ থেকে। আপনি সূচকটি পরিদর্শন এবং টিউন করতে পারেন কারণ এটি ওপেন সোর্স।
পরিচালিত প্ল্যাটফর্মগুলি মালিকানাধীন ভেক্টর সাবস্ট্রেট ব্যবহার করে — আপনি আপনার উত্পাদন সিস্টেমকে সমর্থনকারী পুনরুদ্ধার অ্যালগরিদম পরিদর্শন, সুর বা বুঝতে পারবেন না।
AI এক্সটেনশন সহ SQL
এটি একটি NebulaDB ডিফারেনশিয়াটর যার সাথে পরিচালিত প্ল্যাটফর্মে কোন সমতুল্য নেই। এসকিউএল ইঞ্জিন সমর্থন করে:
-- Semantic search with metadata filtering
SELECT * FROM knowledge_base
WHERE semantic_match(content, 'Kubernetes deployment patterns')
  AND region = 'eu-west-1'
ORDER BY score DESC
LIMIT 10;

-- Analytics over vector corpus
SELECT department, COUNT(*), AVG(score)
FROM documents
WHERE semantic_match(content, 'quarterly revenue')
GROUP BY department;

-- Cross-bucket JOIN with semantic retrieval
SELECT a.title, b.summary
FROM articles a
INNER JOIN summaries b ON a.doc_id = b.ref_id
WHERE semantic_match(a.content, 'machine learning ops');
পরিচালিত প্ল্যাটফর্মগুলি গ্রাফ ট্রাভার্সাল কোয়েরি অফার করে — সম্পর্ক-সচেতন পুনরুদ্ধারের জন্য শক্তিশালী, কিন্তু আপনি GROUP BY সমষ্টি, যোগদান, বা কাঠামোগত SQL বিশ্লেষণের সাথে শব্দার্থিক অনুসন্ধান একত্রিত করতে পারবেন না।
এলএলএম ইন্টিগ্রেশন এবং আরএজি
NebulaDB আছে অন্তর্নির্মিত স্ট্রিমিং RAG মাধ্যমে /api/v1/ai/rag শেষ বিন্দু কখন stream=true, এটি সার্ভার-প্রেরিত ইভেন্টগুলি প্রদান করে:
contextইভেন্টগুলি — স্কোর সহ পুনরুদ্ধার করা অংশ, এলএলএম তৈরি করা শুরু করার আগে বিতরণ করা হয়answer_deltaইভেন্টগুলি — এলএলএম থেকে স্ট্রিমিং টোকেন (ওলামা বা ওপেনএআই-সামঞ্জস্যপূর্ণ)doneঘটনা — খণ্ড গণনা এবং মডেল তথ্য সহ সমাপ্তি চিহ্নিতকারী
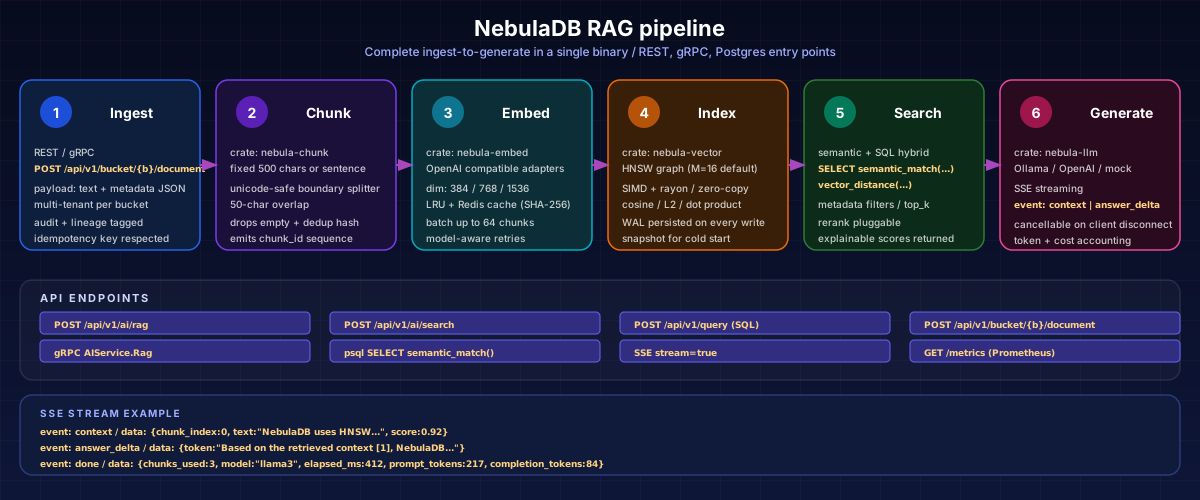
পরিচালিত প্ল্যাটফর্মগুলি প্রদান করে প্রসঙ্গ পুনরুদ্ধার — তারা প্রাসঙ্গিক অংশ ফেরত দেয়, কিন্তু আপনাকে অবশ্যই একটি বহিরাগত LLM কল করতে হবে। পাইপলাইনটি দুটি পরিষেবা জুড়ে বিভক্ত, লেটেন্সি এবং অপারেশনাল জটিলতা যোগ করে।
ক্যাশিং
NebulaDB এর মাল্টি-টায়ার এমবেডিং ক্যাশে একটি উল্লেখযোগ্য কর্মক্ষমতা সুবিধা:
- L1: প্রক্রিয়াধীন LRU — ডিফল্টরূপে 10,000 এন্ট্রি, শূন্য-কপি পুনরুদ্ধার
- L2: রেডিস — SHA-256 কীড এন্ট্রি সহ ঐচ্ছিক বিতরণকৃত ক্যাশে; ব্যর্থতা-স্বচ্ছ (রেডিস নিচে থাকলে করুণাময় অবনতি)
- এসকিউএল ফলাফল ক্যাশে — 30-সেকেন্ডের TTL সহ 512 এন্ট্রি, ডুপ্লিকেট শব্দার্থিক পুনরুদ্ধার দূর করে
ক্যাশে কী ব্যবহার করুন SHA-256(model || 0x00 || text) ক্রস-মডেল সংঘর্ষ প্রতিরোধ করতে। ব্যাচিং লেয়ার পার্টিশন ক্যাশে একটি একক পাসে মিস থেকে হিট করে, আপস্ট্রিম এম্বেডিং API কলগুলিকে মিনিমাইজ করে।
পরিচালিত প্ল্যাটফর্মগুলি অভ্যন্তরীণভাবে ক্যাশিং পরিচালনা করে — আপনার ক্যাশে হিট রেটগুলিতে কোনও দৃশ্যমানতা নেই, ক্যাশের আকার টিউন করার ক্ষমতা নেই এবং উচ্ছেদ নীতিগুলির উপর কোনও নিয়ন্ত্রণ নেই৷
স্থায়িত্ব
NebulaDB এর লিখুন-আগে লগ (WAL) ক্র্যাশ-নিরাপদ স্থায়িত্ব প্রদান করে:
- বিনকোড এনকোডিং সহ রেকর্ড প্রতি 8-বাইট হেডার (দৈর্ঘ্য + CRC32)
- ফাইলগুলি কনফিগার করা আকার অতিক্রম করলে সেগমেন্ট রোটেশন
- সঞ্চিত ভেক্টর সমাধান করা হয়েছে — পুনরুদ্ধারের জন্য এমবেডারকে অনলাইনে থাকতে হবে না
- zstd কম্প্রেশন সহ পয়েন্ট-ইন-টাইম পুনরুদ্ধারের জন্য স্ন্যাপশট সমর্থন
- WAL কমপ্যাকশন স্ন্যাপশট থেকে পুনর্নির্মাণ করে ডিস্ক পুনরুদ্ধার করে
লিডার/ফলোয়ার রেপ্লিকেশন টপোলজি ক্রস-নোড সিঙ্ক্রোনাইজেশনের জন্য জিআরপিসি ওয়াল সাবস্ক্রিপশন ব্যবহার করে, তিনটি প্রোটোকল স্তরে ফলোয়ার রাইট গার্ড প্রয়োগ করে (REST: 409, gRPC: FAILED_PRECONDITION, pgwire: SQLSTATE 25006)।
স্থাপনা এবং অপারেশন
NebulaDB সর্বাধিক স্থাপনার নমনীয়তা প্রদান করে:
- একক বাইনারি - ডাউনলোড করুন এবং চালান
- ডকার — ডকার হাবে মাল্টি-আর্ক ইমেজ (linux/amd64 + linux/arm64), নন-রুট ব্যবহারকারী (UID 10001)
- ডকার রচনা — ওল্লামা, রেডিস, প্রমিথিউস, গ্রাফানার সাথে সম্পূর্ণ স্ট্যাক
- হেলম চার্ট — সার্ভার, শোকেস UI, ঐচ্ছিক রেডিস সাবচার্ট, প্রমিথিউস অপারেটরের জন্য সার্ভিস মনিটর
- কুবারনেটস অপারেটর - সিআরডি:
NebulaCluster,NebulaBucket,NebulaRebalance; ভর্তি webhooks; আপগ্রেড করার আগে স্বয়ংক্রিয় স্ন্যাপশট এবং WAL কমপ্যাকশন
পরিচালিত প্ল্যাটফর্মগুলি হল SaaS (মাল্টি-টেন্যান্ট) একটি আপসেল স্তর হিসাবে এন্টারপ্রাইজ স্ব-হোস্ট সহ। আপনি অপারেশনাল সুবিধার জন্য স্থাপনার নমনীয়তা ট্রেড করেন।
পর্যবেক্ষণযোগ্যতা
নেবুলাডিবি অন্তর্ভুক্ত উত্পাদন-গ্রেড পর্যবেক্ষণযোগ্যতা বাক্সের বাইরে:
- প্রমিথিউস-সামঞ্জস্যপূর্ণ
/metricsশেষ বিন্দু - ডকার কম্পোজ স্ট্যাকে প্রাক-নির্মিত গ্রাফানা ড্যাশবোর্ড
- ট্রেসিং ইন্টিগ্রেশন (ট্রেসিং ক্রেটের মাধ্যমে স্প্যান-ভিত্তিক)
- SSE লগ স্ট্রীম এ
/admin/logs/streamকনফিগারযোগ্য স্তর সহ - এ স্বাস্থ্য পরীক্ষা
/healthzসূচক পরিসংখ্যান সহ
পরিচালিত প্ল্যাটফর্মগুলি তাদের পর্যবেক্ষণের বৈশিষ্ট্যগুলি সর্বজনীনভাবে নথিভুক্ত করে না। আপনি ক্যাশে পারফরম্যান্স, কোয়েরি লেটেন্সি ডিস্ট্রিবিউশন এবং সূচক স্বাস্থ্যের উপর অন্ধ হয়ে যাচ্ছেন।
খরচ
NebulaDB হল বিনামূল্যে. Apache-2.0 লাইসেন্সপ্রাপ্ত, স্ব-হোস্টেড, কোন ব্যবহার-ভিত্তিক মূল্য, কোন আসন সীমা, কোন বৈশিষ্ট্য গেট নেই। আপনার একমাত্র খরচ হল পরিকাঠামো যা আপনি চালান।
পরিচালিত প্ল্যাটফর্ম শুরু হয় $249/মাস এবং স্কেল $5,000+/মাস. একটি AI পণ্যে একটি স্টার্টআপ পুনরাবৃত্তির জন্য, যেটি হল $3,000-$60,000/বছর আপনি অ্যাপ্লিকেশন কোডের একটি লাইন লেখার আগে৷
API এবং বিকাশকারীর অভিজ্ঞতা
ডকুমেন্ট ইনজেশন (অটো-চঙ্কিং সহ)
curl -X POST http://localhost:8080/api/v1/bucket/knowledge/document \
  -H "Authorization: Bearer $NEBULA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "doc_id": "arch-guide-001",
    "text": "NebulaDB uses HNSW for approximate nearest neighbor search...",
    "metadata": {"department": "engineering", "region": "eu-west-1"}
  }'
শব্দার্থিক অনুসন্ধান
curl -X POST http://localhost:8080/api/v1/ai/search \
  -H "Authorization: Bearer $NEBULA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "query": "How does NebulaDB handle vector indexing?",
    "bucket": "knowledge",
    "top_k": 5
  }'
স্ট্রিমিং RAG
curl -N http://localhost:8080/api/v1/ai/rag \
  -H "Authorization: Bearer $NEBULA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "query": "Explain the NebulaDB caching architecture",
    "bucket": "knowledge",
    "top_k": 3,
    "stream": true
  }'
AI এক্সটেনশন সহ SQL (psql এর মাধ্যমে)
psql -h localhost -p 5433

SELECT title, score FROM articles
WHERE semantic_match(content, 'Kubernetes deployment patterns')
  AND region = 'eu-west-1'
ORDER BY score DESC
LIMIT 10;
কেস ম্যাপিং ব্যবহার করুন
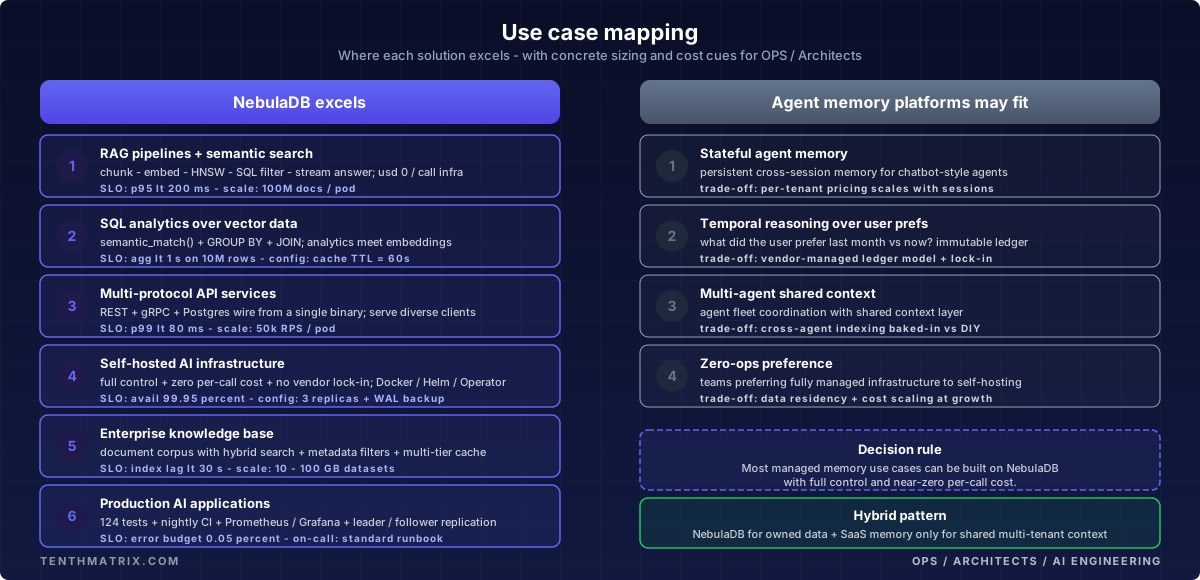
NebulaDB Excels এর জন্য
- RAG পাইপলাইন এবং শব্দার্থিক অনুসন্ধান — একটি একক বাইনারিতে সম্পূর্ণ ইনজেস্ট-টু-জেনারেট পাইপলাইন আলাদা এমবেডিং, ইনডেক্সিং এবং জেনারেশন পরিষেবাগুলিকে একসাথে সেলাই করার প্রয়োজনীয়তা দূর করে।
- ভেক্টর ডেটার উপর SQL বিশ্লেষণ - অন্য কোন সমাধান আপনাকে দৌড়াতে দেয় না
GROUP BY departmentশব্দার্থকভাবে পুনরুদ্ধার করা নথিতে। এটি শুধুমাত্র পুনরুদ্ধার প্ল্যাটফর্মের সাথে অসম্ভব যেগুলি ব্যবহার করার ক্ষেত্রে বিশ্লেষণগুলি আনলক করে৷ - মাল্টি-প্রটোকল API পরিষেবা — বিভিন্ন ক্লায়েন্ট প্রয়োজনীয়তা সহ দলগুলি (ওয়েব ফ্রন্টএন্ড, মাইক্রোসার্ভিস, ডেটা ইঞ্জিনিয়ার) একই সূচকের বিপরীতে REST, gRPC এবং Postgres ওয়্যার প্রোটোকল ব্যবহার করতে পারে।
- স্ব-হোস্টেড এআই পরিকাঠামো — ডেটা রেসিডেন্সি, নিরাপত্তা নীতি এবং স্কেলিং এর উপর সম্পূর্ণ নিয়ন্ত্রণ। Apache-2.0 লাইসেন্সিং সহ জিরো ভেন্ডর লক-ইন।
- জ্ঞানের ভিত্তি এবং নথি অনুসন্ধান — এন্টারপ্রাইজ ডকুমেন্ট কর্পোরা হাইব্রিড সার্চ সহ শব্দার্থগত মিল এবং মেটাডেটা ফিল্টার।
- উত্পাদন এআই অ্যাপ্লিকেশন — 124টি পরীক্ষা, রাত্রিকালীন CI, মাল্টি-আর্ক ডকার ইমেজ, হেলম চার্ট, একজন কুবারনেটস অপারেটর এবং প্রমিথিউস/গ্রাফানা পর্যবেক্ষণযোগ্যতা সহ, নেবুলাডিবি উৎপাদনের জন্য প্রস্তুত।
পরিচালিত প্ল্যাটফর্মের জন্য উপযুক্ত হতে পারে
- স্টেটফুল এজেন্ট মেমরি — চ্যাটবট-স্টাইল এআই এজেন্টদের জন্য ক্রসসেন্ট ক্রস-সেশন মেমরি যেখানে টেম্পোরাল স্টেট প্রাথমিক প্রয়োজন।
- টেম্পোরাল রিজনিং — কখন "ব্যবহারকারী গত মাসে কি পছন্দ করেছে?" একটি মূল ক্যোয়ারী প্যাটার্ন এবং একটি অপরিবর্তনীয় লেজার অ-আলোচনাযোগ্য।
- মাল্টি-এজেন্ট শেয়ার করা প্রসঙ্গ — বিল্ট-ইন শেয়ার্ড কনটেক্সট লেয়ারের সাথে এজেন্ট ফ্লিট সমন্বয়।
- জিরো-অপস দল — যে দলগুলি সম্পূর্ণরূপে পরিচালিত পরিকাঠামো পছন্দ করে এবং খরচ এবং ভেন্ডর লক-ইন ট্রেড-অফ গ্রহণ করতে ইচ্ছুক।
এটি লক্ষণীয় যে অনেকগুলি পরিচালিত প্ল্যাটফর্ম ব্যবহারের ক্ষেত্রেও NebulaDB-তে তৈরি করা যেতে পারে — WAL-ভিত্তিক ইভেন্ট রিপ্লে সাময়িক ক্ষমতা প্রদান করে এবং এক্সটেনসিবল আর্কিটেকচার কাস্টম এজেন্ট মেমরি স্তরগুলিকে সমর্থন করে।
ডিসিশন ফ্রেমওয়ার্ক
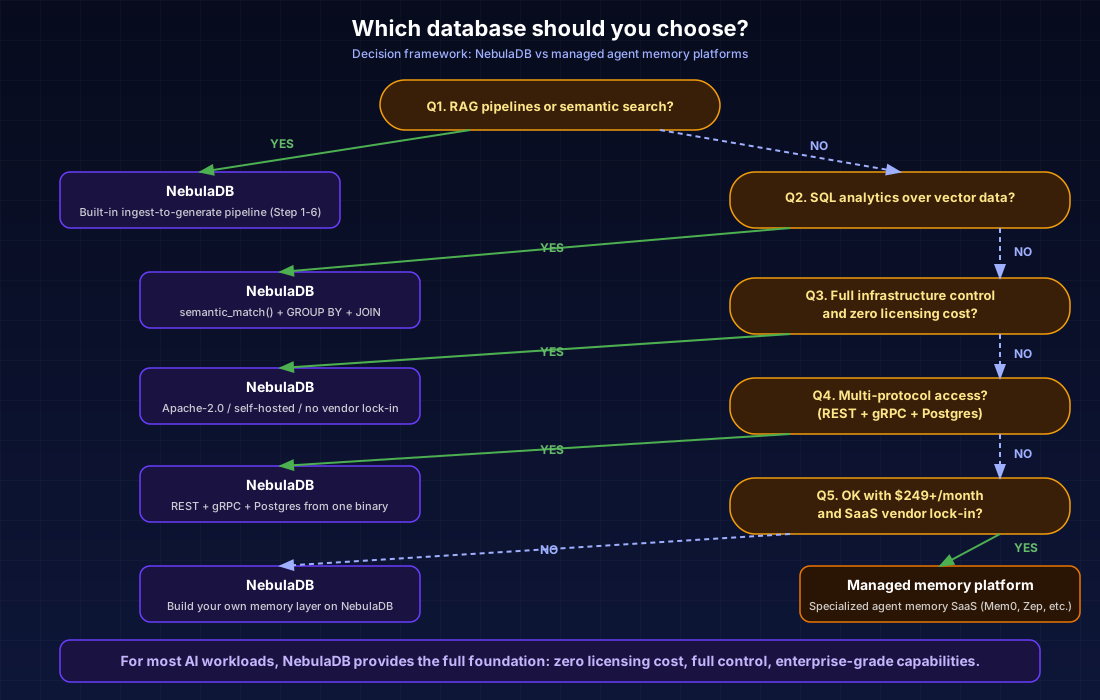
পরিপক্কতা এবং উত্পাদন প্রস্তুতি
NebulaDB শক্তিশালী প্রকৌশল অনুশীলন প্রদর্শন করে:
- 124 ইউনিট পরীক্ষা ক্লিপি-ক্লিন রাস্ট স্টেবল সহ ওয়ার্কস্পেস জুড়ে
- ইন্টিগ্রেশন টেস্ট স্যুট REST CRUD, RAG স্ট্রিমিং, pgwire SQL, Prometheus মেট্রিক্স এবং লোড টেস্টিং (60 সমবর্তী অনুরোধ, p95 <750ms) কভার করছে
- রাত্রিকালীন সি.আই কনফিগারযোগ্য ওল্লামা মডেলের সাথে 02:00 UTC-এ
- মাল্টি-আর্ক ডকার তৈরি করে প্রধান পুশ এবং সেমভার ট্যাগগুলিতে
- সম্পত্তি ভিত্তিক পরীক্ষা মানদণ্ডের মাধ্যমে প্রপ্টেস্ট এবং বেঞ্চমার্কের মাধ্যমে
পরিচালিত প্ল্যাটফর্মগুলি সাধারণত আমন্ত্রণ-ভিত্তিক অ্যাক্সেস, সীমিত পাবলিক ডকুমেন্টেশন এবং কোনও পর্যবেক্ষণযোগ্য CI বা পরীক্ষার অনুশীলন সহ প্রাথমিক পর্যায়ের SaaS হয়।
উপসংহার
AI ওয়ার্কলোডের বিশাল সংখ্যার জন্য — RAG পাইপলাইন, শব্দার্থিক অনুসন্ধান, নথি পুনরুদ্ধার, এম্বেডিংয়ের উপর SQL বিশ্লেষণ, জ্ঞানের ভিত্তি — NebulaDB সম্পূর্ণ অবকাঠামো নিয়ন্ত্রণ সহ শূন্য খরচে এন্টারপ্রাইজ-গ্রেড ক্ষমতা প্রদান করে. এর রাস্ট ফাউন্ডেশন স্মৃতির নিরাপত্তা এবং কর্মক্ষমতা নিশ্চিত করে। থ্রি-প্রটোকল আর্কিটেকচার মানে আপনার পুরো প্রতিষ্ঠান তাদের পছন্দের ইন্টারফেসের মাধ্যমে একই ডেটা অ্যাক্সেস করতে পারে। এবং কুবারনেটস অপারেটর, ওয়াল স্থায়িত্ব এবং প্রমিথিউস পর্যবেক্ষণযোগ্যতা এটিকে উৎপাদনের জন্য প্রস্তুত করে।
এজেন্ট মেমরি প্ল্যাটফর্মগুলি একটি সংকীর্ণ কুলুঙ্গি পরিবেশন করে: দলগুলি রাষ্ট্রীয় কথোপকথনমূলক এজেন্ট তৈরি করে যাদের বাক্সের বাইরে সাময়িক যুক্তির প্রয়োজন এবং তাদের নিজস্ব পরিচালনার পরিবর্তে পরিচালিত পরিকাঠামোর জন্য অর্থ প্রদান করতে পছন্দ করে। এই দলগুলির জন্য, $249- $5,000+/মাস খরচ বিক্রেতা লক-ইন, সীমিত ক্যোয়ারী ক্ষমতা এবং অস্বচ্ছ পরিকাঠামোর খরচে কর্মক্ষম সুবিধা কিনে নেয়।
AI অ্যাপ্লিকেশন তৈরির বেশিরভাগ দলের জন্য, NebulaDB হল পরিষ্কার পছন্দ. এটি এআই-নেটিভ ডেটা পরিকাঠামোর সম্পূর্ণ ভিত্তি — ওপেন সোর্স, প্রোডাকশন-রেডি এবং বিনামূল্যে।


